资源介绍
视频数量:32个
总时长:2小时8分
课程介绍:
在AWS上用Amazon Comprehend做文本分析
想象一个场景:你手里堆着成千上万条用户评论、新闻文章、客服工单,靠人工一条条去读、去分类、去判断说话人的情绪,那得读到猴年马月?更何况很多文本里藏着人名、机构名、地点这些关键信息,光靠肉眼翻根本捡不完。
正因如此,AWS推出了一项专门用来"读"文本的服务——Amazon Comprehend。你把一段文字丢进去,它能自动告诉你这是什么语言写的、说话的人心情怎么样、里面提到了哪些人和事,甚至还能帮你提炼出整篇文章到底在聊什么话题。这门课要做的,就是带你把这件利器真正用起来。
讲师是Mark Nunnikhoven,AWS社区英雄,也是机器学习和人工智能领域的老手。他设计这门课的目标很明确:不需要你提前懂机器学习,也不要求有自然语言处理的经验,只要你对AWS云有最基本的了解,就能跟上节奏。两小时出头,三十二个视频,节奏紧凑但内容扎实。
一、先把Amazon Comprehend认识清楚
课程开头先带大家认识Amazon Comprehend到底是什么。它是一项基于机器学习的托管服务,和你可能用过的Amazon Lex、Amazon Transcribe有点像,都属于AWS里"让机器读懂人类语言"那一类工具,但Comprehend的专长是文本分析。
讲师会先演示一下管理控制台长什么样、怎么操作,让你有直观感受。随后讲清楚自然语言处理的基本概念——什么是NLP、常见的术语有哪些、服务在后端到底干了什么。最后还会专门聊一个关键概念:置信度分数。机器学习模型的判断不是百分之百确定的,置信度分数就是告诉你这个结果有多可信,理解了这个,才能真正用好这项服务。
二、三种最基础的分析能力
光听概念不够,得动手。课程的第二章带大家跑通几个最常用的功能。
第一个是语言检测。一段文本丢进去,Comprehend告诉你这是英文写的、中文写的,还是其他什么语言。做跨境业务、处理多语言内容的时候,这个功能特别实用。
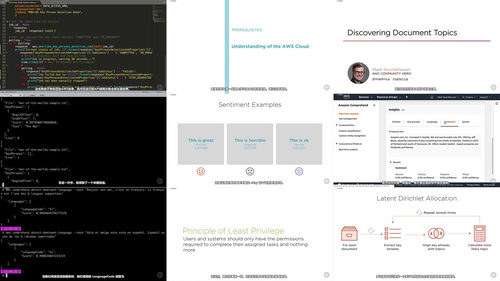
第二个是情感分析。文本里说话的人是什么态度?高兴的、不满的、还是喜忧参半?Comprehend能基于机器学习模型做出判断,比简单的关键词匹配准确得多。讲师会带着你跑一遍代码,看看真实输出长什么样。
第三个是语法分析。句子里的哪个词是名词、哪个是动词、哪个是形容词,Comprehend能逐一标注出来。这在很多文本处理流程里是基础步骤——你想把一段话拆解成结构化数据,语法分析绕不开。
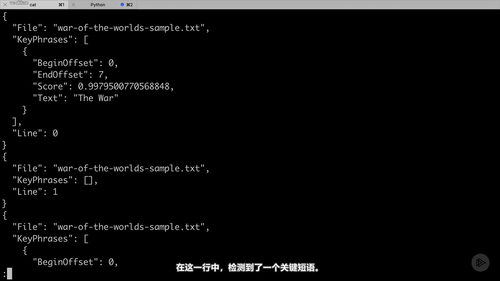
每项功能都配有演示和代码示例,课程资料里还提供了《世界大战》这类经典文本作为样本数据,跟着做就行。
三、进阶玩法:异步调用、实体识别、关键短语
基础功能满足不了复杂业务怎么办?课程第三章把难度拉上来。
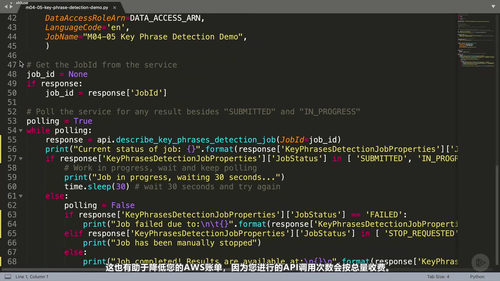
先讲异步API调用和任务机制。要分析的文本量很大时,同步调用会超时,这时候就要用异步任务的方式提交,让服务在后台慢慢跑完再把结果给你。讲师会教你配置IAM权限、提交任务、获取结果,处理真实业务数据时这套流程是必备技能。
接下来是实体检测。文本里的人名、公司名、地名、产品名,Comprehend能自动识别并提取出来。更厉害的是,它支持自定义实体识别——你可以上传一份自己的清单,告诉它在你特定业务场景里哪些词条值得关注,它就按你的规则去找。这一点在做行业垂直领域的文本分析时特别管用。
最后是关键短语检测。一大段文章里最核心的短语是什么?Comprehend能帮你提炼出来,在做摘要、搜索、推荐等场景里非常有用。
四、让机器帮你读懂一批文档在聊什么
到了第四章,课程进入主题建模的内容。假设你手头有一大批文档,想知道它们大致在聊哪些话题、每个话题下有哪些文档归类,Comprehend的主题建模可以帮你搞定。讲师用《福尔摩斯探案集》《战争与和平》做演示样本,让你看到实际操作效果。学完这一块,你就掌握了处理大规模文档归类的能力。
五、安全这条底线不能丢
最后一章专门讲文本分析中的安全和隐私风险。把文本数据传到云端分析,意味着数据离开了你的本地环境,涉及的安全防护、权限控制、隐私合规问题都得想清楚。这个章节不长,但讲的都是实实在在的注意事项——技术功能再强,数据安全这条线不能踩。
六、什么样的人适合学
如果你是AWS上的开发工程师,想在项目里集成文本分析能力但又不想从零搭建机器学习模型,这门课很合适。如果你是数据分析师,平时需要处理大量非结构化文本,也能从中学到一套实用的工具组合。另外,产品经理或解决方案架构师想了解Amazon Comprehend到底能做什么、怎么跟现有系统集成,同样值得来听一听。
整体看下来,两小时的内容安排得很紧凑,从概念到实战再到安全,一条线串到底。学完之后,你对Amazon Comprehend的核心功能会形成一个完整的认知框架,知道什么时候该用、怎么用、用的时候该注意什么。剩下的,就是找几个真实的场景去动手练了。