资源介绍
视频数量:49个
总时长:4小时2分
课程介绍:
大语言模型量化与压缩:理论核心精讲
你有没有过这样的经历——好不容易训练好一个几十亿参数的大模型,满心欢喜想部署到生产环境,结果一看显存需求直接傻眼。光是加载权重就要好几张高端显卡,推理延迟高得让人怀疑人生,推理成本更是烧钱如流水。这就是当前大语言模型落地过程中最现实的痛点:模型太大、太重、太慢、太贵。怎么在不大幅损失性能的前提下,把模型"瘦身"到能跑得动的程度?这门课程就是来解决这个问题的。
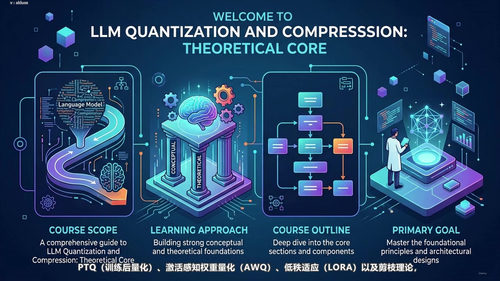
这门课程聚焦于大语言模型量化与压缩的理论核心,总共四小时左右,分为八个板块、四十九个视频,围绕六个反复出现的核心主题展开深入的剖析。这六个主题分别是:训练后量化(PTQ)、激活感知权重量化(AWQ)、低秩适应(LoRA)、剪枝理论、架构权衡,以及设计反模式。课程没有停留在表面告诉你"用这个方法可以压缩模型",而是把每个技术背后的数学基础、结构性假设和工程权衡彻底讲清楚,让你不仅知道怎么用,更知道为什么这样用、什么时候该用、什么时候不该用。
一、训练后量化(PTQ)的全面解析
训练后量化是整个课程的第一个重头戏,也是工业界用得最多的压缩手段。课程从战略治理的视角切入,讲解为什么在模型训练完毕之后再做量化是一个务实的选择——你不需要重新训练,也不依赖完整的训练数据集。这部分会讲到量化的基本数学原理:如何把浮点权重映射到低比特整数,映射过程中会产生哪些误差,这些误差又是如何在网络中传播和累积的。
接下来课程会拆解 PTQ 的内部运作机制,比如如何选择校准数据集、如何确定量化参数(缩放因子和零点)、如何处理异常值。课程还从多个理论维度反复审视 PTQ:第一节从治理角度谈整体策略,机器学习范式那章从偏差-方差的角度分析量化误差的统计影响,深度神经网络与梯度传播章节则探讨量化对梯度流动的干扰,自然语言处理章节讨论词嵌入在量化后的几何形变。每一章的切入角度都不同,但指向的是同一个技术的不同侧面,看完你会对 PTQ 有一个立体的认知。
二、激活感知权重量化(AWQ)的深度拆解
普通的量化方法往往一刀切,对所有权重采用相同的量化策略。但实际训练好的模型中,不同层的权重和不同通道的激活值重要性差异巨大。激活感知权重量化(AWQ)的核心思想就是:找出那些"特别敏感"的权重——也就是被大的激活值放大的权重——给它们保留更多精度,其余的权重则可以更激进地压缩。
课程专门用几个独立视频来拆解 AWQ 的实现细节,包括如何识别显著权重、如何设计保护策略、如何在量化精度和模型大小之间做平衡。从 Transformer 架构的视角看,AWQ 之所以有效,是因为注意力机制中的某些通道承载了远比其他通道更重要的语义信息。课程还会从强化学习与马尔可夫决策的框架来理解 AWQ 的决策过程——每保留一个高精度权重,本质上都是在做一次资源分配的决策。
三、低秩适应(LoRA)的进阶理解
LoRA 是当前最主流的参数高效微调方法,也是压缩工具箱里的一件利器。课程对 LoRA 的讲解不是浮于表面的"低秩分解"四个字,而是深入到数学层面:为什么权重更新矩阵可以被低秩近似?这个近似的理论保证是什么?在什么条件下低秩假设会失效?
课程会带你构建 LoRA 的完整概念模型:它定义了一个学习目标损失函数、一个特定的模型结构,以及一种基于梯度的优化策略。训练过程中,原始权重被冻结,只有低秩矩阵在更新。这种设计为什么能大幅减少可训练参数?为什么不会显著损失模型性能?课程从泛化能力、模型容量控制和训练效率三个维度给出了扎实的解释。生成模型那一章还会把 LoRA 放到扩散模型的语境下,看它如何让大规模生成模型变得可微调。
四、剪枝理论的系统讲解
剪枝和量化是两个完全不同的压缩思路。量化是让每个参数占用更少的比特,剪枝是直接砍掉一些不重要的参数或整个结构。课程对剪枝理论的覆盖非常系统,从核心原理讲到评估方法,从结构化剪枝与非结构化剪枝的区别,到剪枝后如何做微调恢复性能。
剪枝理论的底层逻辑其实和生物神经科学的"用进废退"有些相似——那些在训练过程中贡献较小的连接可以被安全移除,而不会对整体功能造成致命打击。课程用数字引擎的比喻来解释剪枝的运行机制:输入解析、状态转换、输出生成,每一个环节都可能存在冗余,而剪枝就是要把这些冗余识别出来并清理掉。可解释 AI 那一章还会从模型审计的角度,探讨如何评估剪枝后的模型是否仍然可靠、是否引入了新的偏差。
五、架构权衡的深度思考
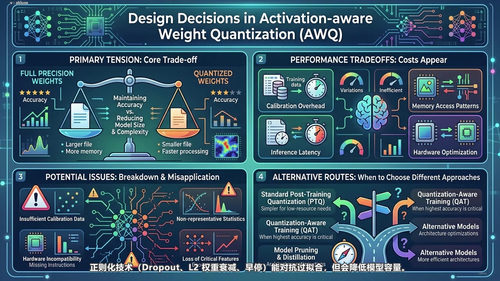
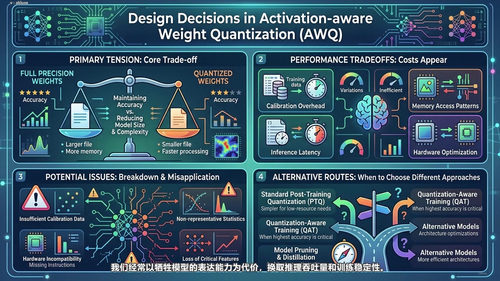
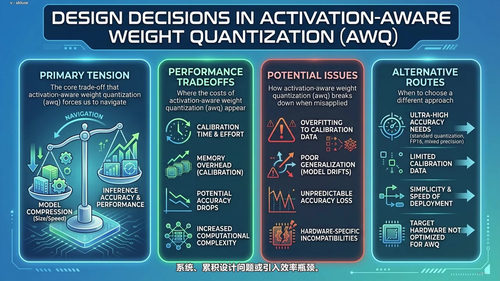
压缩技术从来不是免费的午餐。每一种方法都在性能、复杂度、资源消耗之间做交换。课程花了相当多的篇幅专门讨论架构权衡——这是这门课最值钱的部分之一。你会学到:在选择量化精度时,比特数每降低一位,模型大小和推理速度会怎样变化,精度又会损失多少;在做剪枝时,剪掉 20% 的参数和剪掉 50% 的参数,效果差距有多大;在用 LoRA 做微调时,秩的选择如何影响表达能力和过拟合风险。
课程反复强调一个核心观点:没有最好的压缩方案,只有最适合特定场景的方案。消费级显卡上跑的小模型和服务器上跑的大模型,压缩策略可能完全不同。课程从偏差-方差的角度分析每种选择的统计代价,从 Transformer 自注意力的角度讨论压缩对长程依赖建模能力的影响,从马尔可夫决策的角度看待资源受限环境下的多目标优化问题。
六、设计反模式的识别与规避
踩过坑的工程师都知道,理论上看似完美的方案,落到工程实践中往往会碰到各种意想不到的问题。课程专门有一部分讲设计反模式——那些看起来合理、但实际上会把你引向灾难的常见做法。比如,校准数据集和实际数据分布不匹配会导致量化误差激增;剪枝比例过高会让模型丧失关键能力;LoRA 的秩设置不当会让微调效果还不如全参数微调。
课程会从可解释 AI 和模型审计的视角,帮你建立一套识别反模式的思维框架:不仅要看到模型在跑,更要知道它为什么这样跑、出问题的时候该往哪里排查。这部分内容对实际工程项目特别有价值,因为它直接对应你在生产环境中可能遇到的真实故障。
适合谁来学:
这门课的目标受众非常明确:从事软硬件协同设计的工程师、负责 AI 平台架构设计的技术负责人、负责模型部署和运维的 SRE 工程师,以及任何想在大模型压缩方向深入下去的研究者和架构师。如果你是刚开始接触量化和压缩的新手,这门课可能会有些吃力,因为它假设你已经具备机器学习、深度学习和 Transformer 架构的基础知识。但反过来,如果你已经有一定的工程经验,想要从"会用"跨越到"懂原理",那这门课简直就是为你准备的。
学完这门课之后,你能够独立评估不同压缩方案的适用场景,能够根据硬件约束和性能要求设计合理的压缩策略,能够诊断和解决部署过程中遇到的精度退化问题,更重要的是,你会在面对一个具体压缩需求时,建立起一套系统性的思考框架,而不是凭感觉试错。这门课四小时左右就能看完,但内容密度很高,每一节都值得反复琢磨。