资源介绍
视频数量:27个
总时长:2小时53分
课程介绍:
将生成式AI应用于DevOps与运维实战
凌晨两点,手机突然响了,告警告诉你生产环境的某个服务挂了。你睡眼惺忪地爬起来,打开电脑,翻日志、看指标、查链路,试图弄清楚到底是哪里出了问题。这种场景对运维和DevOps工程师来说再熟悉不过了。
如果你身边有一个助手,能帮你快速搭建监控方案、自动生成告警规则、在你手忙脚乱的时候帮你分析日志和链路数据找到根因,甚至事故之后还能帮你整理复盘文档,那会是什么样的体验?这门课讲的就是这件事,把生成式AI变成你日常运维工作中的得力搭档。
一、课程开场与工具选择:
课程一开始,讲师会带你了解这门课要用到的AI工具。市面上可选的大模型不少,但并不是每个都适合写代码和做运维工作。这里会讲清楚不同工具的特点和使用场景,帮助你选择最适合自己的那一个。同时也会提醒你在使用AI时需要注意的风险,比如AI可能给出看起来正确但实际有问题的配置,这一点对运维工作来说尤其致命,因为一个错误的YAML文件可能直接拖垮生产环境。课程还会演示如何在本机运行大模型,对于不方便把代码传到外部服务的企业来说,这是一个很实用的技能。
二、AI在DevOps与CI/CD中的应用:
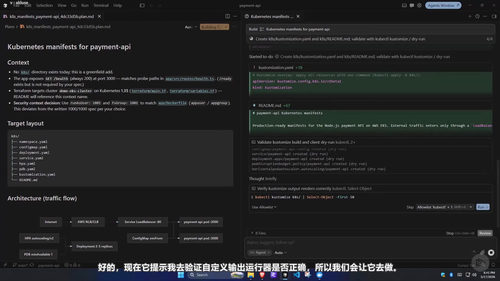
这一部分是课程的核心内容。讲师会带你从零开始,用AI生成Terraform代码来构建和验证AWS EKS基础设施。你会看到如何通过精心设计的提示词,让AI写出符合生产标准的Dockerfile,以及可以直接部署到生产环境的Kubernetes清单文件。接下来还会演示如何用AI搭建一套完整的Jenkins CI/CD流水线,覆盖从代码提交到部署到EKS集群的全过程。
更重要的是,课程不只讲怎么用AI写东西,还会讲怎么用AI来审计已有的CI/CD流水线和基础设施定义。讲师会以一个GitHub Actions流水线为例,现场演示AI如何发现配置中潜在的安全漏洞和最佳实践偏差。对于想提升代码质量和安全性的团队来说,这部分内容非常有价值。
三、AI辅助监控与故障响应:
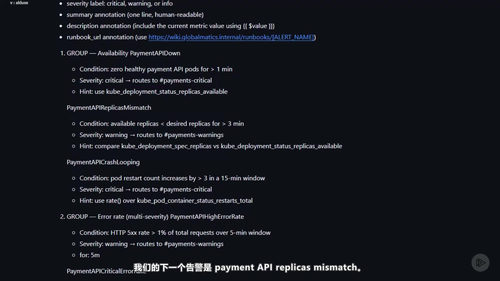
监控和故障响应是运维工作中最耗时也最紧张的部分。课程会用AI来搭建一套基于Prometheus和Grafana的全栈监控方案,包括用Helm进行部署、配置各种抓取规则、设置持久化存储等。然后会演示如何用AI生成ServiceMonitor配置、自动创建Grafana仪表盘,以及编写各种告警规则。
故障响应这一块会讲到如何使用AI进行根因分析,把日志、链路追踪和指标数据一起丢给AI,让它帮你快速定位问题,这比人工翻日志要快得多。事故结束之后,AI还可以帮你撰写事后总结、制定整改计划、总结经验教训,把这些繁琐但重要的文档工作自动化。
四、AI生成文档与运维知识管理:
运维团队的文档往往是最头疼的事情,代码更新了文档没跟上,时间一长就脱节了。课程会演示如何用AI根据Terraform文件、Dockerfile、Kubernetes清单等内容自动生成运维操作手册,涵盖扩缩容步骤、镜像更新流程、回滚操作、环境销毁与重建等关键操作。
讲师还会展示如何用AI生成发布说明、配置指南和回滚流程文档。更实用的是,课程会讲到如何利用AI检测并修复文档漂移问题,也就是代码已经变了但文档没跟着更新的情况。
五、AI优化基础设施成本与性能:
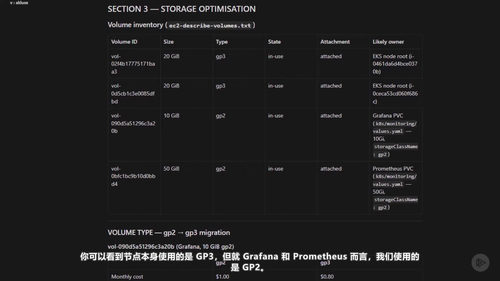
云账单每个月都让运维团队头疼,课程会演示如何用AI分析云成本报告并给出预算优化建议。还会讲到如何用AI进行流量建模、容量预测和弹性伸缩配置,让资源利用更合理,既不会在高峰期扛不住,也不会在低峰期浪费钱。
六、安全考量与人工监督:
最后一章专门讲安全。讲师会详细分析把AI用于DevOps工作可能带来的安全风险,比如AI生成的配置中可能泄露敏感信息、引入不安全的默认设置等。课程会强调人工监督的必要性,因为AI虽然强大,但它生成的基础设施变更最终还是需要人来把关。最后会讲到如何建立合规审计机制,确保AI辅助的DevOps流程满足企业安全和合规要求。
整个课程下来,你会建立起一套完整的AI辅助DevOps工作流,从基础设施搭建、应用部署、CI/CD流水线、监控告警、故障响应到文档管理和成本优化,每个环节都有AI的影子。但更重要的是,你会明白什么时候该信AI、什么时候必须自己把关,以及如何在效率和安全之间找到平衡点。