资源介绍
视频数量:48个
总时长:3小时40分
课程介绍:
深入理解人类反馈强化学习:AI对齐背后的方法论全景
你有没有想过,ChatGPT为什么能听懂你话里的弦外之音?为什么你让它别用那种语气,它就能立刻调整过来?这背后真正的功臣不是什么神秘的魔法,而是过去几年里AI领域最关键的一项技术——人类反馈强化学习,简称RLHF。这门课要做的,就是把这套技术的内核掰开揉碎,从数学原理到工程实践,一层一层讲给你听。
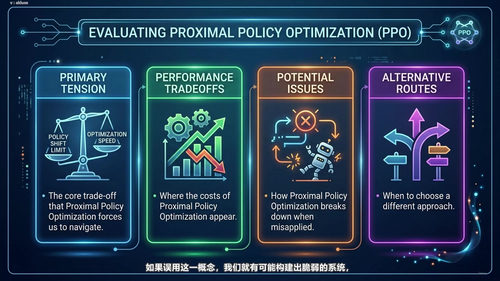
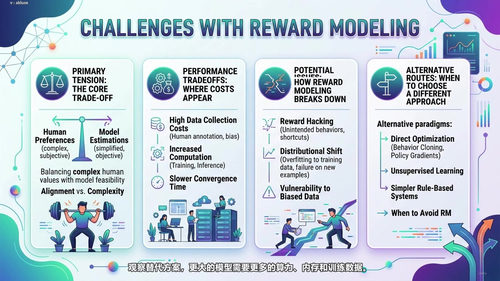
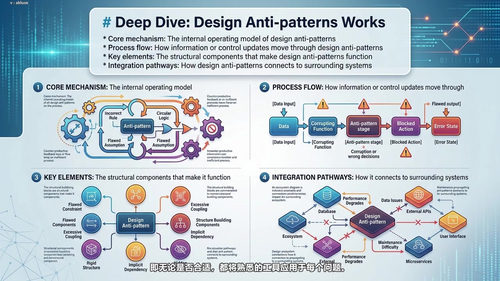
这门课一共48讲,总时长不到四小时,但信息密度相当高。它的组织方式有一个很特别的地方:围绕六个核心主题反复展开,分别是奖励建模、近端策略优化、直接偏好优化、对齐漂移、架构权衡以及设计反模式。每一个主题都会从不同的机器学习语境里被重新审视,所以学完之后你不是只记住了一两个概念,而是能从多个角度看清楚这些概念之间的关联。
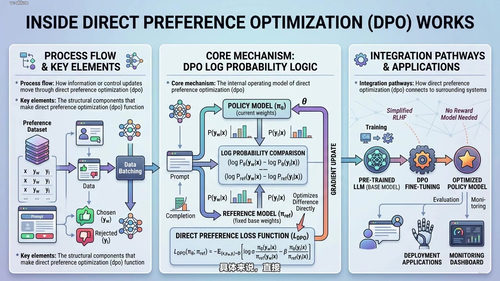
先说第一章的基础铺垫。课程从奖励建模讲起,这是整个RLHF体系的根基。简单来说,模型要先学会给人类的偏好打分,然后才能根据这个分数调整自己的行为。接着是PPO,也就是近端策略优化,它是目前工业界最主流的强化学习算法,搞清楚它怎么收敛、怎么更新参数,对理解大模型训练至关重要。然后是DPO——直接偏好优化,这是PPO之后兴起的更简洁的替代方案,跳过了显式奖励建模的步骤,直接用偏好数据训练策略。最后,对齐漂移、架构权衡、设计反模式这三个话题会帮你建立警觉性:什么时候模型可能偏离人类意图?做架构决策时哪些坑必须避开?哪些写法是公认的反面教材?这些内容对做工程的人来说尤其受用。
进入第二章,话题被放进了机器学习的整体语境里,引入偏差-方差分解的视角。同样的六个主题,在这一章里会跟泛化能力、模型容量、训练效率这些经典概念碰撞出新的理解。比如奖励建模在偏差-方差框架下意味着什么,PPO的策略更新为什么容易在高方差训练中崩溃,DPO在数据稀疏时表现又会怎样。通过这种反复交叉的训练,你能形成一种立体化的认知,而不是孤立地记住几个名词。
第三章进入深度神经网络和梯度传播的层面。神经网络为什么会梯度消失?奖励信号在多层网络中是如何回传的?PPO的截断目标函数在反向传播中具体扮演什么角色?这一章会把前面讲到的概念翻译成梯度、张量、链式法则的语言,让你能真正写出代码来验证这些想法。
第四章和第五章是很多人最关心的部分。自然语言处理里的嵌入几何、Transformer的自注意力机制,这些都是大模型的骨架。课程会展示奖励建模如何作用于文本嵌入空间,PPO和DPO在生成式任务中的优化路径有何不同,以及自注意力权重与人类偏好之间是否存在某种映射关系。理解了这些,你再看那些大模型的技术报告,就不会觉得是在看天书了。
第六章回到强化学习的本源——马尔可夫决策过程。这一章把PPO和DPO放回到状态、动作、奖励、转移概率的框架里重新分析,讲清楚策略迭代和值迭代的区别,以及在长序列决策中这些方法各自的适用边界。
第七章讨论可解释AI、模型审计和伦理治理。这部分内容在前面的技术基础上多了一层人文视角:当模型不断根据人类反馈调整自己时,如何确保它不会走向我们不想要的方向?如何检测对齐漂移?当架构决策涉及伦理考量时,哪些权衡是必须摆在台面上的?
最后一章把视角拓展到生成式模型,包括GAN和潜在扩散系统。奖励信号在扩散过程中如何注入?DPO是否适用于图像生成?这些前沿问题在这章里都有涉及,也为整个课程画上了一个面向未来的句号。
总的来说,这门课适合那些已经掌握了机器学习和深度学习基础,想进一步搞清楚大模型对齐技术全貌的人。不需要你是RLHF领域的资深从业者,但至少要了解神经网络的基本概念、Transformer的运作方式。如果你是AI工程师、研究方向是大模型训练、或者你在技术管理岗位上需要理解对齐技术的取舍逻辑,这门课都能给你不少干货。学完之后,面对任何关于RLHF的问题,你都能从多个层面给出有依据的回答,而不是停留在概念名词的层面。