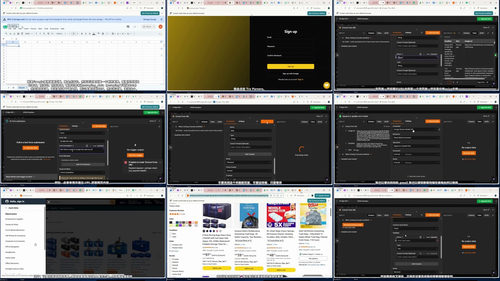
资源介绍
视频数量:14个
总时长:1小时11分
课程介绍:
用AI抓取网页数据:零代码自动化采集实战
你有没有遇到过这种场景:做一个电商项目,想要批量获取某网站上商品的标题、价格和图片链接;或者做金融分析,需要定期抓取财经新闻的头条和发布时间;又或者你只是一个市场运营,想把竞品的公开信息整理到表格里方便后续分析。按照传统做法,你得去啃Python的requests库、BeautifulSoup、Selenium这些爬虫工具,还得处理各种反爬机制、编码问题、数据清洗。但如果就是不想碰代码呢?如果想用更聪明的方式完成这件事呢?
这门课程就是为这种需求而生的。整门课不会教你写一行爬虫代码,而是带你用AI和自动化工具,把网页数据采集这件事变得像搭积木一样简单。
一、课程讲什么
课程会带你从零搭建一个不需要编程的AI抓取系统,走完一个完整的网页数据采集工作流。
首先是基础设置部分。课程会带你认识一个核心工具——n8n。这是一个开源的自动化工作流平台,可以把不同的服务和数据源串联起来。你不用去了解它的底层架构,跟着步骤一步步配置好环境就行。设置完毕之后,课程会介绍另一个关键角色:Parsera,一个基于AI的网页抓取工具。它最大的特点是不需要你手动分析网页的HTML结构,AI会自动识别页面内容并提取你想要的数据。
接下来是核心实战环节。课程用多个真实场景演示如何从不同类型的网站提取数据。
第一个场景是商品数据采集。你会学到如何从一个电商网站批量提取商品信息,包括商品名称、价格、图片等。课程先演示批量抓取的流程,再演示单个商品页面的深度提取,让你理解两种不同的采集模式分别适合什么情况。
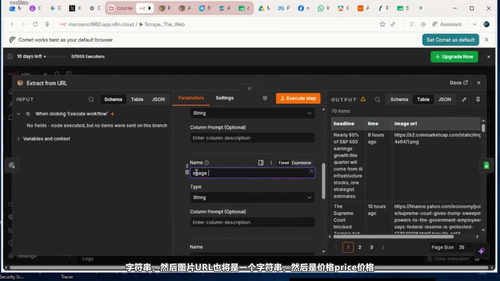
第二个场景是金融数据采集。课程以雅虎财经的新闻页面为例,演示如何抓取财经新闻的标题、发布时间和图片URL。这种结构相对规整的列表页面是很好的入门练习对象。
第三个场景是标题类内容抓取。课程会展示如何从新闻网站或者内容平台上批量抓取文章标题,建立起自己的内容监控数据库。
数据抓到之后,还有一个关键环节:存储和管理。课程用两节内容详细讲解如何把抓取到的数据自动写入Google表格。你会学到怎么创建对应的列结构、怎么把AI节点输出的数据映射到表格的不同列中,以及怎么配置凭据让工作流能正常访问你的Google账户。
最后一部分是反复测试和优化。课程安排了三次完整的测试环节,每完成一个场景的搭建,都会跟着讲师一起跑一遍流程,检查数据是否正确提取、是否正确入库。万一出了问题,也方便你回过头定位是哪个环节的配置出了岔子。
二、这套方法解决了什么问题
传统网页爬虫有几个让人头疼的地方。第一,网页结构经常变,今天写的解析代码明天网站一改版就全失效了,维护成本很高。第二,很多网站有反爬机制,要处理请求头、Cookie、代理IP这一堆麻烦事。第三,对不写代码的人来说,门槛实在太高,光是装好Python环境、处理各种报错就够劝退一整批人了。
用AI辅助抓取,最大的好处就是AI能"看懂"网页内容,而不是依赖固定的HTML标签。就算网站的布局变了,AI也能根据语义理解把正确的信息提取出来。再配合n8n这种可视化工具,整个流程不用写代码,拖拖拽拽就能把工作流拼出来。
三、适合谁来学
课程明确说了三类人:第一类是AI工程师和从业者,想把AI能力落地到具体业务场景;第二类是想快速构建实际应用的人,可能是个体创业者、产品经理或者市场分析人员;第三类是不想写代码但又想完成自动化任务的人,或者更准确地说,是想用低代码方式解决问题的人。
如果你是做电商运营,需要监控竞品价格;如果你做内容运营,需要抓取新闻素材;如果你做投资研究,需要结构化整理财经信息;又或者你单纯对AI自动化感兴趣,想知道它现在能落地做什么——这门课都能给你一个清晰的答案。
四、学完之后你能做什么
课程提供了完整的工作流配置文件,以JSON格式给出。学完之后你可以直接把这个文件导入n8n,复现课程里的所有案例。更重要的是,你掌握了这套思路之后,可以把它迁移到任何你想采集的网站上。换句话说,课程交给你的不只是一套固定的操作步骤,而是一套可以复用的工具组合和工作流搭建逻辑。
一个多小时的时间,十四个章节,不写一行代码就能搭起一个AI驱动的网页数据采集系统。这门课的时间成本不高,尤其对于那些曾经被传统爬虫劝退、但又确实有数据采集需求的人来说,它提供了一个全新的解题思路。抓数据这件事,本来就不该那么难。