资源介绍
视频数量:11个
总时长:2小时36分
课程介绍:
用纯C语言从零搭建迷你大模型推理引擎
你有没有过这样的时刻——打开ChatGPT问了个问题,得到一个精彩的回答,然后盯着屏幕想:这玩意儿到底是怎么算出来的?答案藏在几百亿个浮点数里,藏在矩阵乘法、注意力机制、量化编码这些听起来很吓人但其实并不神秘的底层操作里。如果你也想把这层黑箱掀开,亲手用最朴素的C语言把一个大语言模型的推理过程从头到尾写一遍,这门课就是为你准备的。
这门课做的事情很明确:从零开始,用标准C99写一个轻量级的大语言模型推理引擎,最终能加载官方TinyLlama 1.1B模型权重,跑起一个完全本地化、不依赖Python也不依赖PyTorch的交互式聊天程序。整个项目代码量可控,结构清晰,每一行都看得懂,每一个模块都讲透。下面把课程的脉络捋一遍,你大概就知道这两小时三十六分钟里你会经历什么。
一、项目概览与环境搭建
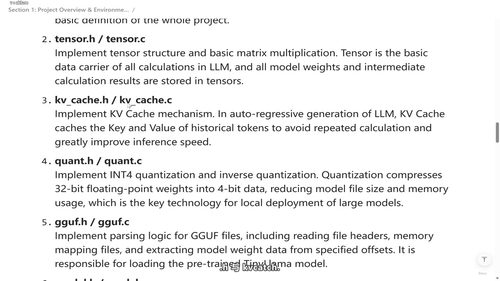
开篇第一章先帮你建立全局视野。老师会介绍整个项目的目标——我们要构建什么、能做什么、适合什么场景,同时把后续会用到的基础概念铺垫清楚:什么是大语言模型、TinyLlama是什么、GGUF这种模型存储格式为什么成了业界主流。架构层面的文件划分也会一并交代,让你心里有一张清晰的地图。接着是跨平台的环境配置,Linux、macOS、Windows、WSL2都覆盖到,Makefile怎么写、测试用例怎么跑,这一套搞完,你就有了一个可以马上开工的编译环境。
二、核心基础:自定义张量系统
推理引擎的底座是什么?是张量。所有矩阵运算、权重加载、激活计算,本质上都是在操作多维数组。这一章会带你搭建一个自定义的Tensor数据结构,支持常见的创建、释放、形状管理、内存分配逻辑。没有花哨的第三方库,就是最朴素的malloc和free,但你会理解清楚一个工程级项目里的内存管理应该怎么设计。这一块是后面所有章节的地基,值得花时间把代码跟着敲一遍。
三、KV缓存的实现
推理速度是大语言模型落地的关键瓶颈之一,而KV缓存是推理加速的核心技术之一。每一轮生成token时,模型都需要重新计算历史token的键和值,如果没有缓存,参数量越大、序列越长,计算量就越恐怖。KV缓存的思路很简单——把已经算过的K和V存下来,下次直接复用。这一章会手把手教你实现一个完整的KV缓存模块,理解它的内存布局、动态扩展策略,以及在自回归生成过程中如何高效地读写。搞懂这块,你对"推理加速"这件事的理解会上一个大台阶。
四、INT4量化与模型压缩
一个1.1B的模型如果用FP32存储,体积大概是4GB以上,普通笔记本跑起来都费劲。量化的目的就是用更少的比特表示权重,同时尽量保住模型精度。INT4量化就是把每个权重从32位浮点压缩到4位整数,模型体积直接缩小到原来的八分之一。这一章会讲清楚量化的数学原理、缩放因子的计算、反量化时的恢复策略。你会学到如何在推理时高效地把压缩权重还原成计算可用的浮点数,同时理解为什么量化是本地部署大模型的必备技术。
五、GGUF文件解析器
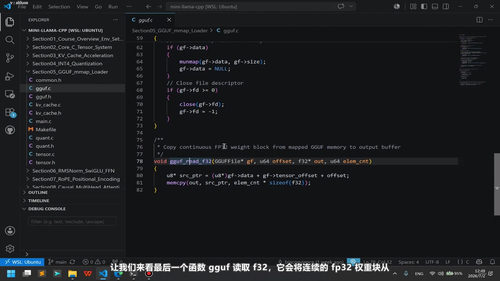
GGUF是当前大模型分发的事实标准格式,由llama.cpp生态推出,里面定义了模型的元信息、tokenizer配置、张量名称与数据布局。这一章你会写一个完整的GGUF解析器,学会读取魔数、校验版本、遍历张量表、把TinyLlama的真实权重加载进内存。读到这一章的时候,你会有一种特别爽的感觉——你写的代码真的在和工业级的模型文件打交道,不是什么toy demo。理解GGUF格式还有一个隐性收益:以后你想部署任何兼容llama.cpp的模型,都会心里有底。
六、LLaMA核心层:RMSNorm与SwiGLU
LLaMA架构的transformer块里有两个很关键的组件:RMSNorm归一化和SwiGLU前馈网络。RMSNorm比传统的LayerNorm更简洁,计算量更小,效果却不差;SwiGLU是一种带门控机制的前馈结构,比单纯的ReLU表现更好。这一章会把这两个组件的数学原理讲透,再用纯C实现出来。你会发现,看似神秘的"前沿架构"拆开看,其实就是几次乘加、几个sigmoid,没有什么看不懂的。
七、RoPE旋转位置编码
Transformer本身不感知序列顺序,必须靠位置编码告诉模型"这个词在第几个位置"。RoPE(Rotary Position Embedding)是LLaMA系列采用的位置编码方案,它通过旋转变换把位置信息编织进Q和K向量里,好处是天然支持长度外推。这一章会带你推导旋转矩阵的构造,理解为什么RoPE在数学上优雅、实现上高效。跟着代码写一遍,你就掌握了现代大模型位置编码的主流方案。
八、带KV缓存的因果多头注意力
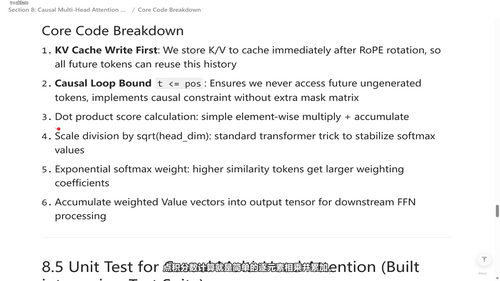
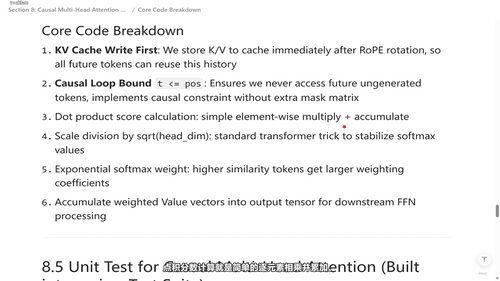
这是整个推理引擎的心脏。因果注意力保证了生成时只能看到过去的token,多头机制让模型在不同子空间里关注不同的语义关系,而KV缓存的集成则让重复计算彻底消失。这一章会把前面学到的KV缓存接进来,实现一个完整的、可以在自回归生成中复用的注意力模块。读到这里,你大概会真正理解"self-attention"这四个字在底层到底干了什么。
九、分词器与自回归生成
模型不能直接吃文字,必须先把输入文本切成token,再映射成整数。这一章会讲清楚BPE分词器的基本原理,实现一个能编码文本、也能把生成的token还原成可读文字的分词模块。然后进入自回归生成的循环——每次取上一步的输出作为下一步的输入,逐token采样,直到遇到结束符或者达到最大长度。采样策略、温度参数控制生成多样性这些细节也都会讲到。
十、最终项目:交互式聊天演示
所有模块拼起来的时候了。这一章会把前面写的张量系统、KV缓存、量化、GGUF解析、transformer各层、分词器、自回归生成全部整合成一个单一的可执行文件。你会得到一个完全本地、可离线运行、用纯C构建的微型Llama推理引擎,对着它说话就能得到回应。这个项目既是你学完课程的证明,也是一个能写进简历的硬核作品。
十一、高级优化路线图
基础版本跑起来之后,速度是偏慢的,毕竟它优先考虑的是可读性而不是性能。这一章是加餐,老师会带你看看工业级框架做了哪些优化:朴素矩阵乘法如何分块分块再分块、内存如何零拷贝复用、SIMD向量化怎么用、量化和矩阵运算能不能融合、top-k和top-p采样、流式token生成、多线程并行推理等等。这一章不会让你逐个实现这些优化,但会给你一张清晰的路线图,让你知道如果想把这个学生项目升级成生产级运行时,应该往哪些方向努力。
适合谁来学?如果你会写基本的C语言,对大语言模型的内部机制充满好奇,想搞清楚"模型推理"到底在做什么,而不是只会调用API,这门课就很合适。不需要你有深度学习背景,也不需要你装Python环境,有一台能写C的电脑就够了。学完以后,你对transformer架构的理解会从概念层面下沉到代码层面,下次再看到任何关于LLM性能优化的讨论,你都能接得上话。