资源介绍
视频数量:48个
总时长:5小时39分
课程介绍:
Databricks上下文工程认证备考课
你花了好几个小时调提示词,模型输出还是不尽如人意。换更强的模型,加更长的指令,结果反而更糟。这不是你写的提示不够好,而是你没有管理好"上下文"这件更大的事。
过去两年,提示工程是AI圈的热门词。但Anthropic早已明确指出,真正决定智能体能否在生产环境稳定运行的,是上下文工程——在大语言模型推理过程中,对进入模型输入的全部内容进行策展和维护的策略。系统消息、检索到的文档、历史对话、工具描述、记忆片段,所有这些共同构成模型的"工作记忆",如何编排它们,才是AI工程师真正的核心技能。
这门课围绕这一全新的技术体系展开,同时对接Databricks平台认证考试,帮助你系统掌握从概念到落地的完整路径。课程共48个视频,总时长约5小时39分钟,分成八个章节,由浅入深拆解上下文工程的每个关键环节。理论讲解与实操工作坊交替推进,工作坊既能在Databricks平台上跑,也能在本地VSCode里完成。
一、环境搭建与基础准备
动手构建之前,得先把基础环境准备好。这一章带你注册Databricks免费版工作区,把课程配套的GitHub仓库接入平台,配好Claude API密钥并部署服务端点。同时演示如何用本地VSCode开发、如何创建PDF存储卷,以及如何从CSV文件生成Delta表。这些看似琐碎的准备工作,是后续所有实验顺利跑起来的前提。
二、上下文工程的核心概念
第一章是整门课的理论基石。你会学到上下文工程与提示工程的本质区别——前者关心完整的令牌预算,后者只关心你写的那几句话。课程介绍Databricks工具栈中的三个核心组件:Unity Catalog负责统一的数据与AI治理,MLflow用于追踪、记录和评估生成式AI应用,Lakebase则是完全托管的Postgres OLTP数据库,与Lakehouse深度集成。本章还会探讨上下文为什么会失效,以及如何用动态工具选择等策略修复问题。
三、系统提示与指令设计
提示词到底怎么写才有效?这一章从Genie空间入手,讲解如何把业务需求转化为清晰的系统指令。课程涵盖提示工程的基本原则、Few-shot示例的选择策略,以及令牌数量与响应质量之间的权衡关系。
四、知识检索与Genie配置
RAG是当前最主流的上下文补充方式。这一章详细讲解其工作流程:从非结构化数据管道开始,到文档分块策略,再到向量搜索的完整链路。你会学到如何在Databricks上构建RAG流水线,使用ai_parse_document等函数处理PDF文档,以及如何对向量搜索和Unity Catalog元数据进行诊断调优。Genie空间的策展方法也是本章重点。
五、记忆架构设计
智能体记不住对话,就没法完成真正的多轮任务。这一章聚焦Lakebase与MLflow在记忆系统中的应用,讲解短期记忆与长期记忆的区别、Agent状态的存储机制,以及如何确保记忆检索的质量和上下文的一致性。
六、工具设计与MCP协议
智能体要跟外部世界打交道,必须有趁手的工具。这一章介绍Databricks上智能体工具的创建方法,深入讲解模型上下文协议(MCP)的原理和应用场景,包括如何连接GitHub这类外部MCP服务、如何通过渐进式信息披露优化工具调用、如何对上下文进行剪枝减少噪音,以及分层MCP的设计思路。
七、上下文压缩与精简
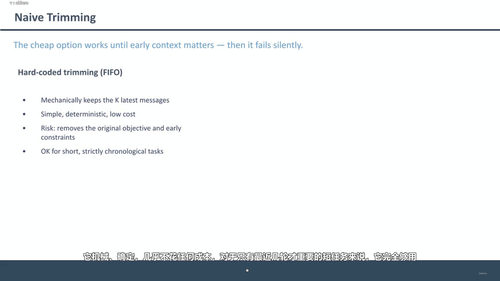
对话越来越长,上下文窗口迟早会爆掉。这一章专门讲解压缩技术,参考Claude与OpenAI的官方方案,通过实操工作坊亲手实现一个压缩机制,理解它和简单截断的本质区别。
八、多智能体与长时任务设计
最后一章进入更前沿的领域:多智能体协作。课程分析多智能体系统的常见失败模式,介绍Databricks的Supervisor Agent架构,以及Anthropic在多智能体研究系统上的实践经验。
这门课适合三类人:一是准备Databricks认证考试的工程师,二是想把AI智能体从Demo推向生产环境的开发者,三是想系统补齐上下文工程知识体系的技术从业者。不需要你是Databricks老手,只要有大语言模型的基本认知,跟随课程一步步操作,就能建立起完整的实战能力。学完之后,你会对"如何让AI在正确的时刻拿到正确的信息"这件事,拥有一个清晰且可落地的认知框架。