资源介绍
视频数量:103个
总时长:8小时18分
课程介绍:
Databricks湖仓平台实战手册:从运维到治理再到防御
周一早上八点半,Priya还没来得及把咖啡端稳,CFO的邮件就弹了出来——上周五的销售数据什么时候能出来?她打开团队搭建的仪表板,数字还是上周四的。再点开JupyterHub上的调度面板,一个Airflow任务卡在"重试"状态已经超过十个小时。再翻一遍HDInsight集群的日志,空值报错从凌晨三点就没断过。这就是Priya过去十八个月的日常:五种工具、四个交接点、数据每周掉一次链子,而她团队四成的工作时间都耗在救火上,根本没空做新东西。
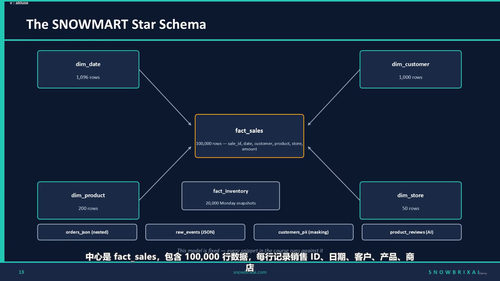
如果你也在类似的处境里——手里堆着Hive、Airflow、ADF、Jupyter的混合栈,每天被数据延迟、口径不一致、权限失控和月底爆账单追着跑——那么这门课就是为你准备的。它叫《Databricks湖仓平台实战手册》,八个半小时,一百零三个视频,全部围绕一件事:怎么把一个真实的企业数据平台从一团乱麻变成稳定运转、可治理、能扛住安全审计的湖仓架构。整个课程用一条贯穿始终的主线串起来——SNOWMART,一个虚构的零售企业,有网店、五十家实体店和合作渠道,五套后台系统。Priya就是你的角色,你跟着她从零开始,把这个平台重建一遍。
一、平台地基与数据底座
课程一开始会用一张图把整个湖仓的全貌摊在你面前:什么是工作区、什么是计算资源、集群、SQL仓库和无服务器计算各自适合什么场景。接着会把Azure上的实际部署拆给你看——Entra ID怎么接、落地区怎么规划、网段怎么划。这些不是抽象的概念,而是Priya第一天就要在Azure门户里点出来的配置。
地基讲完就进入Delta Lake。Delta不是什么神秘的黑盒子,课程会把ACID事务、时间旅行、版本回滚、删除向量、UniForm这些核心机制一条一条拆开讲。最有意思的是删除向量和UniForm——前者解决了传统Hive表删除数据要重写文件的痛点,后者让你的Delta表能被Iceberg客户端直接读取,意味着你不会被某个表格式锁死。这一块讲完后,你会清楚地知道文件为什么会丢、写入为什么会重复、模式为什么会漂移。
二、数据建模与工程实现
接下来是三层流水线,也就是业界常说的青铜、白银、黄金。课程不会只讲概念,而是告诉你每一层的职责边界——青铜层要求"全量摄入、零转换",白银层做清洗、去重和类型收敛,黄金层产出可直接喂给业务分析师的预聚合结果。更难得的是,它专门用了一节课讲什么时候可以打破这套规则,以及如何安全地重建一个被污染的层级。
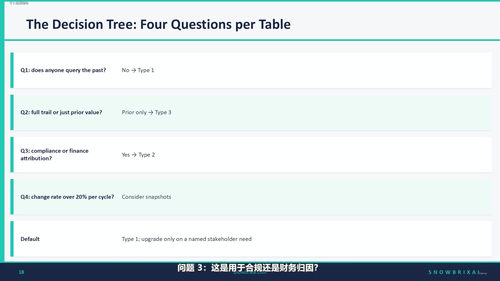
SCD(缓慢变化维)这块是数据仓库的经典难题。课程会演示Type 1覆盖写、Type 2用MERGE保留历史,以及在数据量上来之后怎么处理性能瓶颈和迟到维度。每一讲都附带一个"架构师视角"的小节,告诉你面对一张具体的业务表应该选哪种策略。
PySpark是数据工程师吃饭的家伙。课程从DataFrame的选择、过滤、列表达式这些基础讲起,一直延伸到窗口函数、UDF和Pandas UDF的性能取舍、嵌套JSON的拆解,最后还会教你写能真正抓到Bug的单元测试。每一节都聚焦于一个工程师最容易踩坑的地方——比如什么时候用UDF是合理的,什么时候Spark原生函数能甩UDF几条街。
三、数据摄入与流式处理
摄入环节你会学到Lakeflow Connect托管连接器、Auto Loader自动加载器,以及COPY INTO这三种主流方案各自的适用场景。Auto Loader那几节特别扎实——检查点怎么做、回填怎么追、模式推断和演进怎么处理、被抢救的数据列(rescued data column)到底有什么妙用。最后还会用一个真实的"重复摄入事故"复盘案例,让你看到生产里那些离奇Bug是怎么发生的。
流式处理部分从心理模型讲起:微批处理和触发器的本质区别、水位线怎么配、迟到数据怎么消化、有状态操作(聚合、去重、流连接)的存储代价在哪里。最后落在Exactly-Once的工程实现上——检查点、幂等写入、foreachBatch这三件套怎么配合。这部分讲完,你对Spark结构化流处理就不再是"知道有这个东西",而是能在生产环境里实际部署和调优。
Lakeflow声明式管道是Databricks近两年主推的新范式。课程会用对比的方式讲清楚它和命令式管道的根本差异——你不再是写一步步怎么做,而是声明你想要什么状态,平台帮你自动维护。然后带你搭第一条管道、用Expectations把数据质量写进代码里、讨论什么时候该用声明式、什么时候还是得回到底层自己写。
四、治理、安全与分析层
Unity Catalog是这门课的重头戏。三级命名空间、元存储设计、授权模型、血缘追踪、认证数据集,这些基础概念讲完之后,会进入属性级访问控制(ABAC)、行过滤器和列脱敏——这是企业级治理真正落地的地方。课程会给你一个完整的治理推广方案,怎么一步步铺开才能让业务团队愿意配合,而不是变成一个被绕过的空架子。
SQL仓库、AI BI仪表板和Genie自然语言分析组成了一个完整的自助分析链路。你会学到仓库怎么选型、查询历史怎么用、AI仪表板怎么搭建和发布、Genie怎么让业务人员用自然语言问数据。最后还会讲语义层信任和认证指标,以及怎么避免那个经典的"失控仪表板"成本事故。
五、性能优化与生产运维
Delta的优化分两讲。第一讲讲Liquid Clustering——这个取代传统分区的智能聚簇方案,让你不再靠猜来设计分区。第二讲深入到Photon引擎、自适应查询执行(AQE)、数据倾斜诊断和查询剖析。最后用一个真实案例收尾:一个应该四分钟跑完却跑了四小时的查询,到底卡在哪里,怎么从查询剖析图里找到元凶。
生产作业和Workflows部分讲的是从Notebook到生产作业的心态转变。你会学到任务依赖、作业集群、参数化、重试和告警的配置,以及扇出、条件分支和修复运行这些编排模式。最后还会对比Databricks Jobs和外部编排器(Airflow、ADF)的选型决策。
CI/CD和企业级测试是数据工程师进阶的必修课。Databricks Asset Bundles、Terraform、测试金字塔——这些词你在生产环境里绕不开。课程会演示怎么把整个平台的部署写成代码,怎么搭起从单元测试到集成测试到端到端测试的三层防线。
六、可观测性、成本与安全
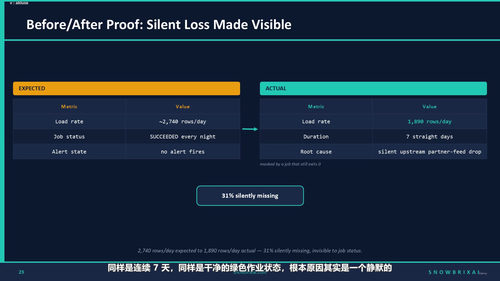
可观测性部分用系统表作为切入——这个被称为"平台的飞行记录仪"的数据源,能告诉你集群什么时候启的、查询什么时候跑的、数据什么时候被读的。Lakehouse Monitoring讲的是如何配置数据漂移和质量剖面。课程最后会带你搭一个完整的可观测性仪表板,并教你设计真正有用的告警信号——不是那种半夜把人叫醒但其实没事的噪声告警。
成本优化和FinOps取证是这门课最接地气的部分。课程会把Databricks账单拆给你看——DBU、SKU、云资源各自占了多少钱。然后用系统表做成本溯源,列出七种最常见的反模式,最后教你打标签、设预算、做部门分摊。收尾的项目是把SNOWMART的账单砍掉四成,这一讲看完整个人都会清醒不少。
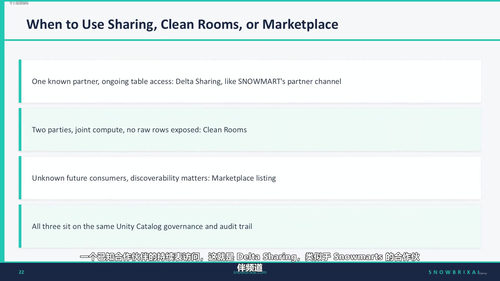
安全章节从密钥、服务主体和身份讲起,到私有链路、IP访问列表的网络隔离,再到Delta Sharing把数据作为产品分享给外部伙伴,以及Clean Rooms和市场。最后还会带你看一次架构师视角的安全审查——你在企业里推任何一个方案,几乎都要过这一关。
七、AI与机器学习落地
Mosaic AI部分讲的是数据工程师真正需要懂的AI能力,而不是机器学习科学家那套东西。向量搜索怎么在Delta表上建、模型服务端点怎么部署和查询、RAG管道怎么在SNOWMART的评论数据上搭起来、Agent和Genie模式怎么用。MLflow那一块从实验追踪讲到模型注册表和Unity Catalog中的模型管理,再到批量评分和实时部署的对比,最后是MLOps运维和再训练闭环。
八、架构师视角与终局项目
课程的压轴部分叫"架构师视角"。你不会学到孤零零的知识点,而是学会一套决策框架——从业务负载反推架构选择。十种生产环境里会失败的反模式被集中展示,Azure上的Databricks部署架构完整呈现,应聘面试里怎么捍卫自己的设计、认证考试的常见陷阱,都讲到了。
最后是SNOWMART的终局项目,分四个阶段:摄入和青铜到黄金、治理质量可观测性、编排和CI/CD、分析AI和成本护栏。每个阶段都附带代码模板和练习文件。你做完这个项目,手里就多了一个可以直接放进作品集的完整企业平台案例。
这门课最适合的是已经在做数据工程、但被Databricks生态的各种新概念弄得头晕的工程师——你知道自己会写Spark,但不确定生产里哪些坑是必须避开的。也适合正在准备Databricks数据工程师认证的人,课程里那个"考试陷阱"章节就是为这个准备的。如果你是技术负责人,想推动团队从老的Hadoop栈迁移到湖仓架构,那么从平台地图到Azure部署到成本治理到安全审计的完整链路,刚好就是你要说服CFO的那份方案。学完之后你能拿到的不是一份零散的知识清单,而是搭建一个能稳定运转、可被审计、成本可控的企业数据平台的全部底气。