资源介绍
视频数量:101个
总时长:3小时52分
课程介绍:
Databricks生成式AI工程师助理认证备考课
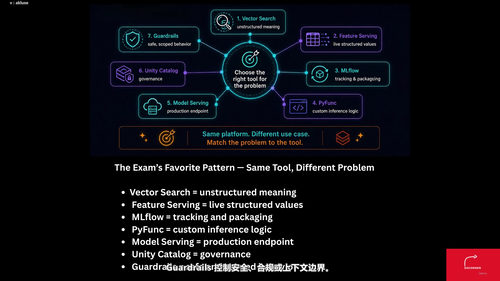
你刚接到一个任务:公司里有一堆产品手册和操作流程堆在云存储里,老板想搭一个内部知识问答助手,让员工直接问就能得到准确答案。你打开Databricks的文档和课程目录,发现RAG、向量搜索、Unity Catalog、模型服务、MLflow、代理、评估……一堆名词扑面而来。到底该先做文档切片还是先算嵌入?检索到了相关段落但排名不对该怎么办?模型回答得不错但格式总是乱,怎么调?微调后的模型怎么部署上线?这门课,就是帮你建立"面对真实问题知道怎么拆解、怎么选工具、怎么落地"的工程判断力。
一、课程理念:不是背概念,而是练判断
很多备考资料的做法是给你一堆定义和术语表,然后让你去死记硬背。但生成式AI工程师认证要考的不是你能不能背出"什么是RAG",而是你能不能在具体的业务场景里判断出该用RAG还是该微调,该用向量搜索还是该用特征存储,该选哪个模型、用什么服务方式、怎么管理访问权限和评估质量。这门课的设计者显然深谙此道:课程主体是100个独立场景题,每一道都从一个真实的工程困境出发,要求你读懂问题背后的关键线索,再把问题映射到正确的Databricks概念和工具上。学会这种"读场景、拆问题、选方案"的思维方式,比记住一百个术语都管用。
二、100个真实场景,覆盖完整工程链路
课程的核心就是这100道场景题,每个场景用两分钟左右的短视频呈现,短小精悍,直接切入问题。这些场景不是随机堆砌的,而是按照生成式AI工程的完整链路系统编排,从数据准备到上线运维、从功能设计到安全治理,几乎所有常见工程决策点都被覆盖到了。
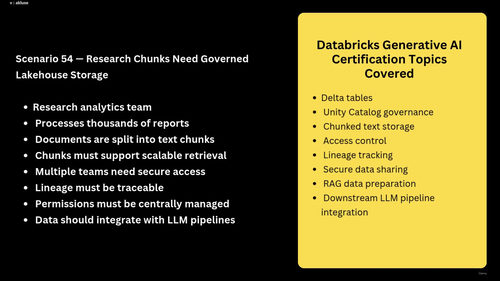
数据准备与嵌入层面,你会碰到各种棘手的预处理场景:文档切片太细导致嵌入数量爆炸怎么办;财报和合同这类结构化文档需要按章节切块而不是简单按长度切;扫描的合同图片要先做OCR才能变成干净的文本;新上的产品文章需要自动计算嵌入并写入索引。这些题目会让你学会在不同文档类型、不同业务需求下选择合适的切块粒度和嵌入策略。
向量搜索与RAG是这门考试的重头戏,场景题自然也最密集。你会遇到文档检索到了但正确的那篇排在了后面,这时候重排序器就派上了用场;检索到的段落塞进提示词之后超出上下文窗口,需要做上下文压缩;产品搜索需要先按品类过滤再排序;法律先例检索要保留时间线和文档结构以免破坏语义;多语言RAG变慢变贵,可能需要换更小的嵌入模型。这些题目会让你对RAG的全链路建立起清晰的直觉,而不是只会调一个现成的库。
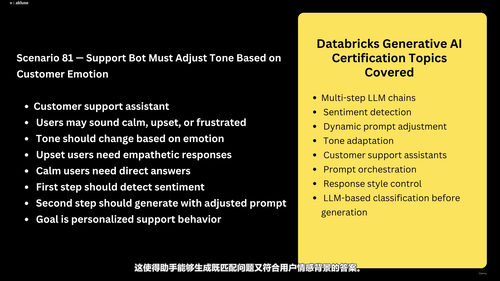
提示工程与代理设计层面同样有不少典型场景:模型给出了正确答案但格式乱七八糟,多余的解释和推理风格文字混在里面——这时候少样本提示能教会模型模仿你想要的输出风格;AI工作流需要多个LLM步骤串联,编排器该怎么设计;客服助手需要在运行时根据用户问题自动选择正确的工具;规划器只能推荐真实目录里存在的商品,不能凭幻觉编造。每个场景都对应着实际生产中常见的设计取舍。
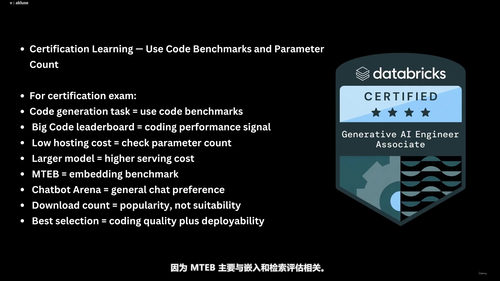
模型服务、治理与评估层面,场景题会把视角拉到生产环境。微调后的模型怎么挂上托管的推理终端;公开模型怎么防止未授权访问;LLM助手需要预留稳定的服务容量应对流量高峰;面向客户的应用需要做简单的输出安全过滤;微调数据需要符合法律合规要求;开发环境需要受控访问生产模型但不能直接碰线上数据。评估相关的场景则覆盖了翻译质量的参考指标、检索质量的客观比较、生产应用的容量规划这些容易被忽略但又必须掌握的细节。
三、速查手册帮你查漏补缺
课程最后附赠一份精心整理的速查手册HTML文档,把所有核心概念、关键术语和典型选择依据汇总成结构化的清单。考前最后冲刺的时候翻一翻,能帮你快速定位薄弱环节;日常工作中遇到具体决策时,它也是一份不错的参考工具。
四、这门课适合谁
如果你是数据工程师、数据科学家或者机器学习工程师,想要系统上手Databricks上的生成式AI项目;如果你是架构师或技术负责人,需要快速建立对Databricks生成式AI生态的完整认知;又或者你已经在做LLM应用开发,但想在向量搜索、RAG架构、生产治理、评估体系这些方面补齐知识盲区——这门课都能帮上忙。需要说明的是,这门课并不适合完全的零基础初学者,如果你连Databricks工作流和基础数据处理都不太熟悉,建议先补充一些基础知识再来挑战这些场景题。
学完之后,你会发现自己面对考试题目时不再纠结于死记硬背——每一道题都会变成一个具体的工程情境,而你已经具备了拆解问题、选择方案、识别陷阱的能力。这种从场景出发建立起来的判断力,会一直陪伴你后续的实际项目开发。