资源介绍
视频数量:12个
总时长:1小时42分
课程介绍:
企业级检索增强生成实战:从原理到生产部署
想象一下这个场景:你把公司内部的产品手册、技术文档、项目报告全部塞给一个大语言模型,问它一个关键的业务问题,它信心满满地给了你一个答案——但这个答案里有三分之一的细节是编造的,而且引用的是两年前的旧版本。这是当下很多团队在尝试把AI接入企业知识库时踩过的坑。模型的"冻结知识"问题、微调的昂贵成本、长上下文窗口的不可控性,这些现实障碍指向同一个方向:检索增强生成,也就是常说的RAG。这门课要讲的,不是RAG的皮毛玩具演示,而是真正能在企业生产环境里跑起来的那一套。
一、为什么企业需要RAG而不是其他方案
课程开篇直接切入一个核心问题:面对企业知识库,RAG、微调、长上下文窗口这三条路到底怎么选?讲师会带你拆解语言模型"冻结知识"的根本局限——它训练完成后就不知道世界上发生了什么变化,而企业的数据每天都在更新。接下来,从更新成本、推理延迟、数据安全、答案可追溯性这几个真正决定能不能用的维度,把三种方案摊开对比。最后,你会看到一套企业级RAG系统的完整解剖图:从文档源到用户界面,数据到底流过了哪些组件,每个环节在做什么。搞清楚这张图,后面所有的技术细节才有落脚点。这一章还配了一张速查表,方便你随时回顾核心概念。
二、数据摄取与索引:让机器读懂企业文档
RAG系统能不能回答好问题,第一道关卡不在模型,而在数据怎么进来。企业文档不是干净的维基百科,它们有的是PDF扫描件、有的是带表格的财报、有的是格式混乱的工单记录。这一章讲的就是怎么把这些非结构化的东西变成机器能高效检索的结构化数据。具体包括:大规模文档解析与预处理的技术选型,包括怎么用OCR处理扫描件、怎么解析复杂表格;切块策略的权衡,块切太粗检索不准,切太细又丢失上下文,课程会教你怎么根据业务场景选择合适的策略;Embedding模型和向量数据库的选择逻辑,包括不同模型的语义捕获能力差异,以及主流向量数据库的工程特点。学完这一章,你对"数据管道"这四个字会有完全不一样的理解。
三、检索的艺术:从基础到高级模式
检索是RAG的心脏。课程会带你深入稠密检索、稀疏检索、混合检索这几种主流路线的原理与适用场景,以及重排序为什么是提升答案质量的关键一步。紧接着是几个进阶话题:多跳推理、自查询、HyDE这些高级RAG模式各自解决什么问题。多跳推理让系统能跨文档串联信息,自查询让模型自己拆解查询条件,HyDE则用假设性文档来增强检索效果。然后是当下最热门的GraphRAG(用知识图谱增强检索)和Agentic RAG(让AI Agent自主决定怎么检索、多轮检索),它们在处理复杂关联问题时展现出的能力,会让你对RAG的边界有全新的认知。
四、框架、安全与治理:企业落地的关键
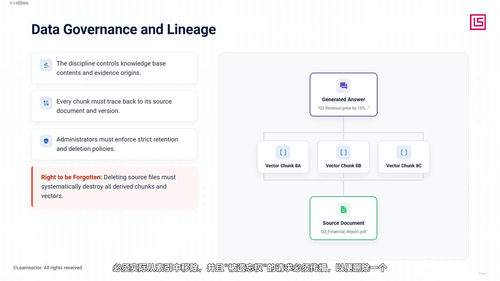
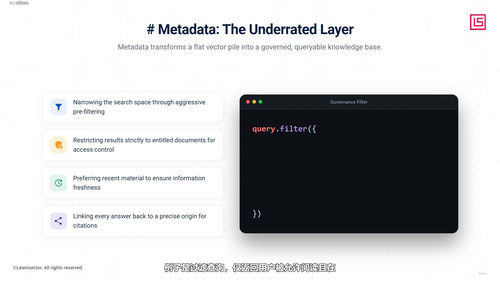
技术跑通了,能不能上线还要看安全和治理。这是很多技术团队忽略、但安全部门死活不放行的部分。课程会系统梳理LangChain、LlamaIndex这些主流编排框架的生态和选型思路,更重要的是讲清楚企业部署最容易卡住的环节——权限控制。讲师会举一个特别扎心的例子:检索系统不加防护地展示了一份用户本无权查看的工资文件,结果不是系统"有缺陷",而是"在等一场数据泄露事故"。具体的解法是:把文档级访问控制直接编织进检索管道,每个文本块打上访问元数据,查询时先做权限预筛选。这一章还涵盖治理策略和护栏机制,包括怎么防止模型输出有害内容、怎么对回答做合规审计,是把RAG从Demo推向生产必修的一课。
五、评估与运维:上线只是开始
很多团队以为RAG上线就完事了,其实真正的考验在后面。课程最后一章讲的是评估和运维:怎么量化RAG的答案质量,包括答案相关性、上下文忠实度、检索召回率这些核心指标;怎么搭建可观测性体系来追踪每一次检索和生成的表现,及时发现质量退化;以及成本、延迟、扩展性这些生产环境绕不开的工程指标,怎么控制token消耗、怎么应对流量峰值、怎么设计缓存策略。学完这些,你才算真正理解了"生产级"这三个字意味着什么。
整门课程时长一小时四十二分钟,分成五个章节、十二个核心模块,每章配有速查表帮助复习,课程末尾还附了一份完整的术语表。讲师拉杰尼什·坦登拥有比尔斯拉尼大学人工智能与机器学习硕士学位背景,也在安永、德勤等机构做过大量企业培训,还在印度管理学院等高校任教过,内容既有理论深度又接地气。如果你是一名需要把AI能力真正落地到企业内部的工程师、数据科学家或技术负责人,这门课能帮你跳过大量踩坑时间,直接拿到一套经过实战检验的方法论。