资源介绍
视频数量:19个
总时长:1小时24分
课程介绍:
数据仓库与数据挖掘入门
你有没有过这样的体验:刚在购物网站搜了一款蓝牙耳机,接下来几天打开手机,满屏都是耳机推荐。电商平台似乎比你更了解自己的购物偏好。这种"未卜先知"的能力,背后依靠的正是数据仓库与数据挖掘技术。
这门课由讲师Munaz Agul主讲,一共19个视频,总时长一个半小时出头。时间不长,但内容覆盖相当扎实,从基础概念一路延伸到具体算法。对于计算机科学、软件工程、BCS、BCA等相关专业的学生来说,特别适合用来应对大学考试或准备面试;对所有想了解数据是如何被处理和利用的人来说,这门课也是一个不错的入门材料。
整个课程大致可以分成三个板块来理解。
一、数据仓库的整体架构
课程开头会帮你厘清几个容易混淆的概念:数据仓库到底是什么?它和日常使用的数据库有什么区别?这些基础问题看似简单,却是考试和面试中的高频考点,搞不清楚很容易丢分。
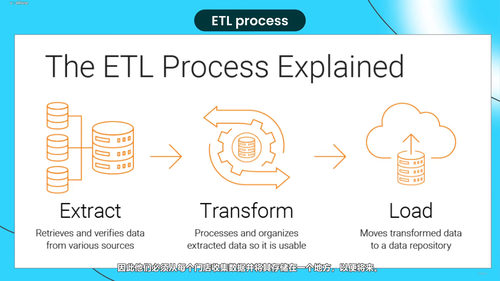
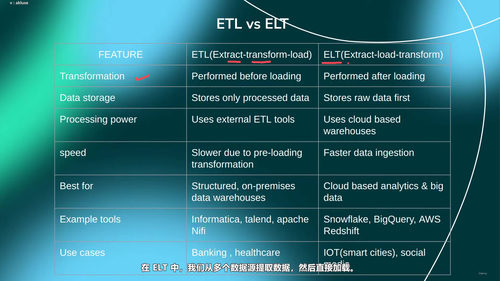
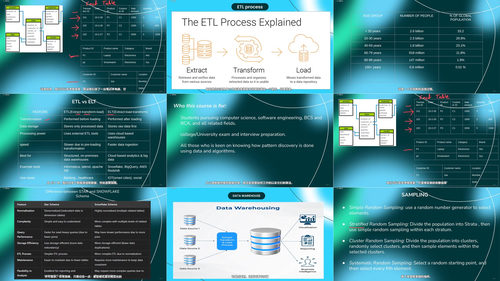
紧接着你会学到ETL的完整流程,也就是抽取、转换、加载。数据从各个业务系统中被抽取出来,经过清洗和转换后加载到数据仓库中。课程还会讲到ELT模式,把加载和转换的顺序调换过来。这种新模式随着云数据仓库的兴起变得很流行,两者的适用场景和优劣对比是课程的重点内容。
数据湖、数据仓库、数据挖掘这三个词经常被放在一起提及,但其实是三件不同的事。数据湖相当于原始数据的"蓄水池",什么格式都往里装;数据仓库是经过整理和结构化的数据集合;数据挖掘则是从这些数据中挖出有价值信息的过程。三者配合使用,构成了完整的数据处理链条。课程专门花了一节来讲它们之间的区别,理清这几个概念之间的边界。
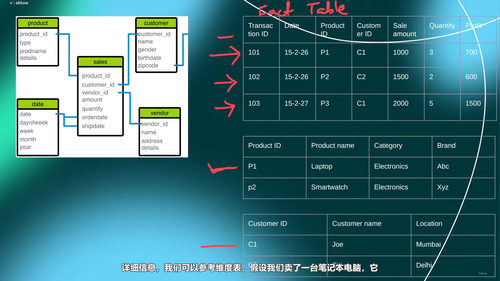
在数据仓库的建模部分,课程详细介绍了星型模型和雪花模型两种核心架构。星型模型结构简单,中间是一张事实表,周围环绕着维度表,像星星一样辐射开来;雪花模型则把维度表进一步规范化,拆分成更细的子表,形状像雪花层层展开。课程还专门花了一节对比两者的优缺点,帮助你在实际项目中根据查询性能和存储需求做出合适的选择。
二、OLTP与数据预处理
讲完数据仓库的整体架构,课程会带你了解OLTP,也就是在线事务处理。你每次在淘宝下单、用手机银行转账,背后都是OLTP系统在支撑。课程会拆解一个完整OLTP流程涉及哪些组件——用户界面、应用服务器、数据库服务器是如何协作完成一次事务的。理解OLTP之后,你才能更好地理解为什么需要单独建一套OLAP系统来做数据分析。
数据预处理是数据挖掘中非常关键但容易被忽视的一环。课程用了一个很形象的比喻:就像把蔬菜水果放进冰箱之前要先清洗分拣,原始数据在喂给模型之前也必须经过预处理。这一步如果做得不到位,模型再复杂也是"垃圾进,垃圾出"。预处理涵盖数据清洗、处理缺失值、去除噪声、统一格式等多个环节,课程会讲清楚每一步的目的和常用方法,以及预处理如何提升数据质量、降低计算复杂度。
数据类型是另一个容易被忽略的基础知识点。课程专门用两节来讲数据的不同分类:分类型与数值型、连续型与离散型。不同类型的数据适合不同的处理方式和算法,类型没搞清楚,后续的离散化和聚类分析都会出问题。数据离散化部分则会教你如何把连续型数据转换为离散型数据,比如把年龄这个连续变量分成"青年""中年""老年"三个区间,以及这样做的意义何在。
三、数据挖掘的核心算法
进入课程后半段,你将接触真正的数据挖掘算法。
聚类分析是最常用的技术之一。课程会介绍什么是聚类、常见的聚类算法有哪些、它们各自适合什么场景。电商平台经常用聚类把用户分成不同群体,进而做精准营销,就是聚类分析的典型应用。
异常检测用来识别不符合正常模式的数据点,也就是异常值和离群点。这些异常可能是数据录入错误,也可能是真实的异常事件,比如信用卡欺诈检测就严重依赖异常检测算法。课程会带你理解异常检测的基本思路和方法。
LZW算法是一种经典的数据压缩算法,在数据预处理和存储优化中都有应用。它通过建立字典来压缩重复出现的字符串模式,课程会讲清楚它的工作原理和实现步骤。
Apriori算法是关联规则挖掘的经典代表,最常见的应用就是"购物篮分析"——分析顾客经常一起购买什么商品。"啤酒与尿布"的故事就是它的著名案例。课程会带你理解Apriori的核心思想:频繁项集是如何生成的,关联规则又是如何从频繁项集中推导出来的。
最后课程还会讲数据采样的方法和适用场景。当数据量太大无法全量处理时,就需要用有代表性的样本来代替全量数据进行分析。课程会介绍不同的采样技术以及各自的适用条件。
学完这门课,你会对数据仓库和数据挖掘形成一个完整的认知框架。不只是知道这些概念各自是什么,更能理解它们在实际业务中是如何串联使用的。从数据采集、存储、清洗,到建模、分析、挖掘,你会看到一个完整的数据处理链条是怎么跑起来的。对于正在准备考试和面试的同学,或者未来想从事数据分析、数据工程相关工作的同学来说,这是一个很好的入门起点。