资源介绍
视频数量:5个
总时长:55分
课程介绍:
Python生成式AI全栈实战:从零到英雄的进阶之路
你打开招聘网站,搜一下"AI工程师"或者"机器学习工程师",会发现几乎每一家科技公司都在招人,薪资数字一个比一个亮眼。但当你点开岗位要求,看到"熟悉Python""掌握深度学习框架""具备NLP项目经验"这些字眼,心里又有点发怵——我连Python基础都还没打牢,怎么可能去做生成式AI?
其实这种焦虑大可不必。所有的复杂技术,都是从最基础的原理一层一层搭建起来的。这门课程的设计思路就是如此:不绕弯子,不堆概念,带着你用手敲代码的方式,亲手把一个AI项目从环境配置到模型训练再到效果验证完整走一遍。五十五分钟,五个视频,看起来不长,但每一节都是实打实的干货,覆盖了一条完整的学习路径。
一、开发环境搭建:好的开始是成功的一半
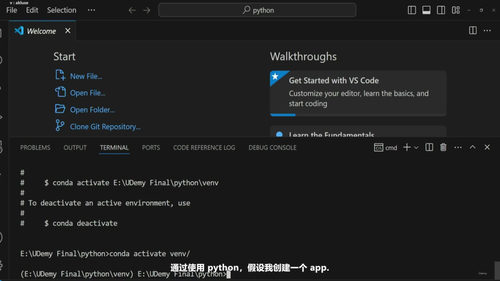
很多人写Python代码,第一关就被环境问题卡住了。这门课的第一节直接带你解决这个痛点。老师会演示怎么用VS Code作为主力编辑器——这可不是随便选的工具,VS Code既能跑Jupyter Notebook,也能写.py脚本,还能一键创建虚拟环境,安装扩展插件非常方便。你会跟着老师的操作,从零创建一个Python 3.12的新环境,老师还会顺便讲解为什么每个项目都应该有独立的环境——因为你永远不知道三个月后你用到的某个库会不会升级到不兼容的版本。环境隔离这个习惯一旦养成,后面写项目会少踩很多坑。
二、文本预处理与分词:让机器读懂人类的语言
生成式AI归根结底要处理的是文本,那机器怎么理解一段话的意思?这就涉及到NLP最基础、也最关键的一步:文本预处理和分词。这一节会用一个生动的例子帮你理解为什么要用"容器"来管理开发流程——想象一下,如果你在Windows上开发,而你的同事用Linux,两个人装同一个项目很可能跑出完全不同的结果。通过这个比喻,你会明白环境隔离不只是个人习惯,更是团队协作的基础设施。分词环节则会把一段文字拆解成模型能处理的最小单位,这听起来简单,但中文和英文的分词逻辑完全不同,里面藏着很多容易忽略的细节。
三、多元线性回归:从简单到复杂的第一步
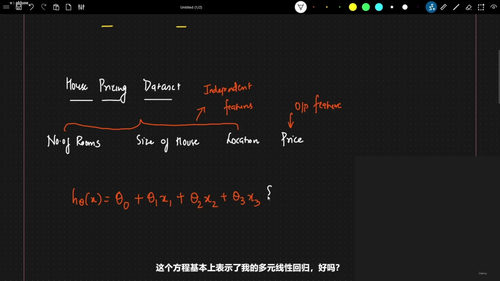
这一节是整门课的数学基础。如果你已经看过简单线性回归的内容,那多元线性回归就是在它基础上增加输入特征的维度。老师会带你回顾简单线性回归的收敛算法——也就是通过不断调整截距和斜率来找到最佳拟合线的过程。然后自然地扩展到多元情况:当输入特征不止一个,比如要根据体重、年龄、运动量等多个因素来预测身高时,模型的参数会如何变化,方程怎么写,梯度下降的过程有什么不同。这部分内容看似基础,却是理解后面所有复杂模型的基石,因为神经网络本质上就是把线性回归不断叠加和非线性化的结果。
四、用训练好的神经网络做预测:见证模型的威力
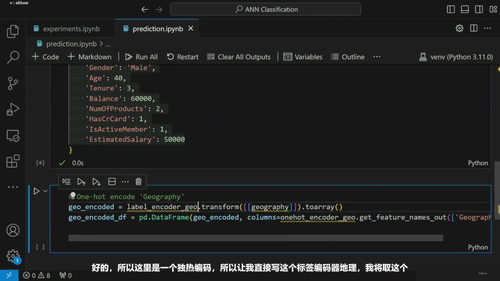
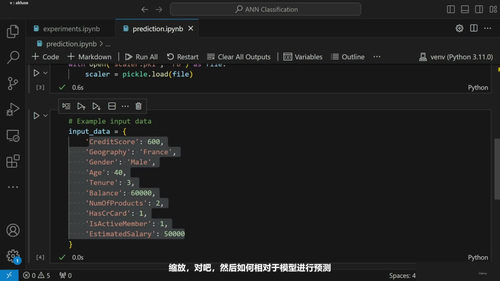
学完了理论,怎么把它用起来?这一节会展示如何调用一个已经训练好的人工神经网络模型,对新的输入数据做出预测。你可以把它理解为"开车"——之前的课程教你造引擎(理解数学原理),这一节教你踩油门挂挡(实际运行模型)。你会看到模型是如何接收输入、经过各层神经元的计算、最终输出预测结果的。这个过程会让你直观地感受到深度学习的强大,也为后面学习如何训练自己的模型埋下伏笔。
五、过拟合与欠拟合:成为真正能解决问题的工程师
很多人跑通了一个模型就以为大功告成,结果把模型部署到真实场景里效果一塌糊涂。问题往往出在过拟合或者欠拟合。这一节讲的就是模型泛化能力这个核心问题:模型在训练数据上表现太好反而可能是坏事(过拟合),学到的东西记在了训练集的噪声上而不是真正的规律上;而欠拟合则是模型太简单,连训练集都学不好。老师会拆解这两种问题的成因,给出对应的解决思路。学完这一节,你才算真正具备了评估和优化模型的能力,而不是只会机械地调用库函数。
整门课适合谁?如果你是刚接触编程的非科班出身者,想转行进入AI领域却不知从何下手,这门课是一个不错的起点。如果你已经会一些Python基础,想系统了解机器学习项目的完整流程,这门课也能帮你快速建立认知框架。课程的最大特点是节奏紧凑、目标明确——不花时间讲那些花里胡哨的前沿概念,而是实实在在地带你把基础知识过一遍,为后续深入学习生成式AI打下牢固的地基。
等你上完这五节课,打开一个全新的AI项目源码时,你会发现自己不再一脸茫然——环境怎么配、数据怎么清洗、模型怎么跑、效果怎么评估,每一步你心里都有数。这正是这门课想带给你的东西:不是一堆死记硬背的知识点,而是一条清晰可循的工程实践路径。