资源介绍
视频数量:24个
总时长:3小时36分
课程介绍:
本地大模型从零到实战
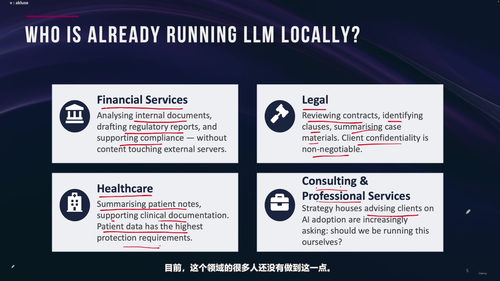
你有没有过这样的经历?想用AI处理点工作上的文本,但一打开ChatGPT就犹豫了——这份合同能不能传上去?客户数据安不安全?每个月几十美元的订阅费又该找谁报销?
如果这些问题困扰过你,"本地大模型"就是为你准备的答案。简单说,就是把AI模型装进你自己的电脑里,数据不外传,不用交月费,想怎么用就怎么用。这门课要带你走完这条路,从完全不懂到亲手部署一个能用的本地AI系统。讲师Dr. Usman在学术界和工业界摸爬滚打多年,全球学员超过二十万,讲东西很接地气。
一、先把地基打好
课程开头不会急着让你敲命令,而是用三节课讲基础:生成式AI到底是什么、大语言模型怎么工作、它们和传统聊天机器人有什么本质区别。这部分听起来像科普,但对后面选模型、调参数至关重要。很多人在使用本地模型时一头雾水,根本原因就是基础概念没理清。讲师会举很多生活化的例子,让抽象概念变得有抓手。
二、为什么要把AI装到本地
这一段是课程的核心理念铺垫。讲师讲清楚云端AI和本地AI的真实差别——不只是"离线能用"那么简单,还涉及数据主权、成本结构、延迟控制、定制自由度等多个维度。然后带你认识本地AI生态圈里的各种工具和它们各自的角色,让你对整个领域有一个全景认识。
重头戏是安装Ollama并跑通第一个本地提示词。讲师手把手演示从下载到首次对话的全过程,Mac和Windows用户都照顾到。之后用一节课专门讲模型参数和模型大小的关系——为什么有些模型跑得快但回答笨,有些模型回答好但风扇狂转,哪些参数调整能直接影响回答风格。
选模型单独拿出来讲一节。Llama、Qwen、Gemma、DeepSeek、Mistral……开源社区里能选的模型有几十个。讲师给出一个决策框架,教你根据任务类型——通用对话、编码、推理、多语言——和硬件条件来缩小范围。比如做编码任务优先考虑什么,用非英语工作优先考虑什么,普通笔记本能流畅跑的是哪些,每个建议都来自实际使用经验。
三、给本地模型一个漂亮界面
只用终端和模型对话总归不够舒服。课程第三部分介绍Open WebUI——一个跑在Ollama上的图形界面,用起来和ChatGPT网页版几乎一样,但背后是你自己的本地模型。
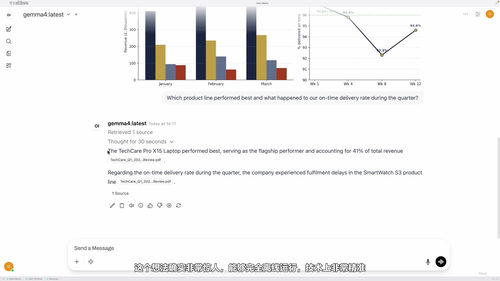
讲师演示Docker和Python两种安装路径,然后详细走一遍界面:怎么切换不同模型、怎么管理对话历史、怎么调整系统提示词、怎么上传文档做问答。最后讲一个进阶场景——如何把Open WebUI和Ollama部署给团队成员使用,让局域网里的同事都能用上本地AI。这一节对企业用户特别有价值。
四、小模型有自己的脾气
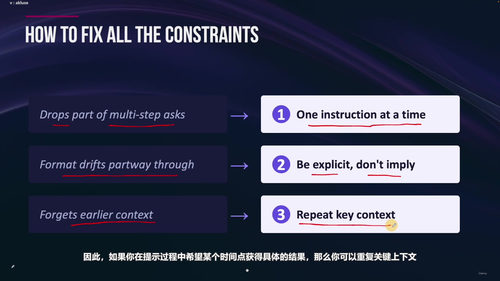
很多人装好本地模型后第一反应是:怎么回答这么笨?原因很简单——7B、13B参数量的本地小模型,和云端动辄几百B的大模型,能力差距是客观存在的。但差距不是不能弥补,关键看你会不会"问问题"。
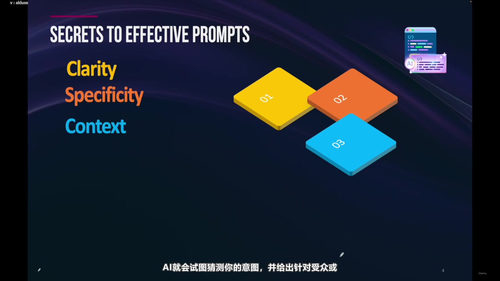
这部分专门讲提示工程,但和那些泛泛而谈的提示词课程不同,重点讲小模型的特殊行为模式。小模型对指令格式更敏感、对few-shot示例依赖更强、需要更明确的角色设定。零样本、少样本、思维链这些技术会逐个拆开演示,让你看到不同提示方式下模型回答的真实差异,而不是纸上谈兵。
五、把本地AI接入自动化工作流
课程最后一部分是很多人忽略但价值极高的内容。讲师介绍n8n这个开源自动化工具,带你在Docker里搭一套本地"AI工作台"。
从Docker Desktop的安装配置,到n8n的初始化,再到把Ollama接入n8n作为AI节点,讲师演示了一个完整的本地聊天机器人工作流。配置过程涉及多个服务协同,讲师提供了详细手册和配置文件,把常见的坑提前标出来,省得你走弯路。最后还会专门讲一讲如何设计稳定可靠的本地AI方案,避免常见的部署陷阱,比如模型响应不稳定时如何兜底。
六、学完之后你能做什么
整个课程三个半小时出头,信息密度却很高。学完你能做到的事情很具体:在一台普通电脑上跑起一个或多个本地大模型,用浏览器和它对话;根据任务挑选合适的模型,理解不同参数设置的影响;用提示工程技术明显提升小模型的输出质量;搭建一个本地的自动化工作流,把AI嵌入到日常任务里。
课程不需要你之前了解AI,也不需要你会编程,但有一些命令行基础会学得更轻松。它适合那些对数据隐私有要求、希望降低AI使用成本、或者单纯想搞清楚本地AI到底怎么玩的人。
本地AI正处于爆发期,懂得部署和管理本地模型的人在市场上确实稀缺。不管你是开发者、产品经理,还是只想动手折腾一下技术爱好者,这套东西都值得花一个周末学完。