资源介绍
视频数量:8个
总时长:1小时25分
课程介绍:
机器学习与数据科学实战入门
你有没有试过打开招聘网站,看到满屏的"数据科学家""机器学习工程师"岗位,心里一动,再点开职位描述,密密麻麻的专业名词——特征工程、探索性分析、线性回归——是不是瞬间就打起了退堂鼓?又或者你下载了Python,装好了编辑器,准备大干一场,对着空白的界面却不知道该从哪一行代码开始?
这门课就是为打通"从零到上手"这段距离而设计的。八个视频,一个半小时出头,带着你走完一个机器学习项目从环境搭建到模型训练的完整流程。每一步都有老师的现场操作演示,看完就能跟着动手。
一、开发环境与Python配置
很多人学机器学习的第一步就卡在了环境配置上——不同项目需要不同版本的库,互相冲突,代码莫名其妙报错。第一节课就从根源解决这个问题:在VS Code里搭建独立的项目环境,使用最新的Python 3.12版本,还会顺带介绍3.10到3.12中所有值得关注的新特性。隔离环境这个习惯一旦养成,以后做任何Python项目都能避开"在我电脑上能跑"的经典难题。
二、Pandas数据分析基础
环境就绪,接下来就要和数据打交道了。Pandas是Python数据科学最核心的工具,没有之一。这一节会带你熟悉DataFrame的各种操作:读取CSV和Excel数据、用条件筛选过滤数据、做分组聚合统计、处理缺失值。一个合格的数据科学家,往往把六七成的时间花在数据处理上,Pandas就是你干这些活的瑞士军刀。
三、Matplotlib与Seaborn可视化
光盯着数字表格很难看出数据里的规律。这一节教你怎么用Matplotlib和Seaborn把数据变成直观的图表:折线图看趋势,柱状图比大小,散点图找相关性,热力图看变量关系。老师会结合真实的数据演示,让你体会到一张好图胜过一百个统计数字。
四、线性代数核心知识
一提线性代数就头疼?这一节不给你讲纯数学理论,只聚焦机器学习里真正会用到的东西:矩阵运算、向量空间。为什么线性回归能用矩阵表示?神经网络里的权重为什么是矩阵?这些知识点是后面理解深度学习的根基,现在花点时间搞懂,后面学神经网络就会轻松很多。
五、数据预处理与清洗
真实世界的数据几乎没有干净的。缺失值、异常值、重复数据、格式不统一——这些问题每个项目都会遇到。不把这些脏数据处理好,再先进的算法也跑不出好结果。这一节会教你完整的清洗流程:怎么识别缺失值并选择合理的填充策略,怎么检测异常值并决定是否剔除,怎么统一编码和格式。老师演示的数据集就像真实项目里会遇到的"疑难杂症",跟着处理一遍,下次自己遇到就不慌了。
六、特征工程与特征选择
数据和模型之间还差一座桥——特征工程。这是最容易被低估却最能拉开差距的一步。同样的数据,特征做得好,简单的模型也能出彩;特征做得差,再复杂的算法也是徒劳。这一节会介绍独热编码、标签编码、特征缩放、相关性分析、递归特征消除等核心方法。学完你会真正理解那句话:数据和特征决定了上限,算法只是在逼近这个上限。
七、探索性数据分析
EDA是数据科学项目的关键一步,介于清洗和建模之间。这一节教你用统计方法和图表系统性地理解数据集:分布是什么样的?变量之间是否相关?有没有隐藏的分组或异常?老师会演示一个完整的EDA流程,从单变量到多变量,从分布图到相关矩阵。做模型之前先做EDA,能帮你省下大量调参和试错的时间,也能让你对最终模型的结果有更可靠的判断。
八、监督学习算法实战
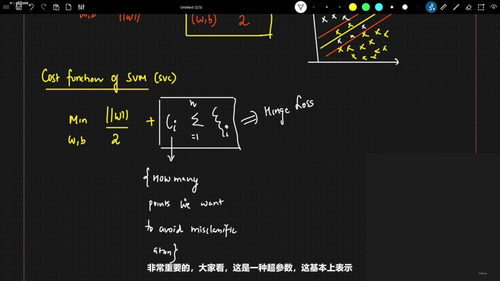
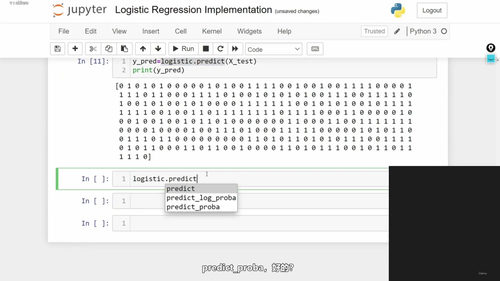
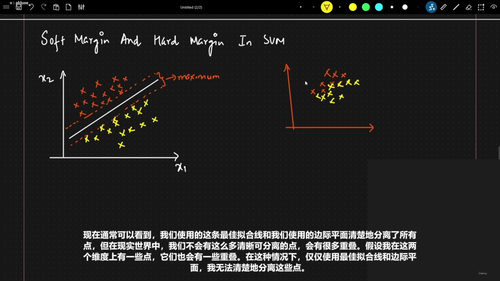
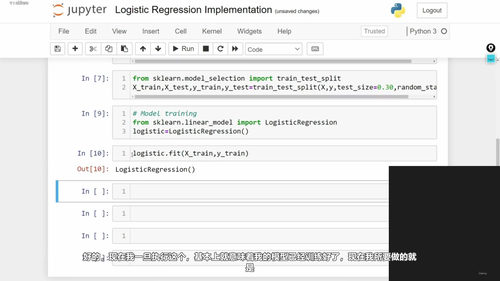
终于到建模环节。这一节带你入门监督学习——机器学习里最重要的一类算法。从最简单的线性回归讲起,用体重和身高这样的直观例子解释回归的本质:给定输入特征,找到最佳拟合线来做预测。在此基础上还会介绍多元线性回归、逻辑回归、决策树等常用算法,每个都讲清楚适用场景、数学直觉,以及怎么用scikit-learn一行代码调用。
适合谁学?如果你之前没怎么接触过数据科学,但又想快速了解机器学习项目的全貌;或者你已经在自学,但总觉得知识点零零散散,没有一条完整的主线把它们串起来——这门课都能帮到你。它不会让你学到头秃,但能在最短的时间里帮你建立完整的知识地图,知道每个环节在做什么、为什么这么做。
整个课程加起来虽然只有一个半小时,但密度不低。它更像是一张精心规划的地图,把数据科学项目里最核心的环节都标了出来。学完你会发现,那些招聘启事上看起来吓人的术语,拆开来看都是一个个具体的技术点,而每一个你都在课程里见过影子。接下来要做的,就是挑一个感兴趣的方向——深度学习、自然语言处理、或是时间序列——深入钻下去。
学机器学习最怕的就是一直在准备,一直在收藏教程,却从来没有敲过第一行代码。这门课最适合那些想现在就动手的人。