资源介绍
视频数量:93个
总时长:2小时19分
课程介绍:
神经网络训练的两大基石:损失函数与学习率完全指南
你有没有过这样的经历:辛辛苦苦搭好一个神经网络,调了半天参数,损失值就是死活不往下掉?或者训练集上表现完美,一到测试集就拉胯?问题很可能出在两个最基础、却最容易被忽视的地方——损失函数和优化策略。
很多人学深度学习,一上来就追最新的模型架构,张口闭口Transformer、扩散模型,但对"模型到底是怎么知道自己错在哪""它又是怎么一步步变好的"这两个根本问题,其实只是模糊地知道个大概。如果你也想把这两个问题彻底搞清楚,这门课就是为你准备的。
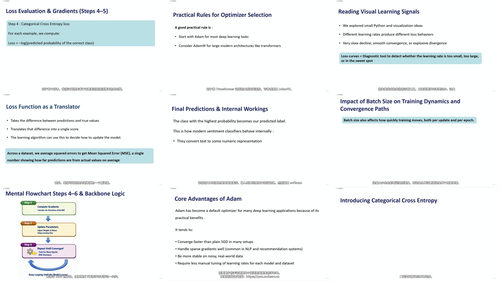
整个课程围绕损失函数和学习率两条主线展开,一共八个模块,把神经网络训练中最核心的调参逻辑掰开揉碎讲给你听。
第一模块先打底,讲清楚"损失函数到底是什么"。课程用了一个很生动的比喻——蒙眼射箭的弓箭手。你看不见靶心,但每一箭射出去之后,有人告诉你离靶心有多远,这个"远"就是损失。课程会带你理解为什么我们要把误差做平方处理,而不是直接用绝对值,顺便用Python演示一下均方误差的计算过程。最后你会学到怎么通过损失曲线的形状来判断训练到底进展得如何——是稳步下降,还是卡在某个地方不动了。
第二模块讲学习率,这可能是训练中最让人头疼的超参数。课程用"走下山"的故事做类比,把学习率比作你每一步迈多大。太小的步子,你可能在半山腰磨蹭半天都到不了山底;太大的步子,你可能直接从这座山跨到那座山,永远找不到最低点。课程会教你三种判断学习率是否合适的方法,包括一个非常实用的技巧——学习率查找器。还会介绍学习率调度策略,让训练过程从一开始的大步快跑逐渐过渡到后期的精细微调。
第三模块专门讲均方误差,回归问题里的主力损失函数。课程会告诉你它适用的真实场景,从预测房价到预测薪资,手把手教你用Python手动计算MSE,再用它训练一个完整的神经网络。公式的每一步推导都讲得很清楚,包括它和梯度下降之间是怎么配合工作的。
第四和第五模块是交叉熵系列,分别对应二分类和多分类问题。为什么回归用的损失函数不能直接拿来分类?交叉熵到底在惩罚什么?课程用"是/否决策"和"多选题"两种场景,把二分类交叉熵和分类交叉熵讲得明明白白。还会用一个真实的文本情感分类项目走通整个流程,让你看到从数据准备、损失函数选择、到模型训练和预测的完整闭环。
第六模块讨论梯度消失问题,这是训练深层网络时最容易踩的坑。为什么网络叠得越深,靠近输入层的权重就越难更新?课程从数学直觉和可视化两个角度解释这个现象,然后给你一整套解决方案工具箱:ReLU激活函数、He和Xavier初始化、批归一化、ResNet的跳跃连接、还有专门处理序列数据的LSTM和GRU。每个工具都会讲它解决了什么问题、原理是什么。
第七模块进入现代优化器的世界,讲RMSprop和Adam这两个深度学习中最常用的自适应算法。它们和传统SGD最大的区别在于,能根据每个参数的历史梯度自动调整学习率。课程会用可视化的方式展示三种优化器在损失曲面上的运动轨迹差异,让你直观感受到Adam为什么快、什么时候反而不如SGD好。
第八模块收尾于批量大小对训练的影响。全批量、随机梯度下降、小批量梯度下降,三种方式的梯度行为有什么不同?为什么小批量通常是最佳选择?课程还会带你理解"锐极小值"和"平坦极小值"的概念,解释批量大小为什么会影响模型的泛化能力——这恰恰是很多初学者调参时根本没想过的维度。
整门课不要求你有高深的数学背景,每个公式都有直观的解释,每个概念都有对应的Python代码让你亲眼看到效果。课程总共两个多小时,但信息密度很高,每一个视频都在解决一个具体问题。
如果你正在学深度学习,已经跑通过几个demo,但对自己的训练过程为什么这样、那样到底是怎么回事还似懂非懂,这门课会帮你把那些模糊的地方全部点亮。学完之后,你不再只是"调包侠",而是真正理解模型为什么这样学习,以及怎么让它学得更好。