资源介绍
视频数量:107个
总时长:7小时41分
课程介绍:
AWS生成式AI开发者专业认证:基础模型集成、数据管理与合规性精讲
一个开发团队花了三个月时间搭好了一套基于大模型的问答系统,上线第一天用户量激增,接口直接被打挂了。第二天值班工程师发现,模型在某个时段频繁返回过时信息,排查半天才发现是数据源没有及时更新。更糟的是,安全部门突然要求审查所有用户输入和模型输出,因为产品涉及金融场景,必须满足合规要求,而团队此前根本没考虑过审计日志这回事。
这不是编出来的故事,而是很多初次涉足生产级生成式AI系统的团队都会踩到的坑。考试不会直接问你"心情怎么样",但它会通过一道道复杂场景题,检测你能不能在设计阶段就把这些坑提前填上。AIP-C01考试的第一大领域"基础模型集成、数据管理与合规性"占总权重31%,是整个认证中权重最高的一个模块,刚好对应上面那个故事里需要解决的每一类问题。
这门课程一共107个视频,总时长约7小时41分钟,分为六个章节,覆盖了从需求分析到提示词治理的完整技术链条。它的定位是高级备考课,面向的是已经有两年以上AWS经验、一年以上AWS上生产环境生成式AI开发经验的工程师,不适合零基础入门者。如果你已经拿到了AWS生成式AI从业者认证或机器学习工程师助理认证,学起来会顺很多。
一、需求分析与方案设计
课程第一章就建立全局视角,帮你训练面对一个生成式AI需求时正确的思考框架。你会学到如何根据业务场景选择合适的基础模型——是Claude还是Llama,是用大参数通用模型还是小参数专用模型,决策依据不只看跑分,更要看上下文窗口、推理成本和合规要求。
RAG(检索增强生成)是第一章的重点内容,花了多个视频拆解其工作流。你能看到RAG如何解决模型知识陈旧和幻觉问题,理解为什么这两点对于企业级应用几乎致命。第一章还讲了智能体编排、事件驱动工作流和无服务器架构,这些都是考试里频繁出现的考点。配套的Demo会用Amazon Bedrock演示完整的技术验证流程,让你看到抽象概念怎么落到具体操作上。
第一章最后会介绍AWS Well-Architected Framework的GenAI Lens和GenAIOps理念,帮助你形成架构层面的全局判断力,而不是只盯着某个组件看。
二、基础模型的选择与配置
第二章把焦点收窄到模型本身。Amazon Bedrock里可选的模型不少,它们的能力边界、定价策略、可用区域各不相同。课程教你设计多模型架构——同一个业务系统里,可能针对不同任务调用不同模型,动态选择才是常态。
模型定制化是这章的重头戏。你会学到参数高效微调技术,理解为什么绝大多数企业场景下并不需要全量微调,用LoRA这类方法就能拿到不错的效果。配合SageMaker部署定制模型的Demo,你能看到从训练到上线的完整链路。
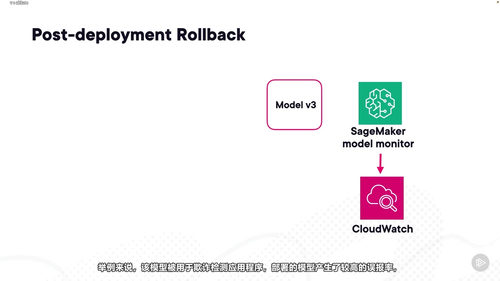
弹性设计在生成式AI系统里格外重要,因为大模型推理对资源消耗巨大。课程会带你设计跨区域模型部署策略和故障转移机制,确保一个区域出问题不会让整个业务停摆。模型全生命周期管理和变更治理流程也会讲到,这是企业环境中不可回避的话题。
三、数据验证与处理流水线
"垃圾进,垃圾出"这句老话在生成式AI系统里依然成立。第三章专门讲数据侧的准备工程。
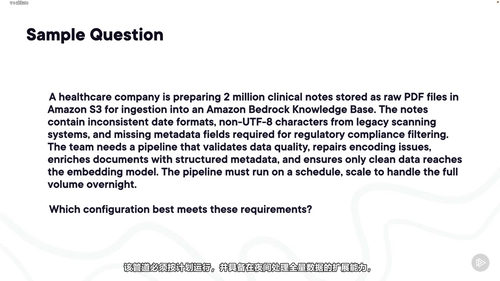
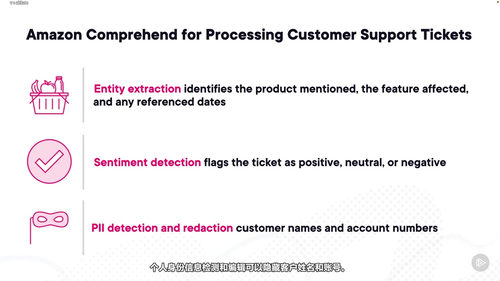
数据验证工作流该怎么设计?AWS Glue Data Quality在这一章里有专门Demo。多模态数据怎么处理?课程拆解文本、图片、结构化数据的预处理差异。数据增强也是重点,Amazon Comprehend做实体抽取、输入数据的质量提升技巧,这两块都在考试范围里。
你需要能区分哪些预处理可以用SageMaker Processing批处理跑、哪些需要流式处理。课程还列出了生成式AI系统里数据流水线的常见坑,比如向量漂移、数据格式不统一等问题,这些都是真实上线后才会冒出来的麻烦。
四、向量存储与检索方案的设计
RAG的灵魂是向量检索,第四和第五章围绕这一关键技术展开。
第四章先打基础:Embeddings是什么、Bedrock里的嵌入模型怎么选、向量数据库和传统数据库的区别。然后是Bedrock Knowledge Bases的整体介绍,从创建知识库到添加元数据,每一步都有Demo演示。高性能向量检索架构是这章的难点,涉及OpenSearch向量索引的设计、索引参数调优、混合检索策略。元数据框架的设计方法也会系统讲,因为企业场景里几乎所有向量都需要追溯来源。
第五章深入到检索机制本身:文档分块策略的取舍、嵌入模型的选型依据、向量相似度搜索的实现细节、混合搜索的搭建方式。重排序(Reranking)模型这一章会演示怎么用Bedrock自带的能力提升检索质量。查询扩展和查询分解这两个进阶技巧也都有实战Demo。
五、提示词工程与治理
为什么提示词工程值得单独成章?因为它在生产环境里从来不是"写一句话"那么简单。
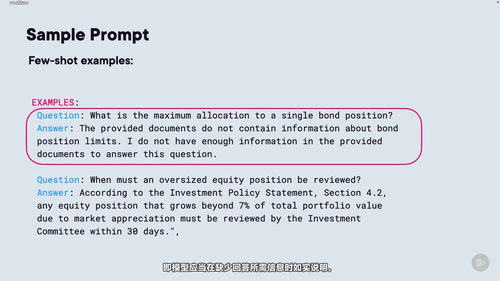
你会学到如何设计有效的提示词指令、Amazon Bedrock Prompt Management的使用方法,以及Guardrails(护栏)怎么配置才能有效拦截受限内容。Demo里会演示用DynamoDB维护对话历史,这是在Bedrock没有原生会话记忆时的常见做法。
提示词治理是这章的差异化内容。提示词在企业环境里同样需要版本管理、权限控制、效果监控,这些是传统MLOps经验在GenAI场景下的延伸。多步骤提示词工作流(Prompt Flow)是考试的高频考点,课程会用Bedrock的Prompt Flow功能做一个完整Demo。
六个章节走完,你能搭建起一套从需求到上线的完整认知框架:知道什么时候该上RAG、什么时候该上Agent、怎么选模型、怎么处理数据、怎么设计向量检索、怎么管好提示词。这些能力不只能帮你通过AIP-C01考试,更是日常工作中做技术选型和架构评审时实实在在会用到的判断力。