资源介绍
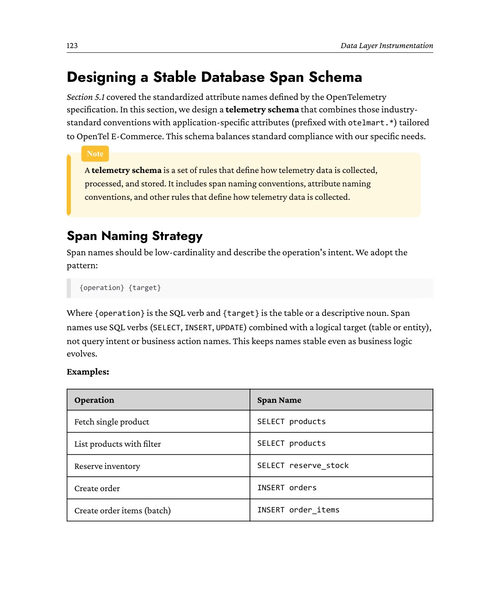
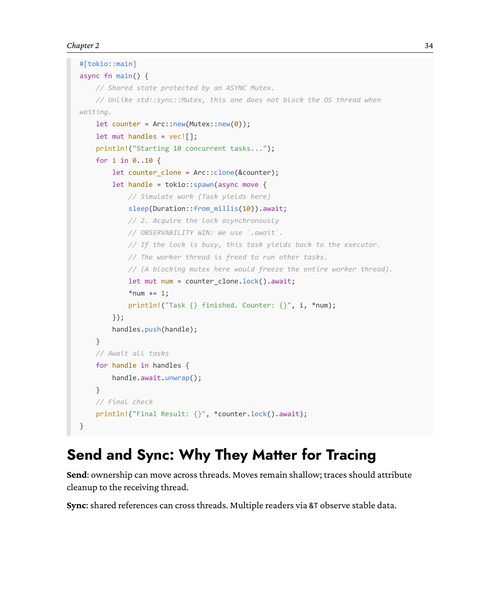
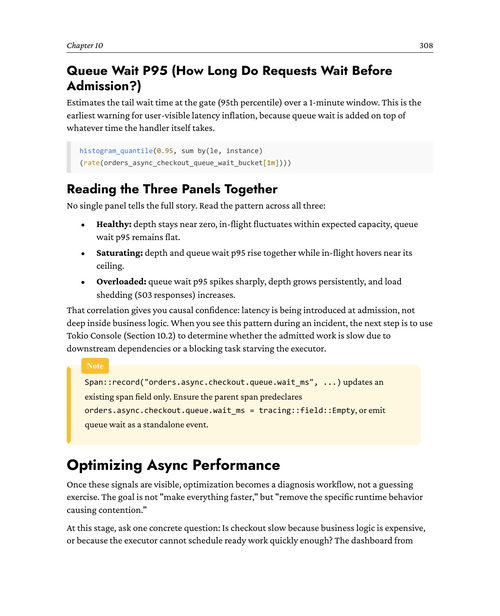
这是一本写给Rust后端工程师的实战型技术书,核心主题是如何在真实的分布式系统中落地OpenTelemetry标准。作者用了一套贯穿全书的电商系统OpenTel E-Commerce,每一章都在这个系统上做增量改造,从最基础的链路追踪、指标采集、日志聚合开始,逐步推进到SLO与错误预算、火焰图与异步性能分析、数据库故障排查、安全遥测,最后还延伸到了生成式AI增强服务的观测场景。这种一以贯之的教学方式让读者不是零散地学知识点,而是看着一个完整的系统从搭建到经受各种故障考验的过程。全书有一条叫"慢结账之谜"的故事线贯穿始终,像一部用遥测数据做证据的侦探小说,作者不断引入新的工具和方法来追踪系统中那些微妙的性能退化与资源竞争,让人读起来不至于枯燥。书的副标题虽然强调了多容器电商架构,但内容涉及的深度远超一般的入门教程。OpenTelemetry的语义约定、跨度命名规范、数据库遥测、生成式AI调用约定这些比较硬核的内容都有覆盖,而且不是简单罗列API,而是解释为什么这样设计、这样做在生产环境里意味着什么。书中第二章专门讨论如何从链路追踪数据中读懂Rust的内存行为,包括栈与堆的分配特征、Arc和Mutex的竞争模式、Send与Sync的语义影响以及异步上下文传递的机制,对于日常写Rust的人来说是非常实用的参考资料。第十一章则通过一个精妙的案例展开教学:三种完全不同的数据库故障在链路追踪里呈现为同一个span,作者演示了如何在不改太多代码的情况下扩展埋点来区分这些故障来源,这种来自真实生产环境的经验判断是规范文档给不了的。OpenTelemetry治理委员会的Trask Stalnaker为这本书作序,他对书中所体现的工程严谨性给予了高度评价,称其是规范标准在真实服务中"以设计核心而非事后补丁"姿态运作的典范。两位作者都是资深从业者,曼朱纳特在Mastercard领导R&D团队,拥有近二十年横跨SaaS、金融科技和区块链的系统架构经验,目前专注于高性能系统与大规模可观测性;拉杰库马尔则是Microsoft的首席软件工程师,在Azure Monitor团队负责遥测SDK和诊断工具的技术战略,也深度参与了AI辅助运维方向的研发。两人既有Java和Python等主流语言的深厚积累,又在Rust生态中做过扎实的工程实践,这让书中关于跨语言观测比较和Rust特有的并发模型分析显得格外有说服力。出版时间是2026年6月,由Packt出版。虽然OpenTelemetry生态一直在快速演进,但本书强调的是以供应商中立的方式搭建可观测性基础设施,使用Jaeger、Prometheus、Grafana、Loki这些主流开源组件组合出一套完整的管道,这种设计思路的通用性使得书中的方法论不会轻易过时。对于正在用Rust构建后端服务的中高级工程师、负责生产环境稳定性保障的SRE和平台工程师,以及想要系统理解OpenTelemetry规范及其落地方式的技术负责人来说,这是一本值得花时间认真读的技术书。它不适合完全没接触过分布式系统的新手,但如果你已经在写Rust或者在维护线上服务,并且对"为什么我的系统慢了"这类问题感到头疼,那这本书里的案例和排查思路会给你很多启发。建议在下次事故发生之前读完它,这样你还有时间搭建起真正需要的那套信号体系。