资源介绍
视频数量:17个
总时长:4小时15分
课程介绍:
企业级本体工程实战:从Protege到OWL的语义网技术精讲
一家医院的电子病历系统里,"心梗""心肌梗死""急性心肌梗塞"可能是同一个诊断;药品表里"对乙酰氨基酚""扑热息痛""泰诺"指代的是同一种成分。当数据散落在几十个业务系统里、术语各说各话的时候,光靠传统的数据库查询根本挖不出有用的知识。本体工程要解决的就是这个问题——教机器像人一样理解概念、关系和语义。
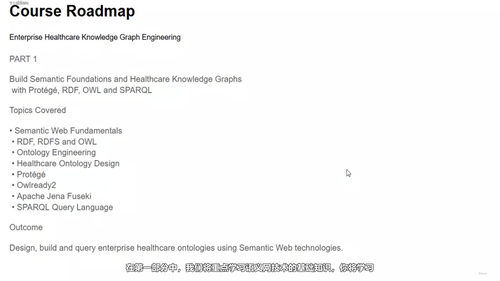
这门课围绕一个完整的医疗健康知识图谱展开,从最基础的知识表示讲起,一直走到可以落地使用的企业级应用。四个多小时的内容分成八个模块,加上大量的动手实践视频,每一个概念都有对应的实战场景。
一、知识表示的根基
课程先花时间讲清楚一个核心问题:人和机器理解世界的方式有什么不同。数据、信息、知识、智慧这四层金字塔到底意味着什么?为什么传统的关键词搜索无法回答"列出所有用于治疗高血压的钙通道阻滞剂"这类问题?理解了这些,你才能明白语义技术存在的意义,而不是简单地把数据换个存储格式。
二、RDF数据模型
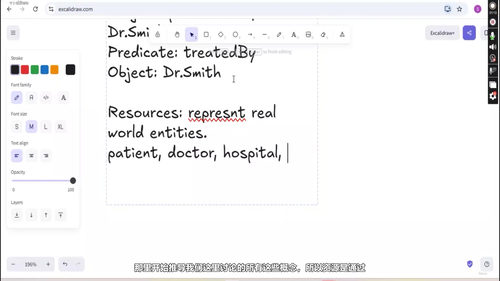
这是整个语义网的基石。主讲人会带你理解"主语-谓语-宾语"这种三元组结构为什么如此强大——世间万物之间的关系本质上都可以用三个元素来描述。课程涵盖了多种序列化格式,包括Turtle、RDF/XML、JSON-LD、N-Triples,每种格式适合什么场景、性能差异如何,都会讲到。课程还提供了SPARQL和Cypher的速查手册,方便随时查阅。
三、RDFS与OWL:让数据拥有真正的语义
RDF只是把数据串起来,但要说清"子类继承""属性约束""等价关系",就需要RDFS和OWL登场。课程会演示如何用Protégé这个业界标准工具来定义类、对象属性、数据属性、函数性约束、不相交关系等。你会看到真实的本体设计例子,理解每个建模决策背后的考量,比如什么时候用SomeValuesFrom限制,什么时候直接定义子类更合适。
四、SPARQL查询语言
数据建好了,怎么查?SPARQL是W3C推荐的标准查询语言,语法跟SQL有相似之处,但思维方式完全不同。你会学到基础查询模式、OPTIONAL匹配、UNION联合查询、FILTER过滤、联邦查询跨数据集访问等核心技能。课程还会介绍一些常用函数和操作符的实际用法。
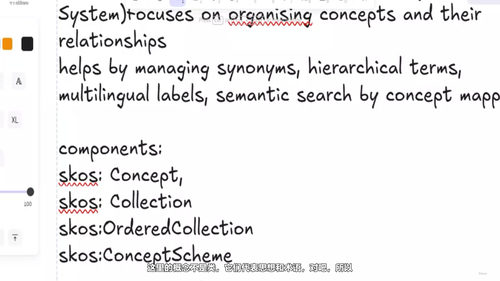
五、SKOS分类体系
医疗领域有大量的术语标准——ICD-10疾病分类、LOINC检验项目、ATC药品编码、SNOMED CT临床概念。课程会讲SKOS如何帮我们把这些标准词表组织起来,建立概念之间的广义、狭义、相关关系。这是构建大型本体时绕不开的工具。
六、本体设计模式
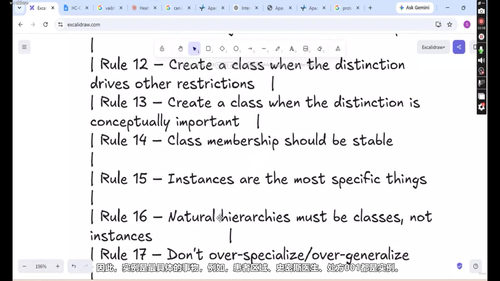
这是课程特别强调的部分。一个好的本体应该是可重用、可扩展、可维护的。主讲人会分享自己多年积累的设计经验:什么样的属性应该提升为类、什么情况下用逆属性、什么时候用owl:Thing作为父类、如何避免常见的建模陷阱。这部分内容的价值远超教程本身,更像是经验传承。
七、动手实践环节
课程安排了六个动手实践视频,从零开始一步步构建一个医疗本体。每个类、每条关系、每个约束的添加都有详细解释和设计理由。主讲人会打开Protégé,一步步演示命名空间配置、类层次搭建、属性定义、推理测试等流程。最后还附有一个医疗本体的实验手册供练习。
八、毕业项目与拓展方向
课程最后设置了毕业项目,让你把前面学到的所有东西串起来,独立完成一个端到端的本体设计。讲讲者会介绍后续进阶方向,包括如何用Python操作RDF数据、如何用Apache Jena搭建推理服务、如何对接Neo4j做图查询、如何把本体嵌入到大模型应用中实现自然语言到SPARQL的转换等。
整门课适合正在做知识图谱、企业数据治理、医疗信息化或者在探索大模型与结构化知识结合的开发者。如果你是语义网领域的新手,之前只听过RDF和OWL这些名词但没真正动手做过,这门课会很合适。当然,如果你已经在做相关项目,把它当作一次系统梳理和查漏补缺也完全没问题。课程每个模块都附带了复习要点和常见面试题,无论是想上手实操还是准备面试,都能用得上。
学完这门课,你会掌握用Protégé设计本体的完整流程,理解语义技术栈每一层的角色和价值,并且能够独立构建一个可用于生产环境的领域知识图谱。这些能力在企业数据整合、智能搜索、AI应用开发等场景中都能直接派上用场。