资源介绍
视频数量:22个
总时长:1小时38分
课程介绍:
拆开黑箱:生成式AI与大语言模型的底层原理
你有没有过这样的时刻:打开ChatGPT或者类似的AI工具,输入一行字,几秒钟后屏幕上就出现一段流畅的回答,甚至是一幅像模像样的图片。这个过程看起来就像变魔术——你给它一个提示,它给你一个结果。但你有没有想过,中间到底发生了什么?
作为开发者,如果只是把AI当作一个黑箱来用,迟早会遇到瓶颈。你会不理解为什么同样的提示有时效果好有时差,不清楚怎么调整参数才能得到想要的结果,更没法在应用中做出超出基础调用的设计。这门课的目的,就是帮你把这个黑箱拆开,看看里面到底是哪些零件在运转。
讲课的是Laurence Moroney,他在AI工程领域深耕多年,一直在做一件事:把复杂的概念翻译成开发者能听懂的语言。这门课总时长不到两小时,但信息密度很高,它不会在数学推导上纠缠太久,而是帮你建立一套扎实的心智模型,让你知道每一步在做什么、为什么这样做。
一、从历史脉络说起
课程先帮你理清生成式AI的来龙去脉。"生成"这个词到底意味着什么?它和传统的分类、回归任务有什么本质区别?课程会带你从早期的n-gram语言模型一路走到今天的foundation model,让你明白技术是怎么一步步演化到现在的形态。理解了这些背景,后面遇到很多概念就不会觉得突兀。
二、文字是怎么变成数学的
这一部分特别关键,也是很多开发者的知识盲区。计算机不直接处理文字,它处理的是数字。那模型是怎么理解"你好""今天天气不错"这些字符串的呢?
课程从最基础的分词讲起:为什么需要把句子切分成token,而不是直接按字符处理?切完之后,又怎么把这些整数映射成有意义的向量?这就引出了embedding的概念。课程不会停在"embedding就是把词变成向量"这种抽象说法上,它会用直觉化的方式解释向量空间是怎么回事——为什么"国王减去男人再加上女人"会接近"女王",这种例子会让你对高维空间里的语义关系有直观感受。
还有一个经常被忽略但很重要的细节:位置编码。因为Transformer处理的是一组向量,它本身不知道哪个词在前哪个词在后,位置编码就是教会模型"顺序"这个概念的技巧。
三、注意力机制与Transformer
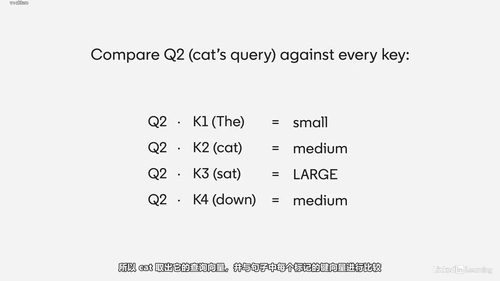
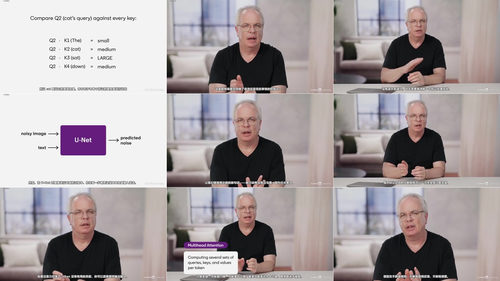
这是整门课的核心,也是最烧脑的部分。讲师用了一种很巧妙的方式来拆解:先用日常语言解释注意力到底在解决什么问题——一个词的含义往往取决于它的上下文,比如"bank"在河边和银行里意思完全不同。然后再一步步走到self-attention的具体计算逻辑、multihead attention的设计思路,最后把整个Transformer block的全貌拼出来。
这部分学完,你会明白为什么Transformer能成为现代AI的基石,它和RNN、CNN这些老架构相比,优势到底在哪。
四、训练与文本生成
一个训练好的模型是怎么吐出文字的?课程会解释next-token prediction这个训练目标——说白了就是让模型学会"根据前面出现的词,猜下一个最可能的词"。但这里面有很多门道:采样策略不同,生成结果的质量和多样性会有天壤之别。贪心解码、top-k、top-p这些常见参数到底怎么影响输出,课程都会讲到。
另外,你可能会好奇:基础模型是怎么变成ChatGPT这种能对话的助手的?这就涉及到fine-tuning和RLHF(基于人类反馈的强化学习)的过程。课程用简洁的方式说清楚这两步在做什么、为什么缺一不可。
五、扩散模型与图像生成
文本讲完之后,课程把目光转向图像。但讲师没有简单地说"扩散模型就是另一种生成方法",而是先带你分析:为什么Transformer那套逐像素预测的思路在图像上行不通?一张512乘512的图片有26万像素,逐个生成既慢又难以保证全局一致性。
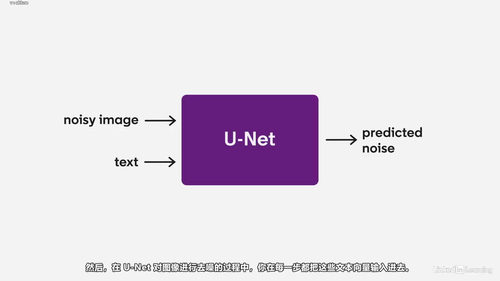
然后引出扩散模型的核心思想:与其从零生成,不如从噪声中"去噪"。U-Net在这个过程中扮演什么角色?文生图模型是怎么用文字引导去噪方向的?Stable Diffusion为什么速度够快,因为它不是在像素空间操作,而是在latent空间里处理。这些概念讲完,你会对Midjourney、Stable Diffusion这些工具背后的技术有全新的认识。
六、收尾与下一步
最后两节把前面所有内容串起来,形成一个完整的知识图谱,然后给出进一步学习的方向建议。
这门课适合谁?如果你是一名开发者,已经在工作中用过ChatGPT的API或者集成过一些AI功能,但一直停留在"调接口"的层面,想要真正理解底层在做什么,那它就是为你准备的。数学基础不是必须的,高中数学水平配合一些编程直觉就够了。课后你会拥有一套清晰的框架,以后看任何新的AI模型、论文或者工具,都能迅速找到它在整个技术版图中的位置,而不是每次都被新名词砸晕。