资源介绍
翻开这本书的时候,我其实有点犹豫——书名里"Utility-Based Learning"这个组合看起来有些生僻,什么是从数据中进行基于效用的学习?但读完之后我发现,这本书做的事情远比名字听起来要直觉得多。作者想解决的核心问题是:当我们在用数据训练模型的时候,模型的好与坏究竟应该由谁来定义?传统的统计学习方法往往依赖于似然函数、信息准则或者预测精度这些指标,而弗里德曼和桑多提出了一种全新的思路:借鉴金融学和经济学中成熟的效用理论框架,把"模型对决策者到底有多有用"作为衡量模型优劣的根本标准,而不是只看模型本身在数学上有多漂亮。
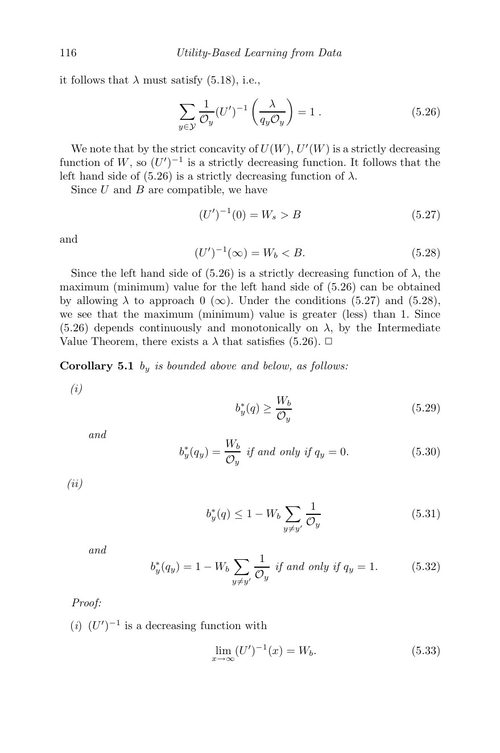
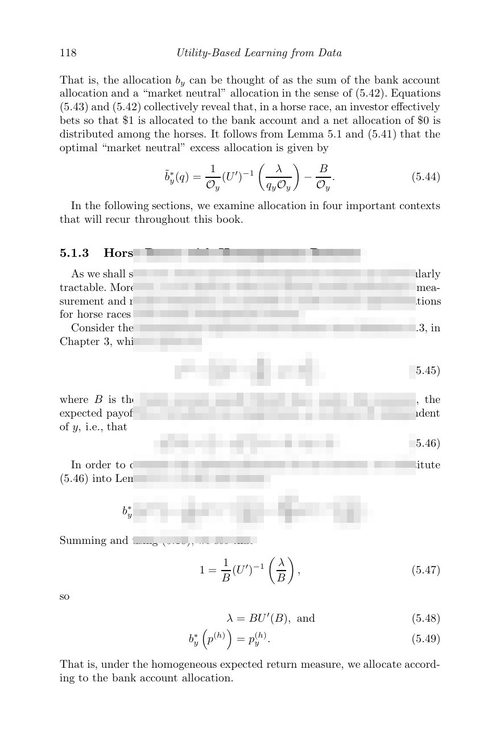
整本书的结构非常清晰,前面两章把需要的数学工具铺得扎扎实实,从概率论基础到凸优化再到熵与相对熵,作者都一一过了一遍,照顾到了那些可能不是数学科班出身但想啃下这本书的读者。第三章讲的是著名的"赛马问题",其实就是凯利准则那一套——投资者面对一匹匹马,把资金分配到不同马匹上,让财富的预期增长率最大化。这个问题看似简单,但它实际上是全书的一条暗线,因为后面几乎所有的模型选择和参数估计思想,都可以从赛马问题的逻辑里自然推导出来。第四章正式进入效用理论,从圣彼得堡悖论讲起,把公理化体系、风险厌恶、各种常见的效用函数一一梳理清楚。到第五章,前两章的工具开始合流,用效用函数的视角重新审视赛马问题中的资金分配,这时候读者会突然意识到,前面那些看似各自独立的概念其实是一套完整的体系。
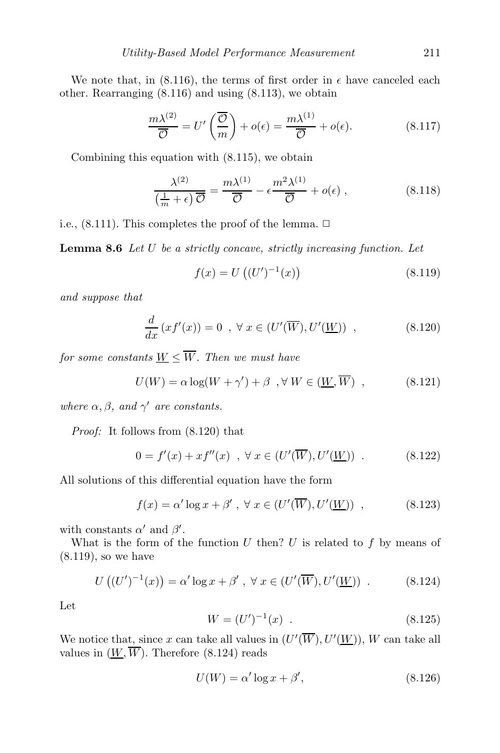
这本书最打动我的地方,是它把金融学里的风险管理和机器学习里的模型估计放在了同一个理论框架下。作者反复强调,模型估计不是一个纯粹的统计问题,而是和"这个模型最终会被怎么用"紧密相关的。如果你的模型是用来做金融决策的,那你就需要一个能反映投资者真实偏好的效用函数来评判模型;如果你的模型是用来做分类预测的,那又有另一套效用考量。这种"目的导向"的建模思想,在大多数机器学习教科书里是看不到的。书中还详细讨论了完全市场与不完全市场的区别,并提出了一套基于模型表现度量的参数估计原则,顺带把信息论里的那些经典方法和效用理论视角下的方法做了对比,让人读完之后有一种豁然开朗的感觉。
从适用人群来说,这本书适合那些已经在机器学习或统计学领域有了一定基础,想要进一步拓展视野的研究者和高级数据科学从业者。尤其推荐给做量化金融、信用评分或者风险建模的朋友,因为这本书的案例和思路和这些领域天然契合。当然,如果你只是对效用理论或者凯利准则本身感兴趣,这本书也能提供一份扎实且系统的讲解。出版方面,本书属于Chapman & Hall/CRC的机器学习与模式识别丛书,由Ralf Herbrich和Thore Graepel担任系列主编,2011年由Taylor & Francis集团正式出版。对于想要在机器学习和决策理论交叉地带做点深入研究的读者来说,这是一本值得放在案头反复翻阅的书。