资源介绍
视频数量:33个
总时长:3小时9分
课程介绍:
CUDA与PyTorch深度学习加速实战课
你有没有过这样的经历?辛辛苦苦搭好了一个神经网络,训练数据也不算大,但每次跑起来都要等上半天甚至好几天。改完参数想验证一下想法,结果咖啡都喝完了三轮,模型还没收敛。这不是你代码写得烂,很可能是你还没让GPU真正发挥出它该有的威力。
这门课就是来解决这个问题的。AI工程师Otman会带着你从零开始,理解GPU和CUDA到底是怎么一回事,然后亲手写出能跑在GPU上的高性能深度学习代码。整个课程虽然只有三个多小时,但内容非常扎实,从原理到实践再到完整的项目优化,一步步带你把训练速度提上去。
一、为什么深度学习离不开GPU
课程一开始不会急着让你写代码,而是先帮你把基本概念搞清楚。你会看到CPU和GPU在处理任务时的根本差异:CPU像是一个什么都能干但一次只能干一件的工匠,GPU则是成千上万个简单工人同时开工。深度学习里的矩阵乘法和卷积运算天然就适合并行处理,GPU在这方面的优势几乎是碾压级的。Otman还会讲到什么时候该上CUDA、什么时候其实没必要硬上GPU,帮你建立正确的判断力,避免踩坑。
二、搭建你的CUDA运行环境
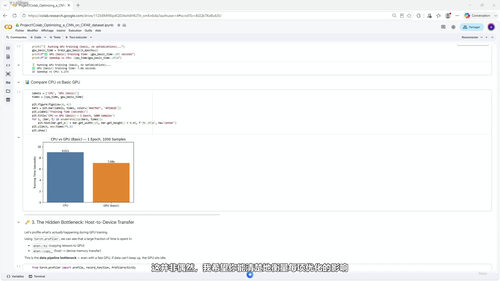
搞清楚原理之后,接下来就是动手环节。课程会教你三种搭建CUDA开发环境的方式:本地Windows机器、Google Colab云端、Kaggle平台。本地开发适合长期项目,云端平台适合临时跑实验,课程里都有详细演示。你会亲手安装支持GPU的PyTorch,然后在本地或云端训练一个最简单的神经网络,对比CPU和GPU的运行时间。虽然只是个小实验,但那种看到训练时间从几分钟缩短到几十秒的快感,会让你立刻明白为什么要学CUDA。
三、CUDA编程的核心概念
这是整门课最硬核的部分。你会学到CUDA编程模型里的核心概念:主机和设备的区别、线程、线程块、网格的组织方式、线程索引的计算方法。这些听起来很抽象,但课程通过向量加法这个最简单的例子,带你一步步写出第一个真正的CUDA内核函数。你会动手实现向量加法的并行版本,理解数据是如何被拆分成无数小任务同时在GPU各个核心上跑起来的,然后把线程、块、网格的概念真正用到代码里,搞清楚索引计算为什么那么重要。几个动手实验跟下来,你会对并行编程有一个非常具体的认知。
四、性能分析和瓶颈定位
代码能跑起来只是第一步,跑得快才是关键。课程会教你用PyTorch Profiler和Tensorboard来分析模型的性能瓶颈。你会发现很多时候你以为GPU在满负荷运转,其实它在等数据;你以为训练慢是因为模型太大,其实瓶颈在主机和设备之间的数据传输上。Otman还会介绍命令行监控工具和Nvidia Nsight Profiler,这些都是业界常用的性能分析利器,学会它们,以后优化任何深度学习模型都有了一套系统方法论。
五、PyTorch与CUDA的深度结合
这一部分把CUDA知识和PyTorch框架结合起来。你会学到怎么用PyTorch调用CUDA功能,怎么管理GPU内存,怎么把神经网络和数据搬到GPU上。课程里有多个实验,从最简单的张量操作到完整的神经网络训练和性能分析,帮你建立完整的工作流。
六、三个完整的实战项目
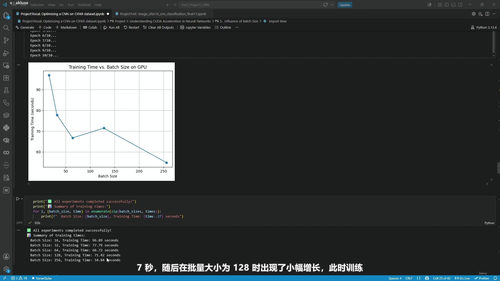
课程的精华是最后三个实战项目。第一个项目是在CIFAR数据集上加速一个卷积神经网络,你会从最基础的GPU加速开始,然后逐步引入各种优化技巧:固定内存和异步传输减少通信开销,数据预取让GPU永远有活干,调整批量大小找到吞吐量甜点,多进程数据加载避免数据准备成为瓶颈,最后引入自动混合精度训练(AMP),在保持精度的同时大幅提升速度。第二个项目是把MobileNet加速到适合嵌入式设备做计算机视觉,第三个项目则是分布式训练的入门教程,包括数据并行和模型并行的区别以及基本实现策略,为后续学习大模型训练打下基础。
学完这门课你会获得什么?你不再是一个只会调用PyTorch接口的使用者,而是一个真正理解GPU工作原理、能写出高性能训练代码的工程师。你会知道怎么分析性能瓶颈、怎么用各种技术手段把训练速度提上去、怎么在合适场景下选择合适的并行策略。这些能力在如今动辄几十亿参数的大模型时代,几乎是必备的硬技能。适合谁来学?如果你已经会用PyTorch训练基本神经网络,但苦于训练速度太慢,或者你想真正搞懂GPU和CUDA是怎么工作的,这门课就是为你准备的。不需要有CUDA基础,但最好有一点点Python和深度学习的经验。