资源介绍
视频数量:20个
总时长:5小时33分
课程介绍:
CUDA并行编程实战:从硬件原理到GPU加速应用
想象一下这样的场景:你的机器学习模型训练需要等好几个小时,科学计算模拟跑一遍要花掉半天时间,图像处理程序在CPU上一个像素一个像素地处理高清图片,效率低得让人心焦。这时候,你是否想过让GPU那成千上万个核心替你干活?
这正是CUDA技术存在的意义。CUDA是NVIDIA推出的并行计算平台和编程模型,它让开发者能够直接调用GPU的算力来解决那些计算密集型任务。这门课总共5小时33分钟,分成20个视频,从最基础的概念讲起,一直深入到实战优化技巧,不管你之前有没有GPU编程经验,都能找到适合自己的切入点。
一、CUDA入门与实战小项目
课程的第一部分从三个精心设计的小项目开始,帮助你建立直观的GPU编程感觉。
第一个项目是用CUDA C/C++实现GPU编程。你会从零开始编写一个矩阵乘法程序,亲身体验一个线程算一个输出元素的并行思维。有趣的是,课程一开始就提出了一个引人深思的问题:既然用Eigen库一行代码就能搞定矩阵乘法,CUDA的优势到底在哪里?答案是性能,当矩阵规模变大、CPU实现开始吃力时,GPU的并行优势就会显现出来。你还会学到CPU和GPU协作的基本模式:CPU负责调度和数据准备,GPU负责密集计算,最后结果再回到CPU。
第二个项目聚焦NVIDIA Tensor Cores,这是在AI领域大放异彩的专用硬件单元。Tensor Cores专门为矩阵运算设计,能在极短时间内完成深度学习中的关键计算。你会了解到如何编写代码调用这些特殊硬件,让GPU在AI推理和训练任务中发挥最大威力。
第三个项目是CUDA图像滤镜。在这个项目里,你会学到GPU缓存和常量内存的实际应用。图像处理天生适合并行,每个像素可以独立处理。但如何高效地访问纹理数据?如何让多个线程共享查找表之类的常量数据?这些实际工程问题在这个项目里都会得到解答。
二、CUDA C基础:硬件架构与矩阵乘法优化
这部分是整个课程的核心基石,包含四个循序渐进的技术点。
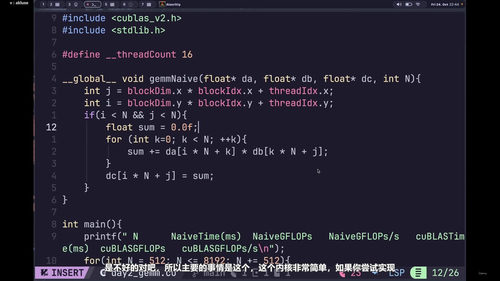
首先,你会在GPU上实现一个简单的矩阵乘法。这听起来基础,但它是理解GPU并行编程模型的入口。每个线程被分配一个输出元素,通过计算输入矩阵对应行和列的点积来得到结果。这个朴素实现虽然正确,但远没有发挥GPU的全部潜力。
接下来,课程会带你深入了解NVIDIA GPU的硬件架构。理解硬件是写出高效CUDA代码的前提。你会学到线程是如何以网格、线程块、warp的层级方式组织的,以及GPU内部的内存层次结构(寄存器、共享内存、L1/L2缓存、全局内存)是如何影响程序性能的。这些知识看起来偏理论,但后续的每一个优化技巧都建立在这个基础之上。
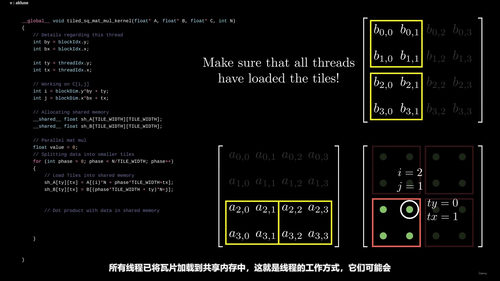
第三个视频会教你一个让人眼前一亮的优化技巧:内存合并。课程标题说两个变量的改动就能提速4.5倍,这不是夸张。当你了解了线程访问内存的规律后,只需要调整线程索引的计算方式,就能让原本分散的内存访问变成连续的突发传输,性能提升立竿见影。然后是分块矩阵乘法,这是CUDA编程中必学的核心技术。通过将大矩阵分成小块加载到共享内存中,可以大幅减少全局内存访问次数,从而显著提升性能。
三、Python CUDA编程:用CuPy和Numba快速上手
很多数据科学家和Python开发者不愿意碰CUDA,是因为觉得C/C++门槛太高。这部分内容就是为你们准备的。
课程会教你用CuPy库进行GPU加速编程。CuPy的API设计与NumPy高度相似,如果你熟悉NumPy,几乎可以无缝迁移到GPU上计算。几个import的改动,就能让你已有的Python科学计算代码获得GPU加速。
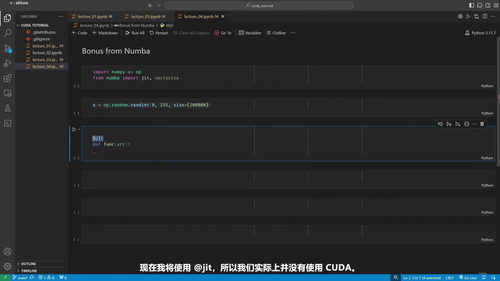
然后是Numba的CUDA支持。Numba允许你用Python语法编写自定义的CUDA核函数,通过简单的装饰器就能把普通函数标记为GPU可执行的核函数。课程会从一个最简单的例子开始,让数组的每个元素加1,然后逐步深入到设备端和主机端的数据传输、grid和block的配置、线程索引的计算等核心概念。对于Python生态的从业者来说,这部分内容打开了GPU加速的大门。
四、CUDA C进阶:共享内存、原子操作与归约
掌握基础之后,课程进入更高级的主题。
第一个视频是CUDA编程基础中的经典内容:Hello World和向量加法。虽然Hello World在GPU上看起来有点搞笑,但向量加法是一个非常完整的入门示例,涵盖了内存分配、数据传输、核函数启动等CUDA编程的全部基本流程。
接下来,你会对比朴素矩阵乘法和cuBLAS库的性能。cuBLAS是NVIDIA高度优化的基础线性代数库,通过这个对比,你不仅能看到自己写的代码和专业库之间的性能差距,更能理解从哪些方向去优化。
然后是分块矩阵乘法和共享内存的深度讲解。共享内存是GPU上的高速缓存,每个线程块内的线程可以共享其中的数据。合理使用共享内存,是CUDA性能优化的关键之一。课程会详细演示如何用共享内存实现高效的分块矩阵乘法。
最后是原子操作、归约和Warp Shuffling。原子操作允许多个线程安全地访问同一内存位置,归约是把一组数据通过某种操作压缩成一个值的并行算法,而Warp Shuffling则是线程束内线程之间直接交换数据的指令。掌握这些技术,你就能写出更复杂、更高效的并行算法。
五、GPU架构深入:占用率与实战练习
最后一部分聚焦于更深层的架构理解和实战训练。
第一个视频讲解GPU架构和占用率。占用率指的是GPU上活跃线程数与最大可能线程数的比例,它直接影响着GPU硬件资源的利用效率。课程会告诉你哪些因素会影响占用率,以及如何在实际编程中权衡这些因素。
然后是PMPP(Programming Massively Parallel Processors)第四章的习题实战。这本书是CUDA编程的经典教材,通过亲手解决其中的练习题,你能巩固之前学到的所有概念。
接下来是内存合并、DRAM突发传输和矩阵转置的专题。课程会从DRAM的工作原理讲起,解释为什么合并访问能提升带宽利用率,并以矩阵转置为典型场景,展示优化内存访问模式的技巧。
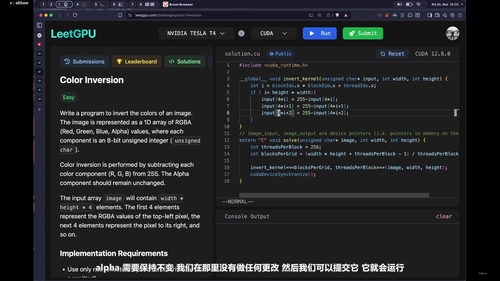
最后,课程会在LeetGPU平台上做几道练习题收尾。LeetGPU是一个专门练习GPU编程的在线平台,通过解决实际问题来检验学习效果。
适合哪些人来学?如果你是在做机器学习或深度学习,希望理解底层加速原理的研究者;如果你是在做科学计算或仿真模拟,被CPU计算速度困扰的工程师;如果你是对高性能计算感兴趣,想掌握一门硬核技能的程序员,这门课都适合你。唯一的前提是你需要一块支持CUDA的NVIDIA显卡,以及基础的C或Python编程经验。
学完这门课,你不仅会写出能跑的CUDA程序,更会理解为什么有的写法快、有的写法慢,掌握从硬件架构出发优化并行代码的系统方法。这些技能在AI时代越来越值钱,因为GPU就是AI的基础设施。