资源介绍
视频数量:16个
总时长:3小时7分
课程介绍:
基于Python的知识图谱工程实战
想象一下这样的场景:一位医生打开系统,输入"有哪些药物会与青霉素产生交叉过敏反应",系统没有返回一堆零散的网页链接,而是给出了一张清晰的关系网络——药物名称、过敏原分类、患者群体、临床试验数据,全部以结构化的方式呈现。这不是科幻电影里的画面,而是知识图谱技术正在落地的真实场景。
这门课的核心,是带你从零开始搭建一个完整的医疗知识图谱平台。不是简单画几张图,而是用Python和一系列企业级工具,把一个医疗本体文件变成可以被自然语言查询的智能系统。
一、技术栈全景
课程用到的技术栈相当丰富,但讲师会一步步带你走过去。主线是Python,但围绕一条清晰的工程链路展开:用Protégé和OWLready2处理本体文件,用RDFLib读取和操作语义数据,通过Apache Jena执行SPARQL查询,最终把数据导入到Neo4j图数据库,用Cypher语言进行图查询。后端用的是FastAPI,一个现代的Python Web框架。整个项目会被Docker化,方便部署和迁移。
二、课程内容详解
第一部分先讲清楚为什么语义技术在这个时代变得重要。传统的聊天机器人只能做模式匹配,但基于知识图谱的智能体能够理解概念之间的深层关系。本体定义了领域的概念体系,RDF描述了数据之间的关联,OWL提供了推理能力——这些不是空洞的概念堆砌,而是有具体技术支撑的。
第二部分带你熟悉项目的GitHub仓库结构。模块化、可扩展的代码组织方式,对于真正想在企业里落地项目的同学来说非常重要。
第三部分是系统设计。讲师详细讲解整个平台的架构——从前端请求到后端处理,再到数据库查询,最后返回结果。每一个组件的作用、它们之间的通信方式,都会有交代。
第四部分开始进入实战:RDF到属性图的转换。这一步很关键,很多企业既有语义Web技术栈,又有图数据库技术栈,两者之间的桥接是真实工程中经常会遇到的问题。课程教你用rdflib读取本体,把个体、数据属性、对象属性转换成Cypher语句,再插入到Neo4j中。
第五部分讲怎么通过Python文件生成本体,并向已有的本体中添加新的个体。这部分让你摆脱对Protégé图形界面的依赖,用代码方式管理本体——在大规模项目中这是刚需。
第六部分是加载本体到Neo4j图数据库。具体怎么把OWL文件里的结构映射到Neo4j的节点和关系,同时保留属性信息,这一节会讲透。
第七、八部分是API接口设计和图数据导出。涉及到REST API设计规范、数据序列化、错误处理、日志记录等实战细节。
第九部分很有意思:用嵌入服务实现自然语言查询。这一步会用到向量索引和语义搜索技术,让用户可以用自然语言提问,系统自动理解意图并检索相关实体。
第十、十二部分是课程的精华所在:自然语言到SPARQL、Cypher的转换。比如问"列出治疗高血压的所有药物",系统会先把它转换成SPARQL或Cypher查询,再去图数据库里跑出结果。非技术用户也能直接用日常语言和知识图谱对话。
第十三部分讲SHACL验证。数据质量是图谱项目的生命,这部分教你怎么定义数据形状约束,自动检测图谱中不符合规范的数据。
第十四部分是可观测性和部署。Docker化、CI/CD流水线、日志聚合、配置管理——这些是把项目从"能跑"变成"能上线"必须解决的问题。
三、适合什么人
如果你是计算机相关专业的在校学生,对知识图谱感兴趣但不知道从哪里下手,这门课会给你一个完整的企业级项目案例,帮助建立工程化思维。
如果你是后端工程师,想拓展到AI和语义技术领域,课程里的FastAPI集成、Neo4j操作、自然语言到查询的转换,都是可以直接复用到工作项目中的实战技能。
如果你是数据工程师或知识管理从业者,本体工程、SPARQL查询、SHACL验证这些内容会帮你构建更严谨的数据治理体系。
如果你是创业者或产品经理,想了解知识图谱在医疗、金融、零售等领域的落地路径,这个项目架构可以直接作为参考模板。
四、学完能收获什么
课程只有三个多小时,但信息密度很高。你不会花时间听那些脱离代码的抽象讨论,每一节都在写代码、跑命令、看结果。
学完整个课程,你会得到一个能跑起来、能部署的完整项目。GitHub仓库里有所有源码,你可以直接拿来改,改完部署到自己的环境里。更重要的是,你会理解整个流水线的设计思路——从本体文件到自然语言接口,中间经历了哪些转换、为什么要做这些转换、每一步有哪些坑。
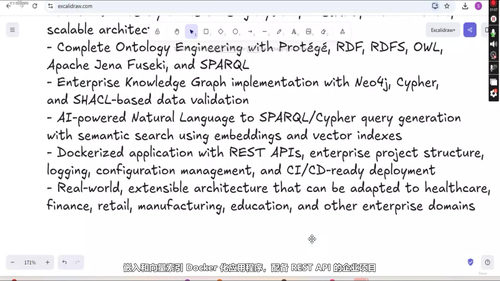
这套架构不限于医疗领域。讲师在课程里也提到,金融、零售、制造、教育都可以用类似的方式搭建知识图谱平台。掌握了这套方法论,你可以把它迁移到任何垂直行业。
三个多小时,十六节课,一套完整的代码,一套清晰的工程思路。如果你一直在找一个能把语义技术真正落到代码里的课程,这门课值得认真学一遍。