资源介绍
视频数量:14个
总时长:1小时8分
课程介绍:
数据仓库核心知识与求职面试实战课
你有没有过这样的经历:面试官问起"解释一下星型模式和雪花模式的区别",脑子里明明背过答案,一到嘴边却说不清楚?或者看到JD上写着"熟悉数据仓库架构、维度建模",不知道这些概念到底在真实业务里怎么用?数据仓库这个领域,说它难吧,其实核心概念就那么几个;说它简单吧,真正能讲明白、讲出深度的人还真不多。市面上的资料要么太学术,满篇公式和术语让人望而却步;要么太浅显,只讲定义不讲应用,看完仍然不会回答实际问题。这门课就是想解决这个痛点——用一小时出头的紧凑时间,把数据仓库面试和工作中最高频出现的知识点掰开了揉碎了讲清楚。
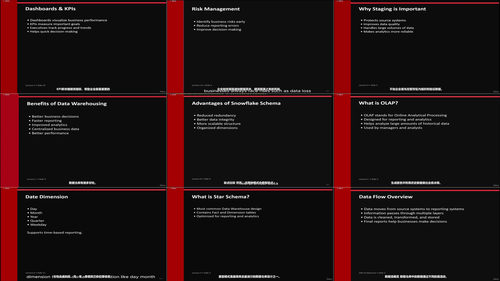
整个课程按照学习的自然逻辑分成七个部分,从最基础的概念出发,一路走到企业级的治理与安全。不管你是刚接触数据分析的新人,还是准备跳槽面试想快速复习的从业者,跟着这个顺序走下来,心里会特别踏实。
一、课程导览与数据仓库基础
第一部分是课程总览,先帮你建立全局认知。很多人对数据仓库的第一反应是"不就是个大数据库吗",这个理解其实偏差很大。课程会先讲清楚数据仓库到底是什么——它是专门为企业分析和报表需求而设计的数据存储系统,和我们日常用的业务数据库(也就是OLTP系统,在线事务处理系统)有着本质区别。OLTP系统处理的是日常交易,比如下单、付款、修改用户信息,追求的是快速响应和并发处理能力;而数据仓库面向的是分析场景,要把分散在各业务系统中的数据汇聚起来,支持复杂查询和多维度分析。课程会用具体的例子告诉你两者的差异,比如电商系统中订单写入和"上个月各品类的销售趋势分析"完全是两种截然不同的数据处理需求。通过这部分内容,你会明白为什么企业需要单独搭建数据仓库,而不是直接在业务数据库上跑报表。
二、数据仓库架构全景
搞清楚数据仓库是什么之后,接下来就要看它长什么样了。数据仓库的架构看似复杂,其实有一条清晰的链路:源系统、数据采集层、暂存区、数据清洗、BI展示层。课程会一步步带你走完这条链路,理解数据从各个业务系统出发,经过怎样的处理和加工,最终变成管理者在仪表板上看到的那些图表。这个过程中你会学到为什么需要"暂存区"(Staging Area)——它就像一个临时中转站,让原始数据先落地再做处理;为什么需要数据清洗——因为源系统的数据往往有缺失、有重复、格式不统一;BI层又是如何把整理好的数据呈现给最终用户的。学完这部分,你对数据仓库的理解会从"一个模糊的大盒子"变成"一条清晰的数据流水线"。
三、星型模式(Star Schema)
星型模式是数据仓库建模中最经典、最常用的方式,也是面试必考题。课程会先介绍星型模式的整体结构——它由一张事实表和若干张维度表组成,形状看起来像一颗星星:事实表在中间,周围环绕着维度表。事实表存的是什么?是业务事件的度量数据,比如销售额、订单数量、交易笔数,每一行代表一个业务事件。维度表存的是什么?是描述性的上下文信息,比如时间、地区、产品、客户,用来回答"什么时候""在哪里""卖了什么""卖给了谁"这类问题。
学完基本结构,课程会重点讲"为什么星型模式查询快"。这个问题的答案涉及数据库的查询优化原理——星型模式的结构使得查询可以高效地利用索引,减少表连接的次数,相比高度规范化的数据库结构,分析性能会有质的提升。这个"为什么快"的解释在面试中经常被追问,课程会帮你把背后的原理彻底搞明白,而不是只背一句"因为结构简单所以快"。
四、雪花模式(Snowflake Schema)
讲完星型模式,自然要讲它的"兄弟"——雪花模式。雪花模式是星型模式的进一步规范化:维度表不再像星星那样平铺开来,而是被拆分成多个相关联的小表,形成一种层层展开的雪花状结构。比如产品维度会被拆成产品表、品类表、品牌表,通过外键关联。
课程会详细讲什么是规范化维度,为什么企业要做这种拆分。核心好处是减少数据冗余:假设你有一万条产品记录,如果每条都重复存储品类名称和品牌名称,会浪费大量存储空间;拆成单独的表之后,品类和品牌信息只存一次,通过ID关联即可。但代价是查询时需要更多的表连接,分析性能会有所下降。
课程会带你对比星型和雪花型的差异,讨论各自的适用场景。在实际面试中,面试官很喜欢问"你会选择哪种模式",课程会帮你建立判断的思路:如果是面向高性能的分析报表,星型更合适;如果对存储效率和数据一致性要求更高,雪花型则更优。
五、缓慢变化维度(SCD)
这一部分是很多数据从业者最容易搞混的地方,也是数据仓库区别于普通数据库的核心特征之一。什么叫缓慢变化维度?简单说,就是维度表中的数据会随时间发生变化,而我们需要决定如何处理这些变化。
课程会用一个非常直观的例子来引入:假如一个银行客户从卡拉奇搬到了拉合尔,我们应该用新地址覆盖旧地址,还是同时保留两个地址的记录?如果保留历史记录,又该用什么样的技术方案?
这就是SCD要解决的问题。课程会介绍SCD的几种主要类型:Type 1(直接覆盖旧值,不保留历史)、Type 2(新增一行记录,保留完整历史)、Type 3(增加列保存上一次的值)。每种类型适用于不同的业务场景。比如客户地址这种需要做历史分析的,通常用Type 2;而像修正拼写错误这种不需要追溯的场景,用Type 1就够了。课程会帮你理解不同类型的取舍逻辑,让你在面试中能根据具体业务需求给出合理的技术选型。
六、数据治理与安全
最后一部分上升到企业级视角,讲数据治理和安全的核心概念。数据治理听起来很"虚",其实和企业里的每个人都息息相关。它解决的是"谁有权看什么数据""数据质量如何保证""数据标准怎么统一"这些实际问题。
课程会介绍数据治理的基本框架,包括数据所有权、数据质量管控、元数据管理等内容。在数据安全部分,会讲解权限控制、数据脱敏、访问审计这些企业里天天在用的安全机制。最后还会讨论数据治理在业务层面的重要性——为什么好的治理能让数据分析更可靠,为什么缺少治理会导致报表数据不一致、决策失误。这些内容不仅在面试中常被考察,进入企业之后也是实际工作中绕不开的话题。
七、学完之后的收获
这一小时的课程走下来,你会获得一个完整的数据仓库知识框架:从基础概念到架构设计,从建模方法到历史数据处理,从技术细节到治理策略。更重要的是,你学会的不只是术语和定义,而是面对真实业务场景时的分析思路和判断能力。
课程的设计初衷就是帮助两类人:一是正在准备数据相关岗位面试的求职者,课程内容覆盖了面试中最常被问到的知识点和最容易踩的坑;二是刚入行或想转行做数据分析、数据工程的朋友,课程用通俗易懂的方式搭建起完整的知识体系,让你不用再在零散的资料里东拼西凑。每章末尾还配有测验题,帮你在学习过程中即时检验掌握程度。一小时不长,但足够让你对数据仓库建立起系统性的认知,在面试和实际工作中都能用得上。