资源介绍
视频数量:17个
总时长:4小时11分
课程介绍:
生成式AI上下文工程入门
你有没有这样的经历:明明给了AI一段很详细的提示,它却答非所问,或者干脆编造了一个听起来特别专业但完全是假的信息?又或者你跟AI聊了好几轮以后,它突然忘了你最开始说过什么,开始自相矛盾?
这些问题,几乎每一个跟生成式AI打过交道的人都遇到过。但很少有人知道,这些问题的根源往往不在AI本身,而在于你喂给它的"上下文"。换句话说,不是AI不够聪明,而是我们给它的信息不够好,或者没有管理好。
这门课讲的就是这件事:如何理解和优化生成式AI系统中的上下文。
一、先把生成式AI搞清楚
在正式聊上下文之前,课程先帮你建立对生成式AI的正确认知。很多朋友对AI的判断停留在"它好厉害"或者"它真不行"两个极端,但真实的AI既不是万能的神,也不是一无是处的玩具。
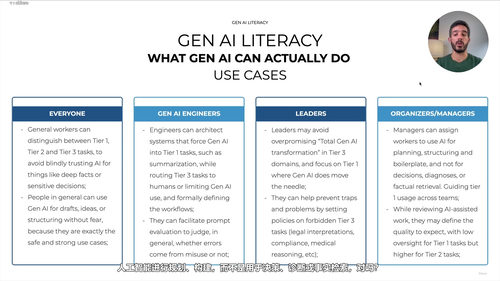
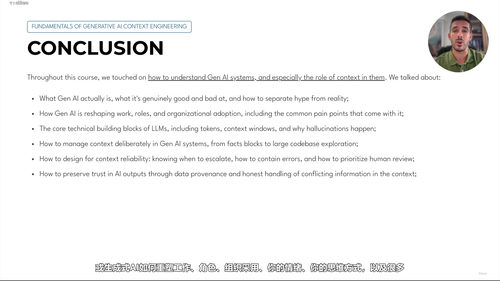
你会学到AI真正擅长做什么、不擅长做什么。课程会把炒作和现实分开来讲,比如AI在内容生成、模式识别方面的优势,以及在精确计算、事实核查方面的短板。你还会了解AI正在如何改变工作方式、岗位角色和组织内部的采用方式。这意味着,学这门课不只是学技术,也是理解一场正在发生的职业变革。
接下来是技术基础的部分。你会搞清楚token、上下文窗口这些核心概念到底是什么意思,以及幻觉——也就是AI一本正经胡说八道——为什么会发生。很多人在遇到幻觉时第一反应是"这AI真差",但课程会告诉你,幻觉很大程度上是上下文管理的问题,而不是模型本身的根本缺陷。
课程还引入了一个叫AHEADS的模型框架,帮助你系统性地思考AI在不同场景下的应用方式。这是一个很实用的思维工具,学完以后你在评估任何AI应用场景时都能用得上。
二、上下文层:真正决定AI表现好坏的地方
这是整门课的核心部分,篇幅占了大头。你会学到如何在基于云的AI系统中有效管理上下文,因为云端系统是目前最主流的部署方式,但你学到的所有原则同样适用于本地部署和其他架构。
具体来说,你会搞清楚上下文的底层构成:什么是token数量、信息的提供方式、信息的来源分别是什么。课程会带你分析"中间丢失效应"——也就是AI在长对话中更容易忽略中间部分信息这个现象,以及过长的对话、摘要处理带来的连锁后果。这些问题如果你不提前了解,很可能在你实际工作的时候被绊倒。
然后是错误处理。AI在工作流中出错是必然的,关键是怎么把错误的影响控制住,不让它一路扩散下去。课程会教你"谨慎降级"的实践方法,说白了就是即使发生了错误,系统仍然能维持在可用的水平上运行,而不是彻底崩掉。
如果你的工作涉及大型代码库,这部分尤其值得关注。你会学到针对大型项目的上下文管理策略,以及一些非常具体的、你在别的地方很难看到的实操经验。
三、人工审查与数据治理
AI再强也需要人的把关。课程专门讲了一个容易被忽视但至关重要的主题——什么时候应该让AI停下来,把决定权交回给人类。你会学到升级(也就是把任务转给人工处理)的真实信号是什么,以及那些"看起来对但其实是陷阱"的虚假信号。课程还教你如何分析AI的响应文本,从它的措辞和语气中检测出需要升级的蛛丝马迹,这在实际工作中非常管用。
数据来源和数据冲突是另一个重点。当AI同时使用来自不同来源的信息时,这些信息之间很可能互相矛盾。你需要知道这些数据从哪来、可信度如何,以及当冲突发生的时候怎么判断该信谁。课程提出了"上下文数据治理"(CDG)的概念,这是一个专门为AI系统量身定制的数据管理框架,很多人在别的地方听不到。
课程最后会帮你梳理上下文层的几个关键区分,把前面学的所有内容串起来,形成一个完整的知识结构。
学完这门课,你不会变成AI工程师,但你会有一种"开窍"的感觉——你终于理解了为什么AI总是出各种幺蛾子,以及怎么从上下文这个角度去解决。你会知道怎么设计提示、怎么设置升级机制、怎么防止错误扩散、怎么判断信息的可信度。这些能力,不管你是产品经理、开发者、内容创作者,还是每天都在用AI工具解决问题的普通用户,都非常实用。四小时出头的时间,换一个跟AI打交道的底层思路,这个投入很值。