资源介绍
视频数量:34个
总时长:2小时39分
课程介绍:
Kubernetes网络性能加速:SR-IOV与DPDK全链路实战
想象一下这样的场景:你负责维护一套运行在Kubernetes上的电信平台,每天要承载数千万用户的5G流量。某天业务部门反馈,核心网的用户面功能(UPF)吞吐量始终上不去,延迟高得离谱。应用代码没问题,集群资源也充足,问题就卡在网络这一层——传统的内核网络栈和标准CNI插件在面对每秒数千万包的高吞吐场景时,已经力不从心。
这就是SR-IOV和DPDK存在的意义。这门课会带你从最底层的数据包旅程出发,一步步搞清楚怎么在Kubernetes里把网络性能榨到极限。
一、从一个数据包开始
课程开篇没有直接讲配置,而是追踪一个网络数据包从物理网卡到应用程序的完整路径:网卡把它放进接收环形缓冲区,通过硬件中断通知CPU,内核驱动读取后封装成Socket Buffer,再走协议栈向上传递。这个过程在低负载下毫无问题,但一旦流量爆发,中断处理、上下文切换、内核态与用户态之间的数据拷贝,每一步都在消耗CPU周期和内存带宽。
二、SR-IOV基础:硬件层面的虚拟化
课程进入SR-IOV的世界。SR-IOV是一种PCIe设备的硬件虚拟化技术,一个物理网卡(Physical Function)可以虚拟出多个虚拟网卡(Virtual Function),每个VF都能被直接分配给不同的虚拟机或容器使用。课程详细对比PF和VF的区别,解释IOMMU和VT-d在其中扮演的角色,并梳理Intel(i40e、ixgbe)和Mellanox(mlx5_core)两大主流网卡的支持情况。最后还会对比iavf和vfio-pci两种VF驱动的差异,帮助你在不同场景下做出选择。
三、DPDK架构:把网络搬到用户态
DPDK的核心思路是绕过内核,直接在用户态处理网络包。课程先讲清楚内核态网络和用户态网络的本质区别,然后介绍DPDK如何通过UIO和VFIO机制绕过内核。接着拆解几个关键概念:EAL(环境抽象层)负责初始化和资源管理,mempool和ring buffer提供高性能的内存分配和数据交换,PMD(轮询模式驱动)则让网卡驱动直接在用户态高速收包。
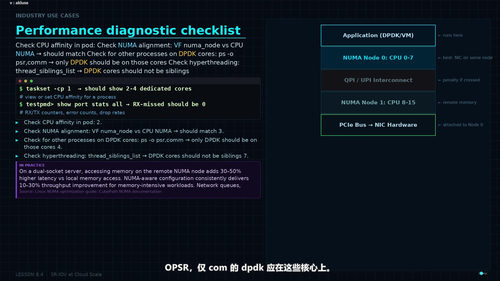
大页内存是DPDK的另一个核心依赖,课程会用具体数据说明为什么2MB甚至1GB的大页对DPDK性能至关重要。CPU绑定和NUMA感知部分则会讲到DPDK如何把线程锁在特定CPU核心上运行,避免跨NUMA节点访问内存导致30%到40%的性能损失。
四、Kubernetes网络现状与瓶颈
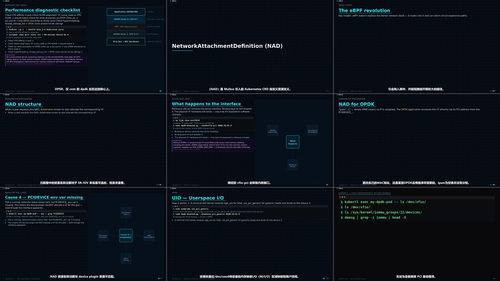
进入Kubernetes环节,课程先回顾CNI的工作原理:Pod如何获得IP地址,Kubelet如何调用CNI插件,Flannel、Calico、Cilium这些常见插件各自的特点。然后点出关键问题——标准CNI对普通业务够用,但对金融交易、电信UPF、视频流媒体这类高性能场景就显得捉襟见肘。课程的解决方案是Multus CNI,它让一个Pod可以拥有多个网络接口,主接口走业务流量,附加接口走高性能数据通道,NetworkAttachmentDefinition则是定义这些附加网络的标准方式。
五、SR-IOV在Kubernetes中的落地
课程详细讲解SR-IOV Network Device Plugin如何让Kubernetes发现VF资源,逐一拆解SriovNetworkNodePolicy的各个字段,再演示SR-IOV CNI插件如何把VF接入Pod的网络命名空间。资源请求和限制部分则讲清楚怎么在Pod spec里声明需要多少个VF、什么类型的VF。
六、DPDK与Kubernetes的深度整合
DPDK要真正在Kubernetes里跑起来,需要解决几个关键问题:Hugepages要被Kubernetes识别为可调度的资源,CPU Manager要为DPDK应用分配独占的核心,NUMA拓扑要对齐确保网卡、DPDK核心、内存都在同一个NUMA节点上。课程一步步演示这些配置怎么做,最后给出一张完整的架构图,把SR-IOV、DPDK、Kubernetes三层的关系理清楚。
七、真实场景的工程实践
高级用例部分直接切入电信场景:5G UPF如何用SR-IOV和DPDK达到线速处理,OVS-DPDK展示了在虚拟交换机层面实现线速转发的方案,VLAN和SR-IOV的结合能实现物理级别的流量隔离,多节点集群中怎么统一管理跨节点的SR-IOV资源也是课程覆盖的内容。
八、踩过的坑和排障指南
课程最后用相当篇幅讲故障排查:VF创建不出来可能是IOMMU没开或者BIOS配置有问题,Pod里看不到VF要检查device plugin状态和资源预留,DPDK应用启动失败往往是大页或CPU亲和性没配对,性能不达预期则要逐项排查NUMA、IRQ亲和、PCIe带宽等瓶颈。课程还附了一份关键命令速查表,方便日常运维随时翻阅。
九、收尾与下一步
结尾部分回顾整条技术栈的完整架构,然后展望未来——eBPF和XDP正在改变内核旁路技术的格局,VPP、SPDK等用户态框架也在向更多领域扩展。最后给出社区资源和获取帮助的途径,方便课后继续深入。
如果你的工作涉及电信NFV、金融交易系统、低延迟视频流处理,或者在生产环境里反复被Kubernetes网络性能问题折磨,这门课会非常对路。前置条件是已经熟悉Kubernetes基本操作和Linux网络基础,否则部分内容跟起来会吃力。
学完这门课,你不会只是记住几个YAML怎么写,而是能从硬件、驱动、内核、容器编排器四个维度理解Kubernetes高性能网络的完整链路,知道每一步为什么这么做、性能损耗出在哪里、出了问题该往哪个方向排查。