资源介绍
视频数量:9个
总时长:1小时40分
课程介绍:
SPSS数据分析实战:从数据整理到论文写作的完整流程
想象一下这样的场景:你花了整整三个月发放问卷、收集数据,每一份回收的纸质问卷都仔细核对后录入了电脑。打开SPSS,满屏都是数字,可接下来该做什么?点哪个菜单?那个0.05的p值到底怎么读?导师催着你要初稿,你却连信度分析在哪一步都记不清——这是太多做论文的同学真实经历的崩溃时刻。
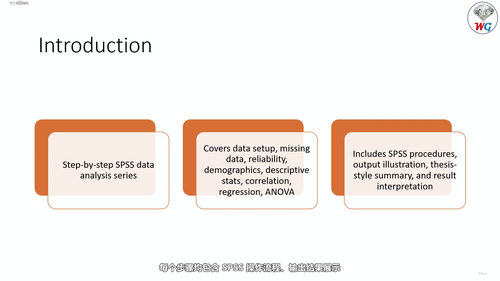
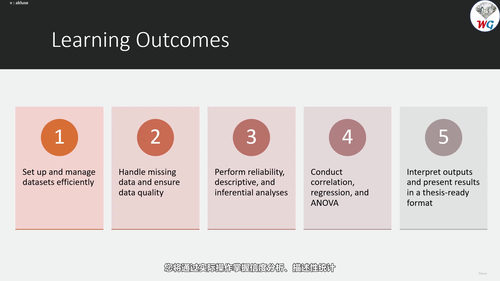
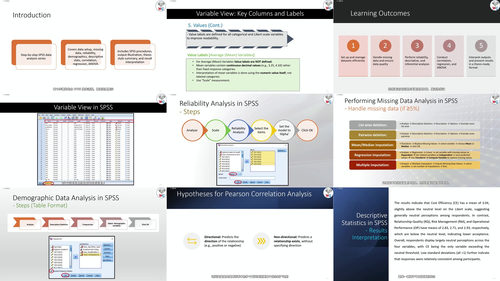
这套课程专门为正在写毕业论文或期刊论文的研究者准备,讲的就是怎么用SPSS把一份原始数据一步步变成论文里可以直接引用的分析结果。整个教程加起来不到两小时,但覆盖了一条完整的分析链条:从建表开始,到缺失值处理、信度检验、人口学描述、变量描述性统计,再到相关分析、回归分析和单因素方差分析,最后每一节还会告诉你这些输出结果在论文里应该怎么写、怎么解读。
一、数据表搭建:好的开始是成功的一半
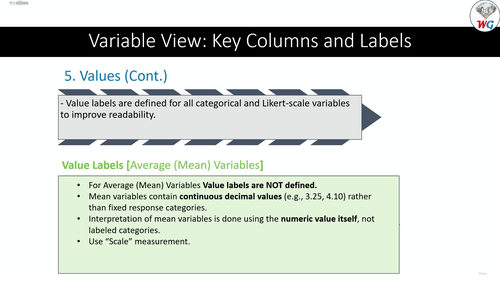
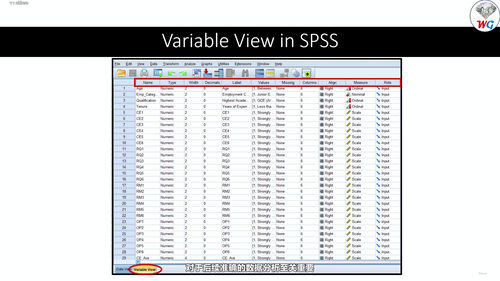
很多人忽略数据表搭建这一步,觉得随便录进去就行。结果到了分析阶段发现变量类型设错、量表方向没反转、均值该在SPSS里算还是Excel里算都搞不清楚,一旦返工就是浪费一整天。这节课先讲怎么在Excel里把原始问卷回答整理好,再导入SPSS。特别值得注意的是,当一个变量由多个题目测量时(比如用六道题测"成本效益"),需要在SPSS里计算均值变量而不是提前在Excel算好——这个细节很多教程不讲,但踩坑的人很多。
二、缺失数据:沉默的回答怎么说
问卷回收不可能完美,总有漏填、乱填的。缺失数据不是删掉就完事的。这一节讲怎么识别缺失模式、用均值插补还是序列均值,怎么判断缺失是随机的还是有规律的。处理得好,后续所有分析结果才站得住脚。
三、可靠性检验:你的问卷真的在测你想测的东西吗
用克隆巴赫Alpha系数(Cronbach's Alpha)判断量表的内部一致性,这是社会科学论文里几乎必报的指标。课程会用实际数据演示怎么读Alpha值,多少算合格,不到0.7该怎么办,是不是该删题目。这一步做不好,答辩时老师很容易质疑数据质量。
四、人口学与描述性统计:先把样本说清楚
这部分处理两类问题:一是你的样本是谁(性别、年龄、学历、收入分布),二是你的核心变量长什么样(均值、标准差、偏度、峰度)。论文的"研究样本"和"描述性统计"两个表格基本就靠这些输出填出来。
五、推断统计:变量之间的关系怎么量化
这才是论文数据分析的主体。课程依次讲三种最常用的方法:
皮尔逊相关分析,用来检验两个连续变量之间有没有线性关系,相关系数r怎么读、p值怎么报告、表格怎么画。
线性回归分析,用来回答"自变量能不能预测因变量"的问题。R方代表什么、标准化系数Beta看什么、模型显著性怎么看,课程都会一步步演示。
单因素方差分析(One-Way ANOVA),用来比较三组及以上均值的差异。比如不同学历群体的购买意愿有没有显著不同,方差分析的结果在论文里怎么呈现,F值和事后多重比较怎么写。
整套课程按论文写作的实际顺序编排,不是按SPSS菜单罗列。学完之后,你手里有一份能直接套用在自己论文里的操作流程,知道每个分析跑完之后该往论文里填什么数字、怎么写解读那段话。比较适合正在准备本科或硕士毕业论文、要用SPSS做问卷数据分析的同学,也适合刚开始接触实证研究的硕博新生。