资源介绍
视频数量:35个
总时长:2小时38分
课程介绍:
微软Azure Databricks数据工程师认证备考指南
数据工程师的日常总在跟一堆矛盾打交道:既要保证数据及时流转,又要让质量可控;既要快速响应业务需求,又要守住安全和合规的底线。过去几年,湖仓一体这个概念越来越被认可,而Azure Databricks正是这条路上的代表性平台。这门课围绕DP-750认证考试展开,由微软出版社出品,讲师Lydia Evelyn会把整个Azure Databricks工具栈拆开讲清楚,帮你建立从工作区搭建到生产管道落地的完整认知框架。
一、工作区与计算基础
一切都要从搭台开始。第一章先带你认识DP-750认证的整体定位,再搞清楚湖仓模式到底是什么、为什么Databricks会演变成今天这个样子。课程会演示如何创建并导航Azure Databricks工作区,根据不同的工作负载选择合适的计算集群类型,以及如何在不同语言之间切换使用笔记本。SQL、Python、Scala这些常见语言的支持情况和适用场景,在这部分都会聊到。学完这一章,你会对Azure Databricks的底层架构有个直观感受,知道自己每天打开的工作区里到底跑了些什么。
二、Unity Catalog治理体系
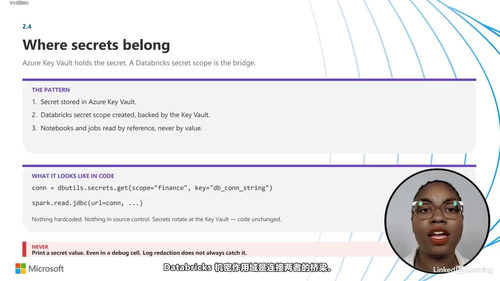
数据一旦多起来,治理就成了让人头疼的事。Unity Catalog是Azure Databricks统一治理的框架,第二章会带你梳理它的对象模型——catalog、schema、table之间是什么层级关系,怎么创建和组织这些对象。重点会讲到权限管理,包括细粒度的访问控制、行级过滤、列级掩码,还有基于属性的访问控制(ABAC)。身份认证方面,会涉及服务主体、托管标识与Azure Key Vault的集成方式,确保无人值守场景下的安全。数据血缘、审计追踪、Delta Sharing安全共享也会讲到。这些内容在考试里占比不低,实际工作中更是团队协作的基石。
三、湖仓数据建模
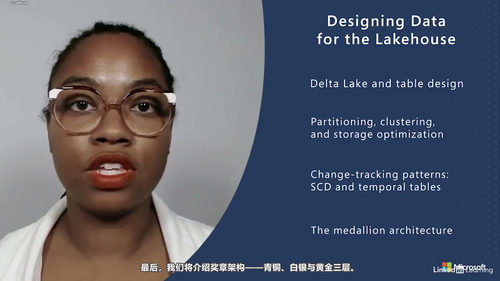
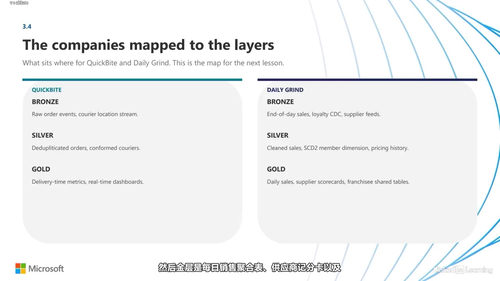
好的数据层设计能让后续的处理事半功倍。第三章聚焦Delta Lake和表设计,包括分区策略、聚簇(Z-order、liquid clustering)的选择与存储优化。你会学到如何用渐变维度(SCD Type 1/2)和时态表来追踪数据变化,以及业界经典的Medallion架构——Bronze、Silver、Gold三层各承担什么职责,数据如何在层与层之间流动。讲师特别强调了一个思维习惯:每个设计决策都要问自己"场景要求什么、哪些选项满足需求、我接受了什么权衡",这个方法论会贯穿整个课程。
四、数据接入与转换
数据从哪来、怎么进来、进来后怎么处理——这是数据工程师的核心战场。第四章覆盖批量接入(COPY INTO、LakeFlow Connect)和流式接入(Auto Loader、结构化流)的不同模式。数据清洗、探查性分析、常见转换操作会一一演示,连接(join)、集合运算、宽窄表转换也会讲到。数据写入部分会区分merge、insert、append等不同场景的使用边界。最后还会聊到数据质量约束的执行方式,以及Spark性能优化的基本功,比如数据倾斜处理、分区裁剪、缓存策略等。
五、生产管道与运维
开发环境和生产环境完全是两码事。第五章会带你设计生产级的数据管道,区分笔记本驱动、声明式Spark管道(DLT)和LakeFlow Jobs三种范式的适用场景。编排层面,触发器、调度、错误处理机制需要怎么配置,Git工作流和测试策略怎么嵌入开发流程,Asset Bundles怎么打包部署,课程都会讲到。运维那一块,监控指标怎么看、常见故障怎么排查、成本怎么管理,都会展开讨论。最后还会教你如何读懂Spark UI的各项指标,定位性能瓶颈。
适合谁学
如果你已经在做数据相关的工作,用过Spark或者SQL仓库,想往Azure Databricks方向拓展,这门课是个不错的切入点。正在备考DP-750的考生可以把它当作核心学习材料,内容跟微软官方学习指南的知识点对齐。已经在用Databricks的工程师也能从中梳理出完整的知识图谱,补齐治理和运维方面的盲区。课程时长两个半小时出头,节奏紧凑没有废话,适合利用碎片化时间系统学习。学完之后,你应该能独立完成一个湖仓项目从零到一的搭建,也能在考试中从容应对。