资源介绍
视频数量:20个
总时长:1小时0分
课程介绍:
数据分析与机器学习核心概念精讲
你有没有遇到过这样的情况:辛辛苦苦训练了一个模型,准确率显示99.9%,结果部署到真实业务中却一塌糊涂?或者看到"P值小于0.05"这样的统计结论,却完全不知道它在说什么?又或者听同事说起过拟合、A/B测试、交叉验证这些词,每个字都认识,连起来却一头雾水?这门课就是来帮你把这些概念一个一个掰开揉碎讲清楚的。
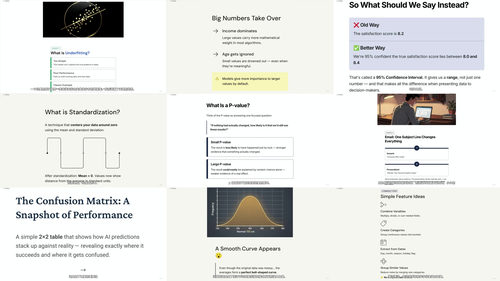
这门课总时长大约一个小时,一共20个短视频,涵盖了数据分析、机器学习和人工智能领域中那些你绕不开、但又经常被搞混的关键概念。课程的编排非常务实,从数据预处理讲起,到模型训练、评估方法,再到统计学基础和真实业务场景,一步步帮你建立完整的知识框架。每一个视频只聚焦一个核心概念,短小精悍,不用担心听着听着就走神。
一、数据不平衡的处理方法
课程从一个非常常见但又容易被忽视的问题入手:数据不平衡。假设你在做欺诈检测,每1000笔交易中只有1笔是欺诈的,这时候如果你的模型把全部交易都标记为正常,准确率也能达到99.9%。但这样的模型显然没有任何实用价值。针对这个问题,课程介绍了三种处理技术。第一种是欠采样,通过减少多数类的样本数量来平衡数据集。第二种是过采样,与欠采样相反,它通过增加少数类的样本来实现平衡。第三种是SMOTE,这是一种更智能的过采样方法,它不是简单复制少数类样本,而是在现有样本之间合成新的样本,既平衡了数据又减少了过拟合的风险。
二、欠拟合与过拟合
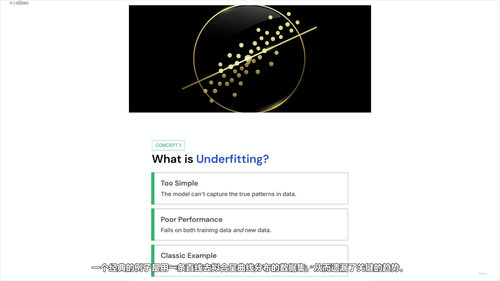
数据处理完了,接下来就要训练模型了。但模型训练过程中有两个经典问题:欠拟合和过拟合。欠拟合是说模型太简单,连训练数据中的规律都没捕捉到;过拟合则正好相反,模型把训练数据学得太死板,把噪声也当成了规律,结果遇到新数据就原形毕露。课程用一个短视频把这两个概念讲清楚,告诉你怎么判断模型出了哪种问题,以及大致的原因在哪里。
三、数据工程基础
在把数据喂给模型之前,还有一大堆预处理工作要做。这一部分占了5个视频,是整个课程的基石。
首先是缺失值的处理。真实世界的数据很少是完美的,总会有各种缺失。课程会告诉你遇到缺失数据时有哪些常见的应对策略,包括直接删除缺失记录、用均值或中位数填充,以及更高级的填充方法。
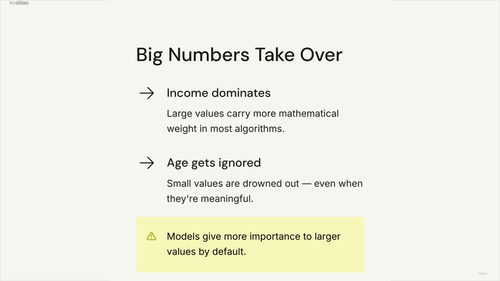
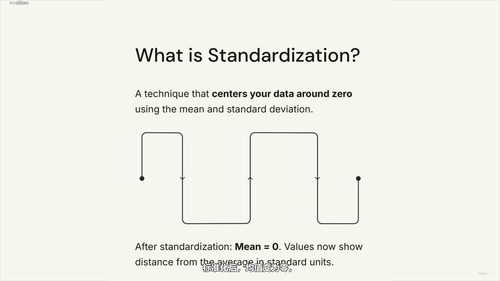
然后是数据缩放、标准化和归一化。这三个概念听起来很像,但各有不同的应用场景和数学原理。很多机器学习算法对数据的尺度很敏感,如果不进行适当的处理,某些数值范围大的特征可能会主导整个模型的训练。课程帮你厘清这三个概念的区别,让你知道在什么情况下该用哪个。
最后是特征工程。这一步往往是机器学习项目中最关键也最耗时的一环。如何从原始数据中提取和构造出对模型有预测力的特征,直接决定了模型性能的天花板。
四、模型的训练与测试
模型训练好了,怎么知道它好不好用?很多新手会直接把模型在训练数据上测一下,看到准确率还不错就以为万事大吉。这是一个很大的误区。课程专门用一个视频解释了为什么不能用训练数据来测试模型,还用了一个非常生动的比喻:好比考前把考题泄露给学生,学生可能考得很好,但并不能说明他真正掌握了知识。考试要考的是面对新题目时的应对能力,模型测试也一样。
那正确的做法是什么呢?答案是交叉验证。课程详细讲解了交叉验证的原理和操作方法。简单来说,就是把数据分成若干份,每次用其中一份做测试,其余几份做训练,轮换多次,让每一份数据都有机会当测试集。这种方式得到的结果比单次划分要稳健得多,能够更真实地反映模型在实际应用中的表现。
五、常用的统计概念
这一部分内容最丰富,包含了6个视频,讲解的是数据分析和机器学习中绕不开的统计学概念。
相关性与因果性是一个特别容易混淆的概念。两个变量相关,并不意味着一个导致了另一个。课程用冰淇淋销量和溺水人数的例子说明,表面上的相关性背后往往隐藏着第三个共同因素。
A/B测试是产品和运营工作中常用的实验方法。课程讲清了A/B测试的基本逻辑和操作流程,让你理解为什么随机分组和足够的样本量是得到可靠结论的前提。
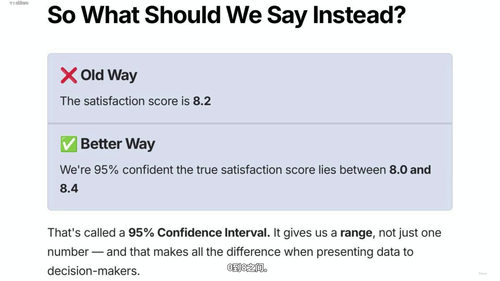
95%置信区间和P值大概是统计学中最常被误读的两个概念。课程不会让你去死记硬背公式,而是帮你真正理解它们到底在说什么。比如P值到底在衡量什么,为什么"P值小于0.05"经常被过度简化和误用。
中心极限定理被称为统计学中的"魔法定理",很多统计推断方法之所以有效,背后都依赖它。课程用一个短视频帮你抓住它的核心思想,理解为什么样本量足够大时,样本均值的分布会趋近于正态分布。
最后,回归与分类作为机器学习的两大基本任务类型,课程帮你理清它们的区别和各自的适用场景,让你在面对实际问题时知道该选用哪类算法。
六、模型准确率的评估
模型准确率高就一定好吗?这可不一定。课程介绍了混淆矩阵这个评估工具,它把模型的预测结果拆成真正例、假正例、真负例、假负例四种情况,让你看清模型到底在哪些类型的错误上栽了跟头。基于混淆矩阵,课程进一步讨论了精确率和召回率之间的权衡。在疾病筛查的场景下,漏诊的代价远高于误诊,所以召回率更重要;在垃圾邮件过滤中,你可能更看重精确率,不想把正常邮件错杀掉。课程会帮你建立这种根据业务场景选择评估指标的思路。
七、客户流失预测实战
课程的最后一个视频把前面学到的概念串联起来,通过客户流失预测这个真实商业案例,展示了企业是如何提前预判哪些客户即将流失的。从数据准备、特征构建到模型选择和评估,让你看到一个完整的机器学习项目在实际业务中是怎么跑起来的。
适合谁来学
如果你刚开始接触机器学习和数据分析,被各种术语搞得晕头转向,这门课会是一个很好的起点。每个概念都用简洁直白的语言讲清楚,不需要你提前掌握高深的数学推导。
如果你是产品经理、运营人员或者业务人员,想要和数据团队更顺畅地沟通,理解他们口中的过拟合、置信区间、A/B测试到底是什么意思,这门课能帮你快速搭建共同语言。
如果你是有一定基础的开发者,想要在自己的项目中应用机器学习,这门课能帮你避开那些新手常踩的坑,让你的模型在真实环境中也能稳定发挥。
整门课的设计思路是"短平快",每个视频只讲一个核心概念,节奏紧凑。一个小时看完,你就能对数据分析与机器学习中最常碰到的重要概念建立起清晰的认知框架。虽然时长不长,但覆盖了从数据预处理到模型评估的完整链路,既有基础概念的讲解,也有实际业务场景的串联。对于想要快速入门或者查漏补缺的人来说,这是一个相当高效的入口。