资源介绍
视频数量:14个
总时长:1小时12分
课程介绍:
机器学习三大范式入门:从监督学习到深度学习
你有没有想过,垃圾邮件过滤是怎么做到的?手机相册怎么自动圈出人脸?推荐系统为什么总能猜到你喜欢什么?这些功能背后指向同一个领域——机器学习。但机器学习并非铁板一块,它内部有几种截然不同的技术路线,各自擅长的事情差别很大。这门课程就是帮你把这几条路线理清楚的。全部内容十四个短视频,总时长一小时出头,不讲高深数学,不要求编程基础,用最朴素的语言把机器学习世界里最重要的三块拼图拆给你看。
一、机器学习的全景地图
课程一开始,先帮你建立整体认知。第一节课直接抛出"机器学习到底是什么"这个问题,然后顺藤摸瓜,解释什么叫范式、什么叫训练数据、什么叫模型。比如把标记数据解释成给原始数据贴标签的过程,把输入和输出解释成放进去和拿出来的动作。你不需要记住术语,能理解大意就行。
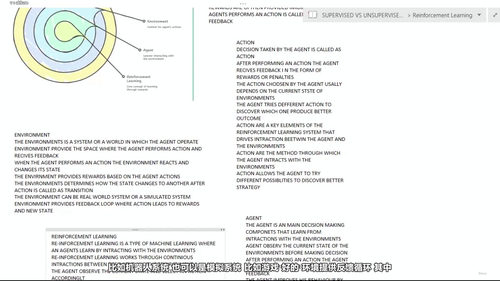
接下来把机器学习的主要分支铺开来讲:监督学习、无监督学习,还有强化学习。这三个名字经常出现在各种文章里,但很多人分不清它们的区别。课程用打比方的方式讲清楚了:监督学习像有个老师在旁边批改作业,模型每次预测都能拿到对错反馈;无监督学习没有老师,模型得自己在数据里找规律;强化学习像在玩游戏,做对了得分做错了扣分,通过不断试错找到最佳策略。
二、监督学习:有答案的练习题
监督学习是工业界用得最多的一类方法,课程对这部分着墨也多。它专门处理有标签的数据——你得先告诉模型"这封邮件是垃圾""那封不是",它才能学会判断。课程带你了解监督学习的两个核心任务:分类和回归。前者预测离散的结果,比如邮件是不是垃圾邮件;后者预测连续的结果,比如房价大概多少。
光讲概念容易犯困,课程还安排了监督学习的实例环节,用具体场景把前面的知识点串起来。看完你会明白,为什么银行用它评估贷款风险,医院用它辅助诊断,电商用它预测销量——所有需要"从已知答案里找规律"的场景,基本都是监督学习的天下。
三、无监督学习:没有答案的探索
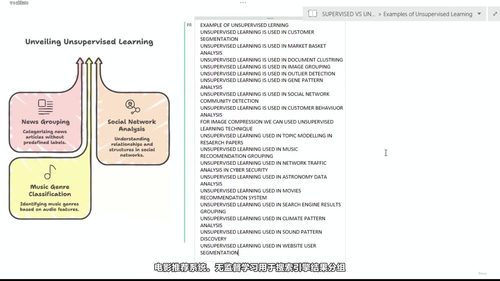
如果说监督学习是带着标准答案做练习,无监督学习就是一张白卷。它拿到的数据没有标签,模型得自己琢磨数据之间有没有隐藏的结构。比如把顾客自动分群,把新闻自动归到不同主题,这些活儿就特别适合无监督学习。
课程告诉你它最大的优点——不需要人工打标签。现实中给海量数据逐条贴标签成本极高,很多团队根本没有这个预算。而无监督学习能从杂乱的数据里自动提取有价值的信息,对刚起步、数据积累还不够丰富的项目特别友好。
当然课程也没回避短板。它会老老实实告诉你,这种方法的准确性和可控性通常不如监督学习,模型找到了什么模式,有时候人也很难直观解释。了解这些优缺点,你才能在实际项目中判断什么时候该用它,什么时候该换别的方案。
四、深度学习:当传统方法遇到瓶颈
最后一大块留给深度学习。如果说前面几种方法还属于经典机器学习的范畴,深度学习就是近十年来真正掀起风暴的那股力量。它本质上是用多层神经网络来做机器学习,最大的特点是能自动从原始数据里提取特征,省去大量人工预处理的工作。
课程解释了什么是神经网络、什么是隐藏层、什么叫复杂特征学习。深度学习最擅长的领域包括图像分类、语音识别、自然语言处理,以及各种非结构化数据的处理——图片、音频、文本,这些传统方法啃不动的硬骨头。深度学习还有一个特别有意思的特性:持续学习能力。模型用得越久,表现往往越好,这一点和传统方法很不一样。
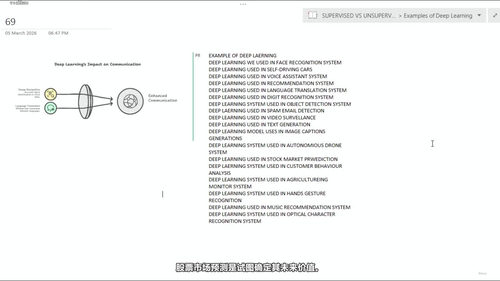
实例环节列举了深度学习的典型应用:人脸识别、自动驾驶、语音助手、推荐系统、机器翻译、数字识别、物体检测、垃圾邮件检测。课程最后简单介绍了几个主流的深度学习框架,并带着你做了两个小练习——判断一个数字是奇数还是偶数,以及在一组数字里找最大的那个。虽然是入门级的演示,但能让你对深度学习的工作流程有个直观感受。
整门课看完,你不需要会写代码,也不需要懂高等数学,但脑子里会建起一张完整的地图:知道机器学习有哪些主要分支,每个分支擅长什么、不擅长什么,现实中哪些产品用的是哪种技术。对于刚踏入人工智能领域的人来说,这张地图比任何细节都重要。