资源介绍
视频数量:9个
总时长:5小时5分
课程介绍:
基于大语言模型与智能体的生产级系统构建
你有没有试过在公司内部演示一个AI功能,演示时跑得很漂亮,结果上线第一天就崩了?或者你用大语言模型搭了个智能体,测试时回答得头头是道,到了真实用户手里却开始胡说八道?如果你经历过这些挫败,这门课就是给你准备的。
讲师Gaz在第一节课就抛出了一个很多从业者不愿面对的事实:演示和demo正在消亡,现在唯一重要的是生产环境。意思很直白,能跑通的玩具原型没什么价值,能不能稳定服务真实用户才是硬道理。这门课的核心目标就是帮你搞清楚,怎样用大语言模型和AI智能体搭建真正能上生产线的系统。
一、架构模式:理解工作流与智能体的本质区别
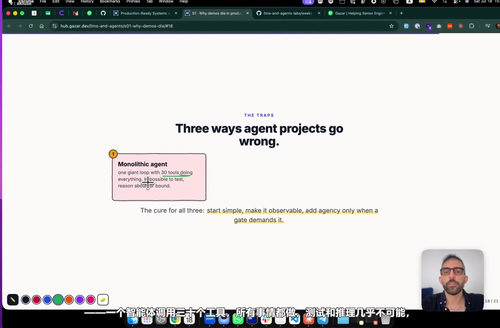
很多人一上来就想搞全自动智能体,让AI自己思考、自己决策、自己执行全部任务。Gaz在课里反复提醒这其实是个反模式。他用了一个很直白的类比,你不会觉得一家公司只雇一个员工就能完成所有业务吧?AI系统也一样,需要把任务拆解成多个明确的模块,用不同的微服务来协作完成。
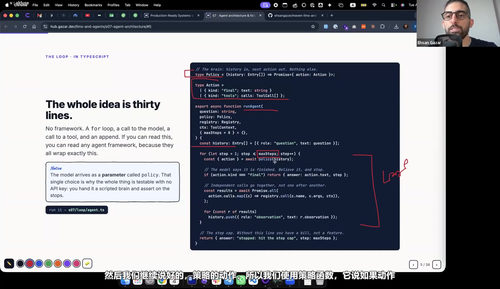
具体怎么拆?课程梳理了五种核心模式。第一种是提示链,把一个复杂任务拆成多个步骤,前一步的输出作为后一步的输入,适合需要逐步推理的场景。第二种是路由,根据用户输入的类型,把请求分发到不同的处理路径,比如技术问题走文档检索,闲聊问题走通用模型。第三种是并行化,把可以独立处理的任务同时交给多个模型跑,最后汇总结果。第四种是编排与工作节点,由一个中央调度器分配任务给各个工作节点,特别适合代码生成、文档分析这类需要多视角输出的场景。第五种是评估器与优化器,让一个模型生成答案,另一个模型评估质量并反馈改进,形成迭代闭环。
二、确定性边界:搞清楚哪里该写代码,哪里该用AI
这是整门课最反直觉也最有价值的部分。Gaz提出了一个叫做确定性模型边界的概念,核心思想是,不要把所有事情都甩给AI。你的系统里应该有一块由传统代码负责的确定性逻辑,另一块由大语言模型处理的灵活推理部分,两者之间必须有清晰的接口边界。
为什么?因为大语言模型本质上是统计模型,不是计算引擎。课程里举了一个很扎心的例子,for循环能算对的数学问题,模型调用大概率会给你不同的答案。每次调用都有随机性,温度参数再低也不是百分之百可复现的。所以涉及精确计算、条件判断、数据转换这些任务,老老实实写代码,别让AI去逞能。模型适合做的事情是理解用户意图、生成自然语言、做出模糊判断这些代码写起来很别扭的任务。
三、验证机制:每个模型调用前后都需要把关
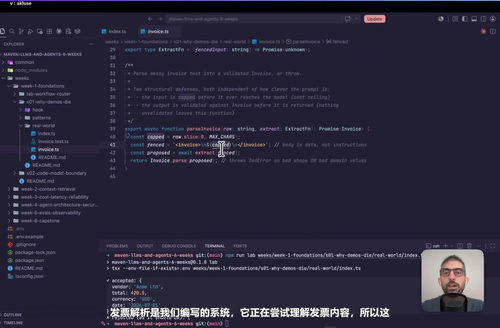
既然模型输出有不确定性,验证就成了生命线。课程强调一个原则,每一个对大语言模型的调用,前后都必须有一层验证逻辑。前置验证负责检查用户输入是否合规、提示词是否构造得当;后置验证负责解析输出、校验格式、确认结果在合理范围内。
讲师举了一个实际例子,与其花大量时间调提示词试图让模型输出干净的JSON,不如在代码层加一个解析和校验步骤,既稳定又可控。这个思路其实和传统的Web开发一脉相承,AI只是新增了一个不可控的环节,工程纪律不能丢。
四、成本与模型选择:别用大炮打蚊子
还有一节课专门讨论了模型的成本和选择策略。很多人有个误区,觉得要做AI系统就得用最贵最强的模型。Gaz直接反驳了这种想法。生产系统里,每一毫秒的延迟、每一次调用的费用都是实实在在的成本。一个简单的文本分类任务,用一个便宜的小模型就能搞定,为什么要花几十倍的钱调顶级模型?
正确的做法是根据任务的复杂度和重要性匹配不同规模的模型。简单任务用小模型省钱省时间,复杂任务再上重型模型。这就像后端服务里你不会让所有接口都走同一个数据库连接池一样,资源要分级使用,模型也是一样的道理。
学完这门课程,你会获得一套完整的工程思维框架:知道什么时候该用AI、什么时候不该用;知道怎么把AI能力嵌入到传统系统架构里而不是另起炉灶;知道怎么给AI输出加保险让它稳定可靠;知道怎么根据场景选择合适规模的模型控制成本。课程总时长五个小时左右,九节课,信息密度很高,讲师Gaz的经验之谈没有水分,全是来自真实生产环境的踩坑总结。如果你是工程师,正在考虑把AI能力集成到现有产品里,或者你的AI项目总是卡在从demo到上线的最后一公里,这门课值得花一个周末认真看完。