资源介绍
视频数量:18个
总时长:9小时54分
课程介绍:
向量数据库实战:从语义搜索到RAG智能应用
你打开一份上百页的Docker技术手册,想找某条命令的具体用法,Ctrl+F输入关键词,结果什么都没匹配上——因为你记得的命令名和文档里写的措辞不完全一样。这种"明明知道答案就在里面却搜不出来"的体验,几乎每个开发者都遇到过。
传统的关键词搜索有个根本性的局限:它只能匹配字符,匹配不了含义。而这门课要教你的,是一整套让应用真正"读懂"文本含义的技术——嵌入、向量数据库、语义搜索,以及最近两年火爆整个AI圈的RAG(检索增强生成)。整套课程将近十小时,十八节视频,从最基础的概念讲起,一直带你做到生产级应用。
一、基础概念:搞懂嵌入和向量数据库
课程一开始不会急着敲代码,而是先把几件关键的事情说清楚:到底什么是嵌入(Embedding),为什么文本要被转换成一串数字才能进行相似度搜索,向量数据库和传统的关系型数据库到底有什么本质区别。这部分内容看似理论,却决定了后面所有实践环节的走向——你只有清楚数据在向量空间里是怎么分布的,才知道为什么某些搜索结果"看起来不对",以及怎么调整。
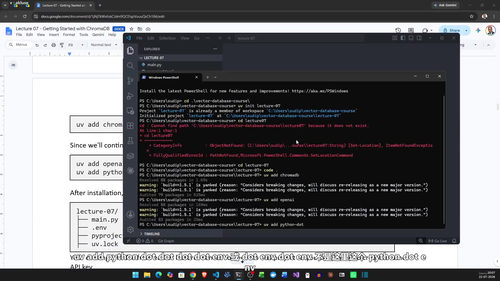
讲师Sudi Bhattacharya会带你搭建好开发环境,配置好Python和必要的依赖库。所有源代码都在GitHub上开放下载,所以你可以一边看一边跟着敲。
二、生成嵌入:和OpenAI API打交道
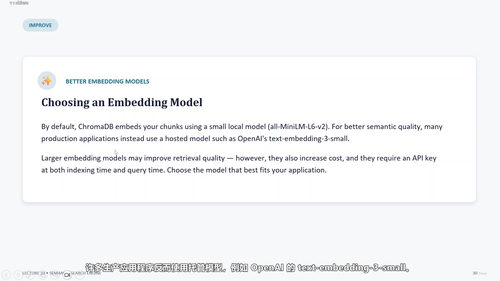
进入第二部分,就要开始动手了。第一件事是使用OpenAI的API把一段段文本转换成嵌入向量。讲师会详细演示API调用的每个步骤,包括参数怎么选、请求频率怎么控制、返回的数据结构长什么样。
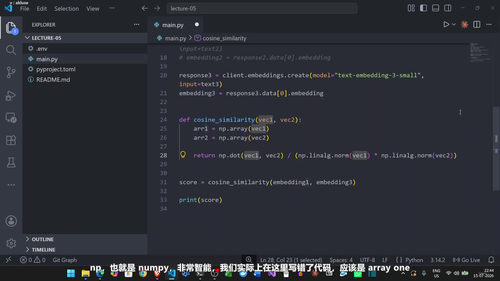
生成嵌入之后,紧接着就要回答一个核心问题:怎么判断两段文本是不是在说同一件事?这就涉及到语义相似度的计算——余弦相似度、欧氏距离这些听起来抽象的概念,实际操作起来其实就是一行代码的事。讲师会带你跑几个真实例子,让你亲眼看到两段文字在向量空间里的距离是如何反映出它们在含义上的远近。
文档分块(Chunking)是这部分另一个重点。把一整份PDF喂给模型显然不现实,必须先把长文档切成合适大小的片段,每个片段单独生成嵌入。讲师会讲解常见的分块策略,包括按固定长度切分、按段落切分,以及如何处理跨段落的内容。
三、ChromaDB:从本地开发到第一个完整项目
掌握嵌入的生成之后,就该找个地方把它们存起来了。ChromaDB是一个轻量级的开源向量数据库,特别适合本地开发和原型验证。课程会带你从零开始配置ChromaDB,创建集合(Collection),往里面写入向量,然后执行相似度搜索。
这部分的高潮是课程的第一个完整项目:一个AI驱动的PDF语义搜索引擎。流程是这样的——读取PDF文档,提取文本,切分成块,生成嵌入,存入ChromaDB,然后接收用户用自然语言提出的问题,从数据库里检索最相关的片段并按相似度排序展示出来。这个项目看起来不算复杂,但它串起了前面学到的所有知识点:嵌入、分块、向量存储、相似度搜索。
讲师会特别强调一个新手最容易踩的坑:嵌入函数不一致。如果存数据时用的是一套嵌入模型,搜索时换成了另一套,搜出来的结果会一塌糊涂。这个问题的排查和修复过程,讲师会一步步演示给你看。
四、构建完整的RAG聊天机器人
语义搜索引擎虽然好用,但它只能把匹配的片段展示出来,答案还得用户自己去拼接。真正的AI助手应该能直接告诉你答案,而不只是甩给你一堆原文。
这就是RAG发挥作用的地方。课程会先解释RAG的工作原理:用户提问,系统检索相关片段,把片段作为上下文发送给大语言模型,大模型基于这些上下文生成自然语言回答。整个过程检索在前、生成在后,所以叫"检索增强生成"。
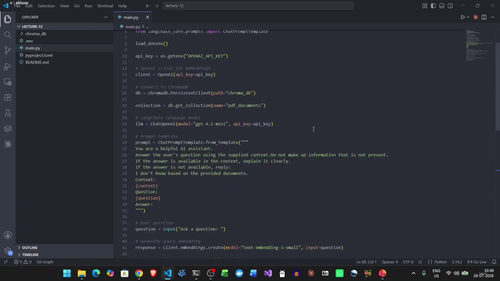
实操环节会用到LangChain这个框架,它能把向量数据库、大语言模型、提示词模板这些组件串成一个完整的流水线。你会学会构建RAG的后端逻辑,搭建聊天界面让用户可以连续对话,还要处理对话历史的管理。
搭好之后,还得优化。讲师会讲解几种提升RAG效果的方法:检索结果的过滤和重排序,提示词的设计技巧,如何让模型在被检索内容确实不相关的时候老老实实说"我不知道"而不是胡编乱造。
五、用Pinecone应对更大规模
ChromaDB适合学习和原型开发,但要处理百万级甚至千万级的文档量,就需要更专业的工具。Pinecone是业界用得最广泛的托管型向量数据库,专为大规模生产环境设计。
课程第六部分会带你上手Pinecone,了解它的索引管理方式、命名空间机制、计费模型。然后是一个迁移实战:把前面用ChromaDB写的应用改造成Pinecone版本。这个迁移过程非常有价值,因为它逼着你去思考两者在API设计上的差异,代码哪些地方需要调整,哪些逻辑可以原封不动地搬过去。
六、生产环境最佳实践
最后一部分讲的是上线之前必须考虑的几件事:检索质量和延迟之间的权衡,元数据过滤和混合搜索的搭配,索引更新策略,安全和访问控制,以及如何监控生产环境中向量搜索系统的运行状态。这些内容不是锦上添花,而是从原型走向真实产品的必经之路。
适合谁学这门课?如果你会用Python写程序,想把AI能力集成到自己的产品里,或者正在做需要处理大量文档内容的项目,那这课程应该对你胃口。后端开发者和全栈开发者会觉得特别顺手,因为课程里讲到的很多设计模式和工程实践都是通用的。不需要你提前了解大语言模型的内部原理,课程会从头讲起。
学完之后你会拿到几个实实在在的东西:一份能跑的PDF语义搜索应用,一个完整的RAG聊天机器人,对ChromaDB和Pinecone两个主流向量数据库的实操经验,以及一套从原型到生产的方法论。这些东西组合起来,足以让你在工作中动手搭建一个真正可用的AI搜索或问答系统了。