资源介绍
视频数量:17个
总时长:2小时55分
课程介绍:
金矿远景区制图:随机森林与XGBoost实战对比
想象一下,你手里有一片区域的地质数据,包括航磁异常图、放射性测量数据、断层分布、已知矿点位置,但面对十几层栅格、几十万个网格点,想人工判断哪里最可能藏着金子,既耗时又容易遗漏关键信息。这门课程要解决的,就是这个真实存在的问题。
这是一门面向矿产勘探领域的机器学习实战课,以尼日利亚奥孙州的金矿勘探为完整案例,演示如何把航磁数据和航空放射性数据融合起来,用随机森林和XGBoost两种主流集成学习算法分别建模并打分,最终生成一张完整的金矿远景区分级图。整个流程从零开始,数据预处理、特征工程、模型训练、结果可视化,全部走通。
一、地理空间数据预处理
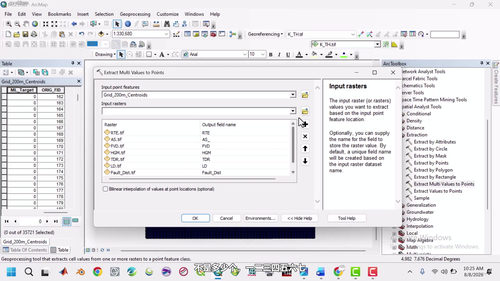
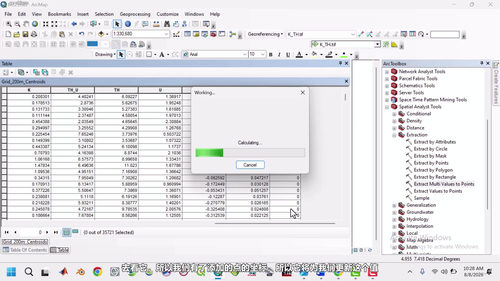
课程的第二章占了相当大的篇幅,光是视频就有十个左右,这是因为干净的输入数据决定了模型能走多远。这一部分用ArcGIS作为主要工具,从创建研究区和已知矿点的Shapefile开始,把十几层航磁和放射性栅格数据按研究区边界裁剪。接着演示航磁数据的完整处理流程,从原始数据出发,做化极处理、解析信号提取、倾角导数(即Tilt Derivative)、总导数和水平导数计算、垂直相位变换。这些操作听起来很专业,但对勘探人来说都是日常工作里熟悉的工具。放射性数据这边则处理钾(K)、铀(U)、钍(Th)三种元素的含量栅格,并计算K与Th比值、Th与U比值、K偏差等衍生特征。
最后还要做一件关键的事,用200米和1000米的缓冲区划分训练样本。在矿点周围200米内打上标签1表示已知矿床区,在200到1000米之间打上标签负99表示排除区,其余网格标为0表示非矿床区。这个三分类标签体系直接决定了模型能不能学到有意义的边界。
二、环境搭建
课程也考虑到了动手能力不同的学员,专门安排了一节讲怎么安装Python和Anaconda分发版,配置好跑Jupyter Notebook所需的环境。这一步虽然简单,但对没装过Python的朋友来说,避开版本冲突能省不少时间。
三、两种算法建模对比
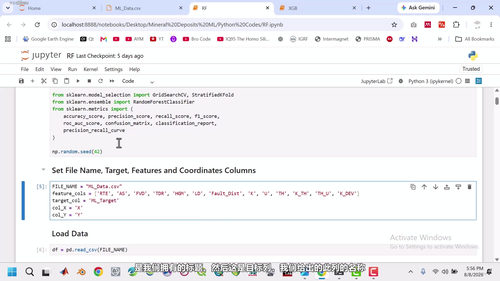
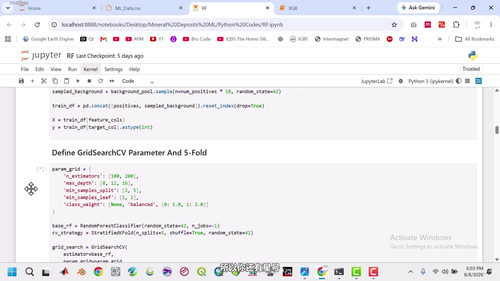
重点来了,随机森林和XGBoost两种算法的建模过程。随机森林部分会演示如何调用scikit learn里的RandomForestClassifier,调整树的数量、最大深度、特征采样比例这些超参数,让模型既能学到模式又不会过拟合。XGBoost部分则演示梯度提升树的训练流程,包括学习率、子样本比例、树的深度等参数的影响。这两种算法虽然都叫集成学习,但底层逻辑完全不同。随机森林是并行的bagging思路,XGBoost是串行的boosting思路,把它们放在一起对比,正好能看清哪种思路更适合处理这种非线性的地质数据。
四、远景区制图与结果输出
课程最后会把两个模型的预测结果导出,对每个网格点给出"是远景区"的概率,再按照概率值重新分级为很高、高、中等、低、很低五个类别,生成最终的远景区分布图。这张图就是给后续实地勘探指方向的依据,概率越高的区域,越值得安排钻探验证。课程还准备了混淆矩阵和特征重要性图,能直观看到模型预测准不准、哪些地球物理特征对判别矿床最关键。
五、适合人群
如果你是勘查地球物理或地质学背景的研究生,在科研项目里需要用到机器学习,这门课能让你跳过那些纯理论的ML教程,直接进入矿产领域的实战。如果你是矿业公司的初级数据分析师,想转型做数据驱动的矿产预测,这门课提供的完整数据集,包括航磁数据、放射性数据、矿点Shapefile、Python代码,可以直接复用到自己的工作里。如果你只是对机器学习感兴趣,想找一个有实际物理意义的项目练手,这个案例比那些鸢尾花分类、波士顿房价预测有意思得多,你面对的不是十几个特征,而是真实的地质空间数据,每一个特征都有明确的地球物理含义。
学完这门课,你会拥有一套完整的从栅格到远景区图的工作流,知道在每个环节该做什么、用什么工具、为什么这么做。更重要的是,你会建立起一种判断力,看到新的勘探区时,知道该提取哪些特征、用哪种模型更合适、模型给出的结果该怎样解读和验证。