资源介绍
视频数量:12个
总时长:1小时53分
课程介绍:
高频交易系统精通:一百个C++与Rust低延迟实验精讲
想象你坐在交易大厅里,屏幕上的订单流以每秒数十万笔的速度翻滚闪烁。全球金融交易所每天处理的消息数量以亿计,在这片竞技场上,竞争不是按天计、按小时计、甚至按分钟计——它以微秒计。一微秒的偏差,一次垃圾回收引发的停顿,一个硬件中断产生的抖动,都可能让一笔本该盈利的交易滑入亏损。高频交易开发者面对的现实就是这样:他们的对手不是市场,而是延迟本身。
这门课只有一个目标:亲手从零搭建一套生产级高频撮合系统,并让它在P99延迟严格低于5微秒的阈值下稳定运转。一百个实验覆盖从裸机环境配置到顶点部署的完整链路,全程采用C++与Rust双语言实现。
一、基础环境搭建:
这个模块解决地基问题:搭建隔离的Linux开发环境,配置C++与Rust双编译工具链,验证CPU拓扑与NUMA节点布局,设置实时调度优先级和FIFO线程策略,建立Git工作流,编写微秒级精度的基准测试定时器,跑通初始构建自动化流水线。这是后续所有实验的试验田,每一处配置都瞄准确定性。
二、低延迟网络与内核旁路:
标准Linux网络栈在高频场景下是最大的瓶颈。这一模块分析网络栈瓶颈所在,安装配置DPDK数据面开发套件,把网卡绑定到用户态驱动,实现零拷贝环形缓冲报文接收。还要掌握最小延迟的TCP/IP socket调优,用硬件时间戳测量网络往返时延,通过轮询模式驱动彻底消除上下文切换。
三、高性能数据结构与内存:
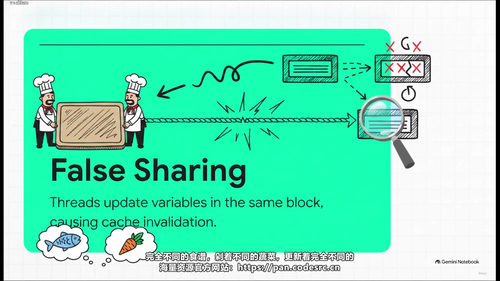
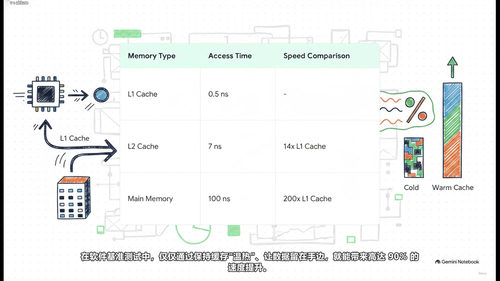
这部分进入撮合引擎的核心地带。设计缓存感知的数据结构,实现无锁单生产者单消费者队列,自己写bump allocator管理内存,多线程环形缓冲区里消除伪共享。内存屏障、原子操作、定容订单簿存储、零分配消息解析循环——每个数据结构都要考虑CPU缓存行的边界,因为一次缓存未命中的代价就是几十纳秒。
四、FIX协议与订单网关:
交易系统不是直接对接交易所,中间需要标准化通信层,FIX协议就是金融行业的事实标准。拆解FIX协议结构,自己实现高性能的编解码器,管理会话状态机和序列号,实现心跳与重连机制,设计入站网关连接接收器,把客户订单路由到内部线程,最后用高吞吐量模拟器验证峰值消息速率下的网关延迟。
五、实时市场数据接入与SBE:
交易所下行行情的延迟直接决定策略能否抢到最优价格。分析ITCH协议和市场数据feed的整体架构,实现Simple Binary Encoding解析器,从增量更新重建订单簿,处理乱序到达的报文,搭建实时最优买卖价的计算引擎,通过多播行情生成器做端到端延迟验证。
六、撮合引擎核心开发:
这是整套系统的"心脏"。设计并实现价格-时间优先的撮合算法,处理限价单的增删、市价单对盘口流动性的执行、快速处理撤单和改单。撮合产生的成交回报要发布到持久化层,撮合核心循环里要杜绝竞态条件。最后用复杂交叉成交与部分成交的场景模拟器来验证引擎状态在不同运行下的一致性。
七、风险管理与交易前控制:
高频系统里,风险控制必须比撮合更快。设计微秒级的交易前风险校验,实现最大订单名义价值检查、持仓限额和信用约束、错误报价价格笼子验证逻辑,搭建实时盈亏和敞口追踪监控,实施熔断器应对市场剧烈波动。风险拒绝日志要带纳秒级精度审计,洪水式的压力测试评估风险引擎在极端负载下的延迟影响。
八、分布式遥测与硬件时间戳:
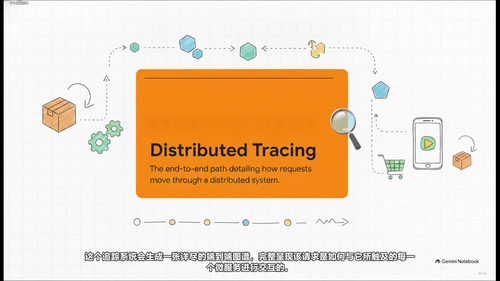
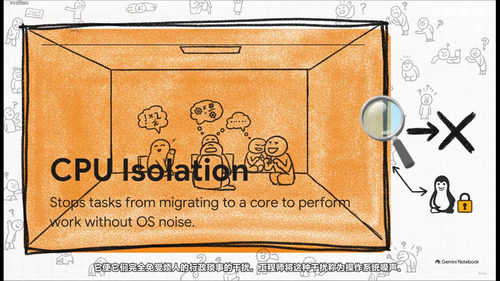
多节点协同运行需要一套统一的观测体系。配置PTP精确时间协议进行时钟同步,把网卡硬件时间戳集成进事件日志,构建高分辨率延迟直方图记录器,通过共享内存环形缓冲区导出遥测指标,Prometheus导出器和Grafana面板可视化微秒级的P50、P99、P999分位数。最终搭建分布式追踪链路,识别延迟离群点和CPU抖动尖峰,分析核心隔离和操作系统噪声的影响。
九、合规、监管审计与DORA:
高频系统不仅要快,更要合规。这一模块实现监管审计轨迹的消息日志记录,确保满足MiFID II时间戳标准的要求,设计弹性灾难恢复和故障切换计划,自动化DORA运营韧性测试。节点间通信用双向TLS加密,实施基于角色的访问控制,定期自动安全漏洞扫描,对静态的市场数据和交易日志加密,最后从日志生成监管合规报告。
十、自主部署与顶点执行:
最后十个实验把所有模块拼成一个完整系统。核心交易微服务被打包成裸金属镜像,用Ansible配置自动化系统部署,本地持续集成流水线搭建完成后,在预发布环境跑自动化集成测试。生产环境的内核参数需要精细调优,端到端交易栈部署完成后启动实时市场仿真流量注入。实时延迟和风险仪表盘开启监控,随后执行混沌工程演练验证故障切换能力,最终交付整套撮合架构并接受项目评估。
一百个实验走完一遍,你亲手打造出一个生产就绪的、以C++和Rust双语言实现的高频撮合系统。低延迟编程的理解会从"知道怎么做"变成"清楚为什么这么做"。每一微秒从哪里省,每一次内存分配如何避免,每一次上下文切换为何必须消除——这些会在你写下的每一行代码里留下清晰的痕迹。
这门课不是面向编程初学者的,它要求你已经具备扎实的C++或Rust语言基础,对操作系统、网络、并发编程有一定理解。课程真正适合的人,是那些在量化交易、交易系统开发或低延迟基础设施领域想要深耕的工程师,或者是对金融科技底层技术充满好奇、想把它推向物理极限边界的系统架构师。如果你已经写过性能敏感的代码,并希望把它榨到最后一滴性能,这一百个实验会告诉你这条路该怎么走,每一步该踩哪些坑。