资源介绍
视频数量:5个
总时长:1小时44分
课程介绍:
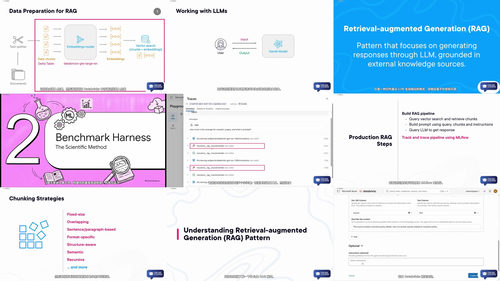
Databricks RAG实战:从零搭建企业级AI流水线
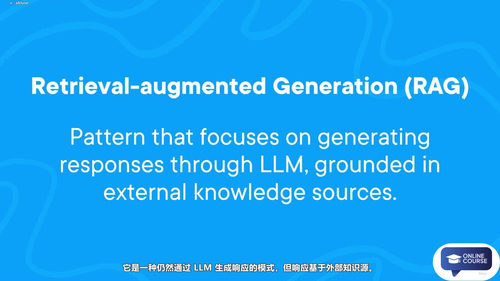
你有没有遇到过这样的场景:手头堆着一份五十多页的健康保险保单,里面写满了定义、承保范围、除外责任、通用条款和各种附件,想要查清楚某个具体问题得翻来覆去看好几遍?如果是企业内部,每天面对成百上千份这样的文档,光是回答客户和员工的提问就要消耗大量人力。而这正是检索增强生成,也就是大家常说的 RAG 技术最擅长解决的问题——让 AI 基于真实的业务文档给出准确、可信的答案,而不是凭空编造。
这门课要带你做的事情非常明确:在 Databricks 平台上,从零开始搭建一条完整可投产的 RAG 流水线,并且把它部署到生产环境里。全程围绕一个真实的业务场景展开——健康保险保单的智能问答系统。你会看到文档是如何被处理、向量化、存储、检索,最终由大语言模型生成自然语言答案的完整闭环。五个视频,总时长不到两小时,内容紧凑但信息密度很高,每一分钟都落在实操要点上。
一、认识 RAG 和 Databricks 环境搭建
课程从一个你一定熟悉的痛点切入:很多人买过健康保险,但很少有人真的把保单读完,因为里面信息量太大、语言又晦涩。课程就以这份五十多页的保单作为示例数据,手把手教你把它接入 Databricks 平台。
这一节的重点是打好地基。你会学会在 Unity Catalog 里创建目录和模式,然后建一个卷(Volume)来存放文档。卷这个概念在传统的数据栈里不太常见,它是 Databricks 用来管理非结构化文件的存储空间,相当于一个专门放 PDF、Word、文档这些文件的文件夹。课程会演示怎么把保单上传进去,并为后续的处理做好准备。
环境方面,课程给出了两种选择:用 Databricks 免费版练手,或者用你自己配好了 Unity Catalog 的 Azure Databricks 账户。两种方式都能跟着操作,唯一区别是免费版用不了 Agent Bricks 这个组件。整个设置过程都会用无服务器计算来完成,省去了配置集群的麻烦。
二、构建数据流水线:摄入、切块与嵌入
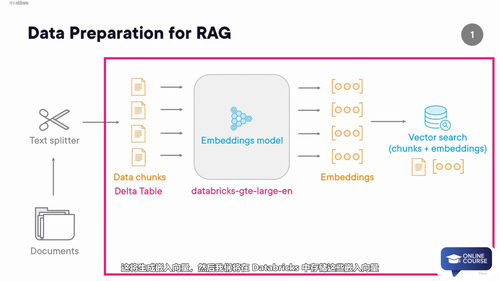
数据准备是 RAG 流水线里最容易被忽略、但实际上最容易出问题的环节。课程专门用一整节来讲清楚三个关键步骤:摄入、切块、嵌入。
摄入就是把你上传的原始文档读进来。听起来简单,但实际操作中你会遇到格式混乱、编码问题、特殊字符等一堆小坑,课程会帮你避开这些弯路。
切块(Chunking)是核心中的核心。一份五十多页的保单不可能整篇塞给大模型,必须切成合适大小的片段。每个片段既要包含足够的上下文让语义完整,又不能太大导致超出模型的窗口限制。切块策略的选择会直接影响到后续检索的准确性,课程会讲解不同的切块方法以及它们各自的适用场景。
嵌入(Embedding)则是把文本转换成计算机能"理解"的数字向量。课程用一个特别直观的例子解释了这个概念:假设有两句话,一句说"Xbox 是一款出色的游戏主机",另一句说"我可以整天与 PlayStation 待在一起"。从关键词匹配的角度看,这两句话没有任何重叠的词,计算机根本不知道它们其实在聊同一类东西。但如果用嵌入模型把它们都转成向量,系统就能发现这两个向量在数学空间里靠得很近,从而识别出它们的语义相似性。这个例子非常经典,能帮你彻底理解为什么关键词搜索在智能问答场景里远远不够用。
三、Mosaic AI 向量搜索:让语义检索成为可能
有了嵌入向量之后,下一步就是把它们存起来,并且能够高效地查找。Databricks 的 Mosaic AI Vector Search 就是专门干这件事的工具。
课程会演示怎么在 Databricks 里创建向量搜索索引,把之前切好的文档块和对应的嵌入向量一起存进去。索引建好之后,整个检索流程就清晰了:用户提一个问题,问题先经过同一个嵌入模型转成向量,然后向量搜索引擎会运行余弦相似度之类的算法,在索引里找出和这个问题最相似的文档块,最后把这些相关的文档块连同原始问题一起送给大语言模型,模型再基于这些真实的企业数据生成自然语言答案。
这个过程就是 RAG 的完整逻辑:检索、增强、生成。课程讲得非常清楚,不只是给你看代码,而是让你真正理解每一步在做什么、为什么这样做。
四、用 Agent Bricks 搭建检索链
当核心的检索和生成逻辑跑通之后,课程进入了更高级的环节:用 Agent Bricks 来构建和部署 RAG 工作流。Agent Bricks 是 Databricks 平台上的一套工具,能帮你把 RAG 流水线封装成一个可复用、可调度的工作流组件。
这一节的重点是把"能跑通"变成"能交付"。你会学到怎么把前面搭好的检索逻辑封装成标准化的模块,怎么定义输入输出的数据格式,怎么让这个流水线可以被其他系统调用。对于想要把 AI 能力嵌入到现有业务流程里的企业来说,这一步至关重要。
五、生产环境的构建与优化
最后一节是整门课的精华:怎么把 RAG 流水线真正部署到生产环境,并且持续优化它的表现。
生产环境远不是写几段代码跑通了就完事。你要考虑响应速度能不能撑住真实的用户量、检索结果准不准、生成的答案可不可靠、成本能不能控制住。课程会针对这些问题给出具体的优化策略,比如怎么调整检索的召回数量、怎么优化提示词让模型更好地利用检索到的内容、怎么监控流水线的运行状态。
课程还附赠了非常实用的配套资源:一份完整的检查清单和速查表帮你复习关键步骤,一份完整的 RAG 流水线代码参考可以直接拿来做模板,一份常见问题解答覆盖了实操中容易踩的坑,以及一份启动笔记本让你可以从头开始跟着搭建。这些资料的价值不亚于视频本身,遇到问题时随时翻一翻能省下大量排查时间。
学完这门课你能拿到什么?如果你是一名数据工程师或者 AI 应用开发者,你会掌握在 Databricks 平台上从零搭建生产级 RAG 系统的完整方法论,不再只是跑通一个 demo,而是真正理解每一步背后的工程考量。如果你是一名技术管理者或者业务负责人,你会清楚地知道 RAG 项目落地需要哪些组件、哪些环节容易出问题、团队需要具备什么样的能力。这门课不长,但每一节都是干货,没有废话,适合那些想在短时间内快速掌握 Databricks RAG 开发全流程的学习者。