资源介绍
视频数量:27个
总时长:4小时34分
课程介绍:
面向数据科学家的数据可视化
你花了几天时间清洗数据、跑模型、调参数,最后得到了一组不错的结果。问题是,当你要把成果展示给产品经理、客户或者公司高层时,屏幕上的折线图和柱状图看起来平淡无奇,甚至有些杂乱。对方看了三秒钟,点点头说"嗯,不错",然后会议就结束了。你心里清楚,这些图表明明承载着重要的发现,但它们就是没能替你把故事讲出来。
如果你有过类似的经历,这门课就是为你准备的。
这门课叫"面向数据科学家的数据可视化",总时长四个半小时左右,27节课,节奏紧凑但不会让人喘不过气。它的核心目标很直接:让你做出来的图,不仅数据准确、逻辑清晰,还要在视觉上能抓住人,让看图的人在几秒钟之内就理解你想表达的核心信息。
课程的第一章是入门介绍。除了欢迎辞和项目说明,老师还贴心地提供了课程用的所有 Jupyter Notebook 仓库链接,并且考虑到很多学员可能没有本地 Python 环境,专门给出了 Google Colab 的替代方案。这意味着你只要有浏览器,就能跟着练。
第二章讲的是"为你的受众定制可视化"。这一章特别关键,因为数据科学家的一个常见误区是,把图做给自己看。课程会区分两种截然不同的可视化目的:探索性可视化和解释性可视化。前者是你在分析过程中用来理解数据的,后者是讲给别人听的。两者在选图、设计、细节处理上的逻辑完全不同。老师还会专门讲"上下文"的重要性——同一个数字,放在不同的背景里,传递的信息可能完全相反。
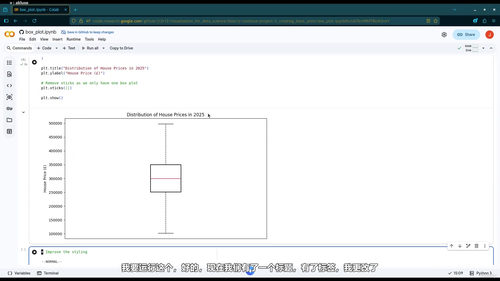
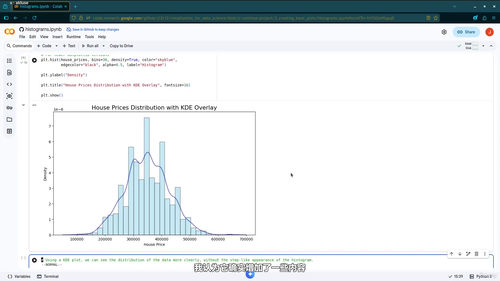
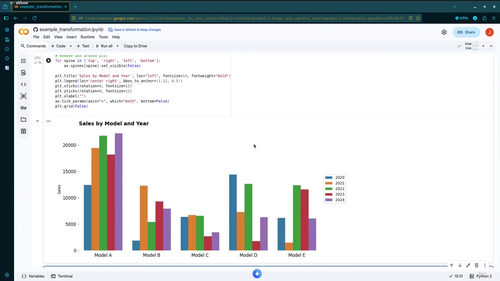
第三章进入实操环节,开始画基本图表。从最简单的折线图、柱状图讲起,然后过渡到直方图、箱线图、散点图,并介绍如何与 Pandas 数据框结合使用。直方图那一节讲得特别细,不仅教你怎么画,还会告诉你它在数据科学里能用来做什么——比如诊断数据质量、发现异常值、观察分布的偏斜和长尾、辅助模型选择,甚至做数据漂移检测。箱线图部分则把五个汇总统计量和四分位距的概念讲得非常清楚,还解释了什么是统计意义上的离群点。这一章最后有一个练习,让你动手巩固。
第四章是设计层面的提升,讲认知负荷和预注意属性。什么是预注意属性?简单说就是人眼在不需要刻意思考的情况下就能感知到的视觉特征,比如颜色、形状、大小、位置。好的可视化会利用这些特征把最重要的信息"弹"到观众眼前。课程里有一个叫"把铅变成黄金"的实操环节,演示如何把一个平平无奇的图一步步改造成专业水准的作品。看完那个演示,你对"好图和差图"的区别会有非常直观的感受。第四章末尾还有第二个练习。
第五章有点进阶,讲面向对象编程。如果你是 Python 基础比较薄弱的学员,这一章可能会稍微吃力。但老师讲得比较克制,只讲跟 Matplotlib 相关的 OOP 概念,目的是让你后面能灵活定制图表的各个组件,而不是只能套用现成的模板。这两节课看完,你对 Matplotlib 的理解会上一个台阶。
第六章讲样式。Matplotlib 的默认图表风格偏学术,看起来有点朴素。但其实它内置了很多样式表,可以一键切换成完全不同的视觉风格,比如模仿 ggplot、fivethirtyeight、seaborn 等流行设计。老师会带你探索这些样式,教你怎么全局设置、怎么针对单个图表设置,最后还会讲到样式表的进阶用法。这一章学完,你的图基本就能脱离"程序员风格"了。
第七章是课程的实战高潮,做一个真正的机器学习项目。老师会带你走一遍完整的数据科学工作流,在这个过程中用上前面学过的所有可视化技巧。模型训练过程中的损失曲线、特征分布、预测结果对比,这些图都会出现在项目里。最后还有一个练习,让你独立完成一个类似的展示。
第八章是总结,回顾整个课程的核心要点。
总的来说,这门课适合有一定 Python 基础、平时在用 Pandas 和 Matplotlib、但图表质量一直上不去的数据科学从业者和学生。如果你的工作经常需要把分析结果展示给非技术受众,这门课尤其值得一看。学完之后,你至少能做出让领导多看两眼的图表。