资源介绍
视频数量:26个
总时长:2小时34分
课程介绍:
让AI真正读懂你的数据仓库
你有没有遇到过这种情况:公司花了大力气接入AI助手,让它帮忙查数据、做报表,结果它给出的答案驴唇不对马嘴?问营收,它从三张表里随便挑了一张,数据口径完全对不上;问客户数,它把潜在客户和正式客户混在一起算;问到管理层面前,被追问一句"这个数字怎么来的",整个团队都哑火了。
问题出在哪?不是AI不够聪明,而是你的数据仓库从一开始就没为AI准备好。
这门课就围绕一个核心问题展开:怎么把现有的数据仓库改造成AI真正能用的样子。整个课程用一家虚构公司NovaBridge Analytics作为案例,26节课,总时长两个半小时多一点,跟着它的改造过程走一遍,你会发现自己面对的那些难题,几乎都能找到对应。
一、搞明白AI为什么总出错
课程一开始,先别急着动手改。先搞清楚AI在你的仓库里为什么会迷路。
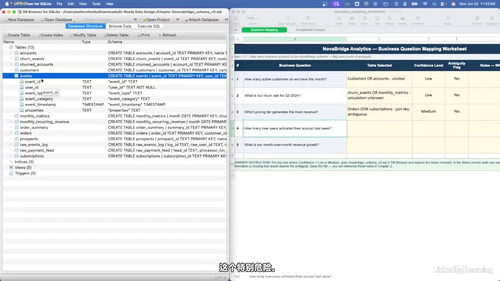
讲师会带着你做一件事:摆出三张都声称能回答"营收"问题的表,然后让AI去选。看它选哪张、为什么选错。再把问题稍微改一改,比如加上时间范围、加上地区筛选,看AI是不是又跑去另一张表拿数据了。
这一段特别过瘾的地方在于,它不是抽象地讲"歧义性",而是把真实的失败案例摊开来给你看。NovaBridge仓库里有四种典型的失败模式:表名相似但含义不同、字段同名但口径不同、没有文档说明AI只能猜、文档有但写得含含糊糊。这些坑,你在自家仓库里大概率都踩过。
讲完问题,紧接着讲代价。一个错误的数字进了董事会汇报PPT,意味着什么?讲师会把这个场景具体化,让你直观感受到"数据不够AI友好"这件事的真实代价,而不只是停留在理论层面。
二、把数据模型重新设计一遍
看清楚问题之后,进入第二章,开始动手改。
这一章的核心动作叫"规范化数据集"。说白了就是把那些功能重复、口径混乱的表合并成一张。比如NovaBridge原来有Orders、Order Summary、Monthly Reoccurring Revenue三张表都涉及收入,三套定义、三种算法,AI当然分不清。课程会演示怎么从这三张表里提炼出一张规范化的Orders表,让所有收入问题都指向同一个数据源。
合并的过程中有四个关键决策要做:哪张表是事实来源、用什么口径计算收入、字段怎么命名、行级粒度怎么定义。每个决策背后都有具体的SQL操作和判断依据,不是空讲原则。
还会讲到客户数据的合并。Accounts、Clients、Prospects,这三个词在不同公司有不同含义,在NovaBridge的仓库里也各自代表不同的东西。课程演示了怎么用一个统一的客户模型把这些差异抹平,同时保留必要的业务区分。
命名规范是这一章的另一个重点。好名字能让AI在查询阶段就避开歧义,比如统一用is_active而不是active和enabled混着来。粒度文档则是教你怎么明确告诉AI"这张表的每一行代表什么",是一个订单、一笔交易、还是一个客户的一个月行为。学完这章,你能在自己的仓库里跑一遍同样的诊断:哪些表可以合并、哪些字段命名需要统一、哪些表缺粒度说明。
三、把元数据当成基础设施来写
第三章是整门课最让人眼前一亮的部分,讲的是元数据,但不是传统意义上放在数据字典里的那种静态文档,而是把元数据当成AI和数据之间的接口来设计。
为什么元数据变得这么重要?因为当AI自己去探索你的仓库时,它能看到的只有表名、字段名和注释。如果这些信息写得含含糊糊,AI就只能猜,猜错了就是上面那种灾难性的结果。
课程会教你怎么写列描述。不是"这是用户ID"这种废话,而是"这是客户在系统中首次被识别为有效线索的日期,用于计算转化漏斗的起始点",具体的、可操作的、AI能据此判断用不用得上的描述。
指标定义是另一个硬骨头。同样一个"流失率",产品部门算的、销售部门算的、财务部门算的,可能完全是三个数。课程演示了怎么把churn_rate这个指标的定义锁定下来,写进元数据里,让所有部门、所有人、包括AI,都用同一个公式。
还有"路由触发器"这个概念,教你怎么告诉AI"遇到这类问题先去看哪张表"。以及"陷阱标记",明确告诉AI哪些假设绝对不能做,比如"这张表里的金额不包含退款""这个字段在2023年之前的数据是手工录入的,可能有误差"。这一章结束后,NovaBridge的数据目录从一堆干巴巴的表名和字段说明,变成了AI能真正读懂的导航地图。
四、治理、所有权,以及怎么交出一个能用的仓库
最后一章解决的是"怎么让改造成果持久保持"的问题。
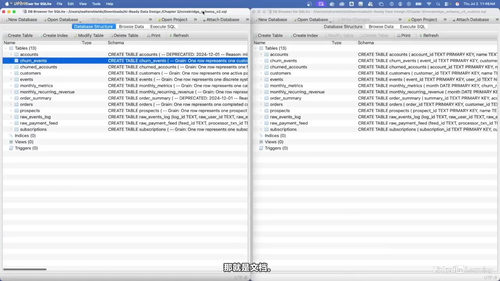
数据仓库的改造最怕什么?最怕改完了没人维护,过三个月又乱成一锅粥。课程讲了一个很实际的话题:怎么跟团队沟通,让大家都认同某张表该被弃用。不是技术问题,是人的问题。讲师会演示一次完整的对话和代码提交流程,先确认仓库里有没有这张表的弃用标记、验证替代表能不能覆盖所有使用场景、检查有没有视图或触发器还在依赖它、最后在事务里执行删除,失败就回滚。每一步都有对应的SQL操作和文档记录。
所有权模型也很关键。每个AI就绪的数据资产都得有一个明确的负责人。这个人不是来干活的,是来拍板的,字段定义有歧义找他、表该不该合并找他、AI给出的答案对不对找他。把责任落到具体的人头上,仓库才不会变野。
课程最后会教你跑一次"AI导航测试",用几个真实的业务问题去问AI,看它能不能准确找到对的表、给出对的口径。这个测试可以反复跑,作为衡量仓库AI就绪程度的一个标尺。
学完这门课,你收获的不只是一堆概念,而是一套可以直接拿回去用的检查清单和操作流程。从诊断现有仓库的歧义问题,到重新设计数据模型,到写AI能读懂的元数据,再到建立治理和所有权机制,每一步都有具体的操作示范。
这门课特别适合数据工程师、数据分析师、数据架构师,还有那些正在推进AI落地、但发现AI总是给出错误答案的业务负责人。如果你管着一个数据团队,正在头疼怎么让AI真正帮上忙而不是帮倒忙,这门课会给你一条清晰的改造路径。NovaBridge这个虚构案例设计得很巧妙,几乎每一种典型的数据仓库问题都在它身上出现过,所以你学的不是抽象原则,而是一套可以照着做的具体方法。