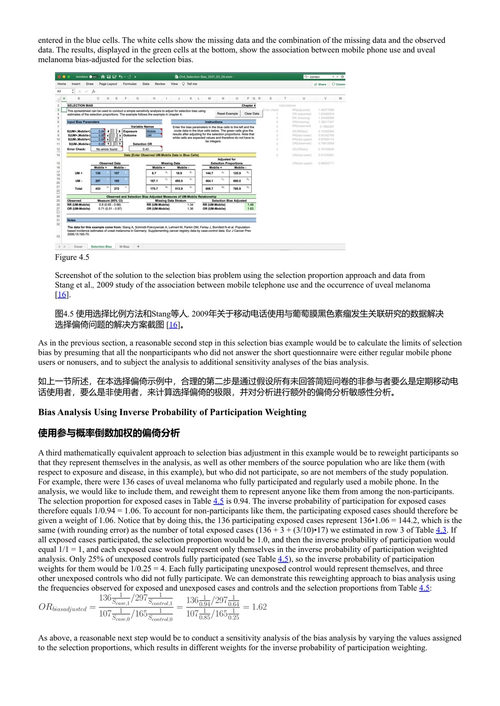
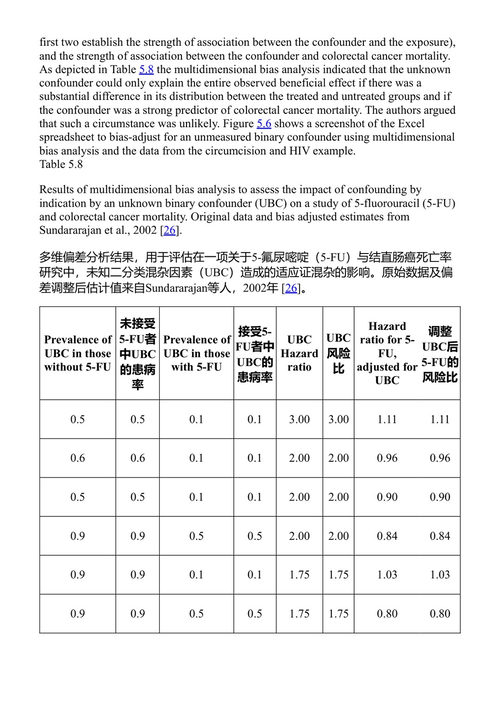
资源介绍
如果你在流行病学研究中曾经面对过这样一个困境:明明设计严谨、数据干净、统计方法也无懈可击,结果却和预期或他人的发现大相径庭,而你又没法用"运气不好"一笔带过,那么这本书或许正是你需要的。作为Springer"生物学与健康统计学"系列中的一本专著,本书由波士顿大学、明尼苏达大学以及埃默里大学的三位流行病学方法学家合力撰写,2021年推出了第二版。坦白讲,这不是一本适合在地铁上翻翻的科普读物,它针对的是那些真正在和流行病学数据打交道的研究者和研究生,但如果你恰好属于这个群体,那这本书的价值会远超你的预期。书的核心议题非常明确:在流行病学研究中,几乎没有一项观察性研究能够完全规避系统误差,也就是所谓的"偏倚"。传统的做法是在论文讨论部分用一两段文字轻描淡写地列出局限,然后丢下一句"我们的结果不太可能受到显著影响"就草草收场。但作者们认为,这种做法远远不够——偏倚不应该只是被承认,更应该被量化。本书从偏倚分析的必要性讲起,依次铺开了选择偏倚、分类误差和未控制混杂这三大对研究有效性构成根本威胁的议题,每一类都配以简洁的偏倚分析方法。更值得称道的是,第二版在第一版基础上做了大幅扩充,把概率偏倚分析拆分成汇总数据和记录级数据两个层面来阐述,还新增了直接偏倚建模和贝叶斯偏倚分析两个独立章节,前者着重处理连续型暴露、协变量和结局的测量误差,后者则为全书许多方法提供了理论根基。作者们不仅讲了"是什么"和"为什么",还配上了可以直接使用的电子表格和代码,这在方法学教材里是相当难得的。书的最后两章讨论了偏倚分析结果的呈现和解读,帮助研究者把分析报告完整地嵌入到论文之中。读完前言我最认同的一点是,作者们反复强调,一旦你真正完成过一次偏倚分析,就会很难再回到那种"列几条局限性就完事"的旧习惯里去了。这本书适合那些对流行病学研究有基本认识、掌握一定数据分析技能的人,可以作为独立参考书在研究过程中随时查阅,也适合作为流行病学方法课程或高级数据分析课程的教材使用。对于期刊审稿人和研究导师来说,书中的思路同样值得借鉴——毕竟,推动定量偏倚分析走向普及,不能光靠方法学家的呼吁,更需要整个学术共同体在评价研究时把标准抬起来。