资源介绍
视频数量:14个
总时长:3小时56分
课程介绍:
AI成本优化实战——大幅降低大模型API开销
你有没有盯着后台账单发过呆?上个月还在用GPT写写文案、改改代码,这个月一上量,API费用直接翻了五倍。Token像自来水一样哗哗流,钱包却不是自来水管——没有无限量。这种焦虑,用过大模型API的人几乎都经历过。市面上教你怎么调API的教程一大堆,但专门教你怎么省钱、怎么优化成本的课程,非常稀少。这门课就是冲着这个问题来的。
整个课程总共不到四个小时,但信息密度很高,讲的不是泛泛而谈的原则,而是可以直接落地到代码里的具体策略。课程用一个清晰的四层架构来组织内容,每一层都在不同维度上帮你压低成本。学完之后,你会拥有一套完整的成本控制思维框架,而不是零散的几个小技巧。
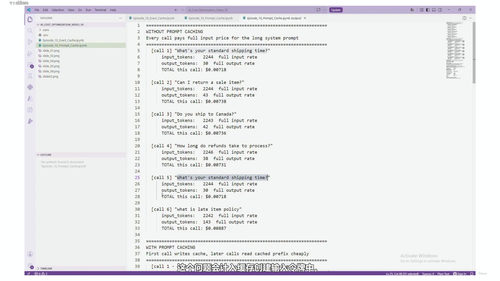
第一层是认识成本。学优化之前,先得搞清楚钱花在了哪里。课程从最基础的地方讲起:所有大模型——GPT、Claude、Gemini、DeepSeek——背后用的都是同一种通信语言,叫REST API。一旦你理解了这层原理,就从"在网页上跟AI聊天的用户"变成了"通过代码调用AI的工程师"。这一层会讲清楚消费者和开发者两种使用方式的本质区别,以及如何计算Token费用。很多人对成本没有概念,就是因为不了解Token到底怎么计费的。
第二层,控制输出成本。大模型回答你的问题时,输出的每一个字都在花钱。让模型啰嗦八百字和让它精炼到一百字,成本可能差好几倍。这一层教你两招:一是通过更好的提示词指令来减少输出Token,二是设置最大Token上限作为安全阀,防止模型失控地输出超长内容。这两个技巧看似简单,但很多人并没有真正掌握提示词该怎么写才能既精简又有效。
第三层,控制输入成本。除了输出,你发给模型的上下文同样在烧钱。这一层讲了四个关键技术:滑动上下文窗口让你只保留最近相关的对话内容;对话历史摘要把冗长的聊天记录压缩成精炼的总结;提示词压缩在不丢失核心语义的前提下精简输入文本;RAG检索增强生成则让你只检索相关的文档片段喂给模型,而不是一股脑全塞进去。这四个方法单独用都有效果,组合起来威力更大。
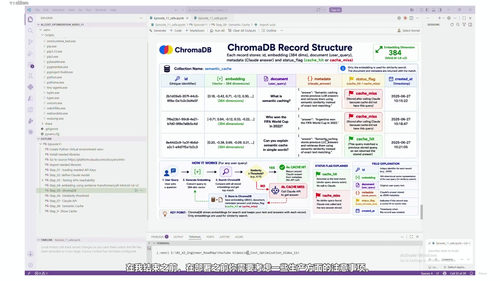
第四层,减少API调用次数。有时候不是单次调用太贵,而是调用了太多次根本不必要的请求。这一层从缓存机制入手,先讲精确匹配缓存——同样的问题直接返回缓存答案,不再调用模型;再讲语义缓存——意思相同但措辞不同的问题也能命中缓存,因为系统比较的是语义而不是字面字符串。最后还讲了用户级别的速率限制,防止个别用户刷量把预算耗光。这部分内容是很多开发者在实际项目中最容易忽略的优化点。
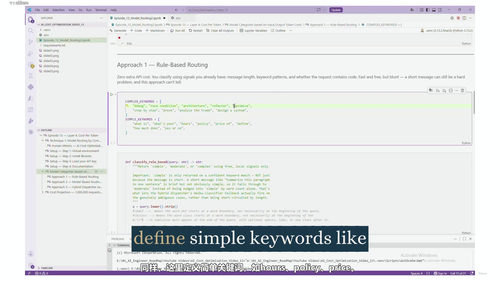
第五层,降低单Token成本。当你的系统已经优化到很难再减少调用次数时,还有一招:根据任务复杂度路由请求。简单问题用便宜的小模型,复杂问题才用昂贵的大模型,这样整体成本能再降一个台阶。课程最后还讲了批量API,对于不需要实时返回结果的任务,用异步批处理接口能拿到更低的价格。
这门课适合谁?适合已经在用大模型API做项目、但账单越来越高的开发者;适合负责AI产品技术选型和成本预算的技术负责人;也适合从Demo阶段走向正式上线、需要认真考虑单位经济模型的创业者。它不适合完全没用过API的纯新手,但也不要求你是什么资深架构师——只要你会写基本的代码,理解这套优化体系的逻辑完全没有障碍。
学完这门课,你最大的收获不是记住几个参数怎么调,而是建立起分层优化的思维习惯。下次再遇到成本问题,你会自然地拆解:是输出太长、输入太冗余、调用太频繁,还是模型选得太贵?每一层都有对应的解法,而你掌握了一套可以反复使用的分析框架。在这个AI能力越来越强、调用量越来越大的时代,能把每一分钱花在刀刃上,本身就是一种核心竞争力。