资源介绍
视频数量:48个
总时长:4小时36分
课程介绍:
AI智能体保障:评估、幻觉与监控实战
想象这样一个场景:你负责的AI智能体已经上线运行三个月,业务部门反馈"看起来还行",用户也没怎么投诉。但某天审计师突然问了一句"你怎么证明它真的在工作",你发现自己根本拿不出像样的证据——没有系统的评估方案,没有幻觉发生频率的台账,更没有一套在出问题时能快速定位根因的监控体系。这种窘境,恰恰是这门课想要帮你摆脱的。
这门课不讲怎么写更好的提示词,也不比较哪家大模型的接口更好用。它聚焦的是一件更底层、却很少有人系统讲过的事:怎样为AI智能体建立一套完整的保障体系,让"看起来还行"变成可以交给审计师、监管方和业务高管的东西。课程用一个虚构的保险公司"Halden保险"及其三个智能体作为贯穿全案的案例,让你在真实的业务场景中走完整个保障闭环。
一、保障这件事为什么跟传统测试不一样
课程开篇先厘清一个关键概念:AI保障不是测试,也不是治理,它是介于两者之间的新事物。传统软件测试问的是"输出对不对",而AI保障问的是"你有什么证据,应该有多大信心"。它衡量的是一种行为分布,需要抽样而非穷尽,最终产物要拿给第三方看,而不是写给自己团队的周报。课程还会介绍智能体特有的四种失败家族、保障生命周期,以及到底谁该为保障负责,避免出了问题互相甩锅。
二、先定义"正确行为",否则一切免谈
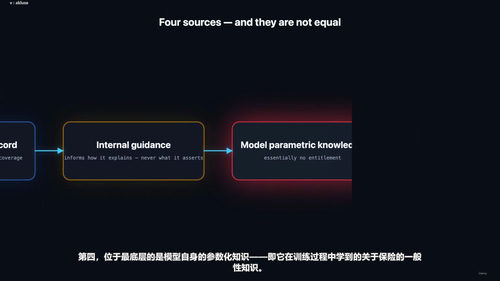
如果连"正确"都没有说清楚,评估就无从谈起。这一章教你写可测试的行为陈述、划定智能体绝对不能触碰的边界,以及声明智能体可以依赖的信息源及其优先级排序——比如合同原文排在第一位,客户记录在事实层面有权威性,但在承保范围判断上不能反推。课程会带你一步一步填写"行为与边界规范文档",后续所有的测试用例、评估脚本都可以追溯回这份文档里编号的行为陈述。
三、面向测试者的风险评估
保障不是要你管住所有风险,而是要知道先测什么。课程教你区分后果等级与发生可能性,给出优先级的判断逻辑,让你把有限的测试资源花在最值得花的地方,而不是平均用力。
四、把幻觉拆开来理解
幻觉不是一个东西,而是一整类问题。课程把它拆成五个子类型:凭空捏造的事实与杜撰的引用、工具调用结果的编造、未锚定的检索与上下文投毒、长会话中逐步丧失的事实依据。理解了这些子类型,你才能针对每一种设计专门的检测方法。
五、设计真正有效的评估
好的评估测的不是表面文字,而是底层质量。课程讲Golden Set的构建方法、基于评分量表的打分机制、用大模型充当裁判时需要注意的陷阱、轨迹评估(看智能体走了什么路径才到达答案),以及对抗性和边缘情况评估。
六、搭建测试用例与评估库
测试用例不是临时凑出来的脚本,而是有结构、可追溯的资产。课程剖析一个智能体测试用例的解剖结构,演示怎样为每一种幻觉类型编写对应案例,并建立回归套件和模型更新触发机制,让每次模型迭代都有据可查。
七、人在回路不能流于形式
人工审核不是一道签字流程,而是一项关键的控制手段。课程讨论审核员校准与一致性协议,帮你搭建人机监督矩阵,明确哪些场景必须由人来兜底。
八、生产环境中的可观测性
上线才是真正的开始。课程讲哪些信号值得捕获、怎样在生产环境中监测质量、成本与延迟的控制要点,以及如何发现静默退化——那种没有报警但答案已经悄悄变差的情况。
九、事故、漂移与持续保障
智能体出问题只是时间问题,关键是出了问题怎么办。课程教你做事故分类与根因定位,判断问题出在提示词、模型、工具、数据还是规范本身,建立事故日志,把事故反哺回评估库形成闭环,最后讨论持续保障的节奏与机制。
十、上线决策与保障报告
最后一章把所有产物拼在一起。课程教你做Go/No-Go决策、撰写发布就绪检查清单与治理保障报告,以及怎样向审计师和高管呈现证据,最后以一个端到端的综合演练收尾。
学完这门课,你会带走什么?不是某个工具的使用手册,而是一套完整的保障方法论和一份可以直接套用的保障包模板。不管你是QA工程师、测试负责人、AI产品经理,还是需要在企业里建立AI治理体系的负责人,这门课都能帮你从"凭感觉判断"转向"用证据说话"。