资源介绍
视频数量:30个
总时长:2小时13分
课程介绍:
数据科学中的探索性数据分析
你有没有过这样的经历:拿到一堆数据,满怀信心地准备分析,结果发现里面缺值满天飞、格式乱得不行,好不容易清理完,又不知道该从哪儿下手分析。这几乎是每个和数据打交道的人都会遇到的困境。探索性数据分析,也就是常说的EDA,正是解决这个问题的关键环节。它不是那种高深莫测的建模技术,而是一种"看懂数据"的能力——在你把数据丢给机器学习算法之前,先用统计方法、可视化工具和逻辑推理,把数据的脾气摸透。这门课就是带你系统掌握这套方法。
整个课程大约两个多小时,分成六个部分,循序渐进,从最基础的数据加载到最终的假设检验,每一步都有理论讲解加Python代码实战。
一、数据加载与数据清洗
分析的第一步永远是把数据拿到手,并且弄干净。课程会教你如何用Pandas加载CSV和Excel格式的数据文件,然后进行初步的清理工作。数据清洗听起来简单,实际上坑很多:缺失值怎么处理,直接删掉还是用均值填充,异常值要不要剔除,重复数据怎么去重,这些决策直接影响后续分析的结果。课程通过一份身高体重数据,手把手带你走完整个清洗流程。
二、单变量分析——看懂一个特征
清洗完数据,接下来就是分析。课程花了大量篇幅讲单变量分析,因为这是理解数据最基础也最重要的一步。
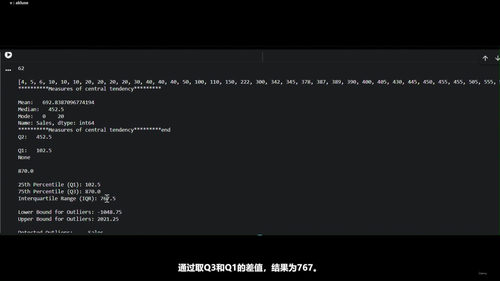
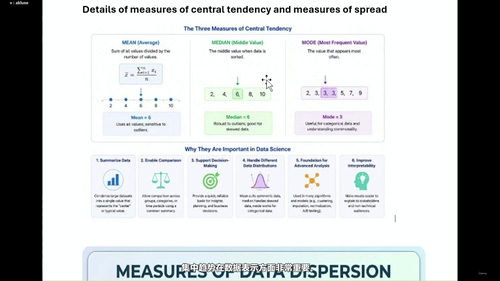
你会学到集中趋势的度量,包括均值、中位数、众数,各自适用什么场景。比如均值容易被极端值拉偏,而中位数更稳健,这种区别在实战中很关键。离散程度的度量同样重要:方差、标准差、四分位距,这些数字告诉你数据有多分散。课程会用一份真实的销售数据和身高体重数据,演示如何用Python计算这些统计量。
分布形态是单变量分析的重头戏。课程详细讲解了正态分布,也就是高斯分布或钟形曲线,这是数据分析中最常见的分布形态。你会学到概率密度函数的概念,理解为什么连续数据要用密度而不是精确概率来描述。除了正态分布,课程还讲了标准正态分布(均值为零、标准差为一的特殊形式)、均匀分布、泊松分布(常用于描述单位时间内事件发生的次数,比如一小时进店的顾客数)、二项分布(只有两种结果的独立重复试验,比如抛硬币)。每种分布都配有一段Python代码演示,用matplotlib和seaborn把曲线画出来直观地看。
箱线图是单变量分析中的明星工具,能一眼看出数据的四分位数、中位数,还能识别异常值。课程专门用两节课讲箱线图,先讲原理,再用样本数据动手画。
三、双变量与多变量分析——看特征之间的关系
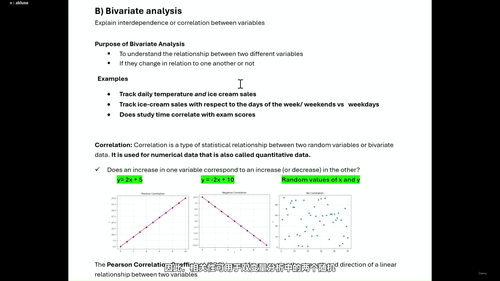
单变量分析只能告诉你单个特征的"模样",但实际工作中我们更关心变量之间的关系。比如广告投入和销售额有没有关联,员工满意度和工作年限有没有关系,这些就是双变量和多变量分析要解决的问题。
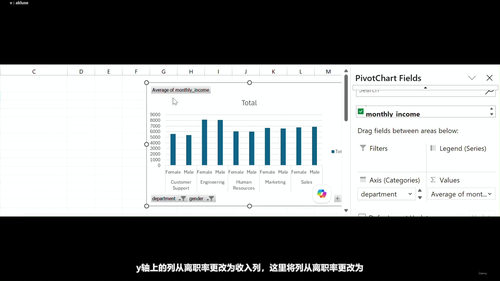
课程会讲相关性分析,用相关系数量化两个变量之间的线性关系强度和方向。Python代码部分会演示如何用Pandas和Seaborn计算并可视化相关系数矩阵。多变量分析里,数据分组和透视表是非常实用的技能。当你面对一个包含上千条记录的数据集,想按部门、性别、年龄段分组统计时,光靠脑子想肯定不行。课程会教你如何用数据透视的方式快速汇总信息,找到隐藏在数字背后的规律。
四、员工流失数据分析实战
理论讲得再多,不如来一个真实场景。课程第五部分用一份员工流失数据,带你做一次完整的EDA实战。这个数据集来自HR领域,包含员工的各种属性和是否流失的标记,是数据科学入门的经典案例。
这个部分首先覆盖了实战中绕不开的技能:分类变量编码。机器学习算法大多只能处理数值,但很多字段是文字的,比如性别、部门、职位等级。你需要把这些文字转换成数字,同时保留它们的信息,这里有多种编码方式,各有优缺点。
接着你会学到如何用Groupby按性别、按部门和性别的组合做分组统计。比如各部门男女员工的比例是多少,各部门平均工资的差异,流失率在不同部门间有什么不同。课程用Python代码分两部分演示整个分析过程,你可以跟着一步步做,把前面学的分布知识和可视化方法综合运用起来。
五、假设检验——用数据回答问题
数据分析的终极目标是用数据回答问题。但很多时候,我们手里的只是样本数据,怎么从样本推断总体,这就需要假设检验。课程先讲数据采样,理解为什么样本要随机、要有代表性。然后进入假设检验的核心:先提出一个原假设和一个备择假设,比如新方案比旧方案效果好,然后收集数据,计算检验统计量,看看这个统计量在原假设成立的情况下有多大概率出现。如果概率太小,通常小于百分之五,就拒绝原假设。
双侧检验是假设检验里最常用的形式,课程专门用一节课讲它的原理和Python实现,配合前面讲的正态分布知识,帮你把整个统计推断的逻辑串起来。
六、适合谁来学
这门课的节奏偏实战,适合已经掌握Python基础语法,特别是Pandas、Matplotlib、Seaborn库的基本使用,但还没系统做过数据分析的人。如果你正在准备转行做数据分析师,或者在工作中需要用数据支持决策但只会写代码不会分析,这门课会帮你把分析这块短板补上。统计学基础不是必需的,课程会从概念讲起,但有一点数学直觉会让学习更顺畅。
学完这门课,你能独立完成一个数据集从加载、清洗、探索分析到初步统计推断的完整流程。说到底,机器学习模型可以调包,但分析思维和统计直觉不是调包能解决的,而这正是这门课想交给你的东西。