资源介绍
视频数量:16个
总时长:4小时17分
课程介绍:
从统计思维到机器学习算法
手机放在桌面上,摄像头抬起的一瞬间,手机为什么能认出主人?视频网站为什么能猜到你可能喜欢的内容?地图为什么能找到更省时的路线?这些功能背后,是系统从大量数据里找到规律,再完成判断、预测和推荐。机器学习研究的正是“从数据中学习”的方法。
课程由十六个视频组成,总时长四个多小时。它从人工智能的日常应用切入,再沿着有监督学习的主线,依次认识回归、分类、模型评估和泛化问题。内容不求堆砌术语,而是把算法放回真实问题中,说明模型如何学习、怎样判断结果,以及什么时候会失灵。
一、从日常智能进入机器学习
第一部分从人工智能的应用开始:语音助手听懂指令,视频平台推荐内容,地图估算路程和到达时间,人脸识别判断身份,聊天工具根据问题组织回答。看起来是完全不同的产品,背后却有相似的流程:收集数据,提取有用信息,输出预测或决策。
理解人工智能之后,课程回到机器学习本身。模型不是凭空理解世界,而是在样本中学习模式;新数据到来时,模型要依据学到的规律作出判断。数据、特征、结果和预测之间的关系,是理解后续算法的基础。学完后,你能说清机器学习与人工智能的联系,也能判断一个问题该用明确规则,还是该让模型从经验中找规律。
二、用回归模型处理连续结果
回归部分先从简单线性算法开始。当一个结果主要和一个因素有关时,可以从已有数据中寻找变化趋势,再用这条趋势估计未知情况。影响因素不止一个时,课程进一步进入多元线性回归,帮助你理解多个变量如何共同影响结果,而不是只凭一个因素下结论。
模型作出判断后,不能只看预测值本身,还要看它和真实值相差多少。误差就是实际结果减去预测结果;预测偏低时误差为正,预测偏高时误差为负。平均绝对误差把每次偏差的绝对值放在一起平均,适合观察预测通常偏了多少;均方误差会放大较大偏差,帮助识别不能忽视的严重错误;决定系数则帮助理解模型对结果变化的解释能力。不同指标回答的问题不同,只有把数值和具体情境联系起来,评估才不会变成机械打分。
课程还专门讨论偏差与方差。模型过于简单,可能抓不住数据里的主要规律;模型过于复杂,又可能把偶然波动当成规律。理解这两者的拉扯,才能知道一个模型为什么在当前数据上表现不错,换一批数据却失灵。
三、让分类结果经得起检查
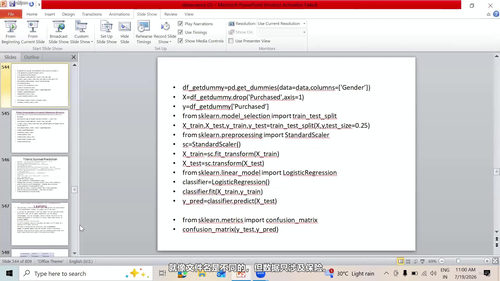
回归任务关心数值预测得准不准,分类任务则关心类别判断对不对。混淆矩阵会把正确判断和错误判断分别摊开,让你看到模型究竟把哪些样本认对、哪些样本认错,而不是只得到一个漂亮却模糊的准确率。当不同类别的数量差别很大时,少数类别的漏判和误判尤其值得留意;看清错误类型,才能判断模型是否真的适合实际场景。
交叉验证解决的是评估结果是否可靠。把数据分成若干轮训练和验证,让模型使用不同组合的样本,能够减少一次随机划分带来的侥幸。训练成绩、验证成绩和测试成绩要分开看,模型表现稳定,换到新数据仍有效果,才说明它学到的不只是眼前这批数据。
四、分类算法的不同思路
逻辑回归虽然名字里有回归,却常用于分类。它把输入信息转化为结果发生的可能性,再根据界限决定样本属于哪一类。学习这一节,重点不只是记公式,还要理解概率判断和阈值选择之间的关系。
最近邻算法采用更直观的方式:先计算新样本与已有样本之间的距离,再观察它周围哪些类别出现得最多。邻居数量、距离尺度和数据分布都会影响结果,因此邻居数量不是随意填写,而要结合验证结果反复比较。欧几里得距离让“谁离它更近”变成可以计算的依据,类别判断也就不再只靠感觉。
朴素贝叶斯算法从概率角度处理分类任务。课程会说明它如何依据特征出现的情况比较不同类别的可能性,并通过实现环节把计算过程落到具体步骤上。它建立在一定的条件独立假设上,正因为假设清楚,模型容易解释,也适合作为很多分类问题的起点。支持向量机算法关注不同类别之间的分隔边界,课程通过分类问题呈现寻找更合适分隔面的思路,让你能比较不同算法解决问题的方式。
五、在模型复杂度之间取得平衡
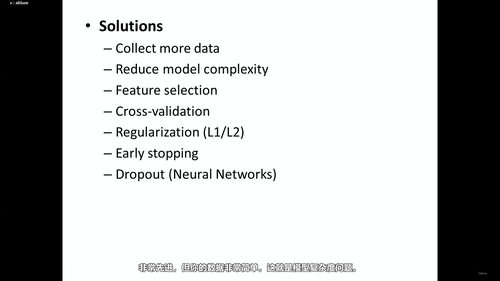
过拟合和欠拟合,是学习模型时很容易遇到的两种状态。欠拟合时,模型连训练数据中的主要趋势都没有掌握;过拟合时,模型对训练数据过分熟悉,遇到新样本却表现变差。多项式回归把关系从直线扩展到曲线,帮助你看到:真实关系不是简单线性时,增加复杂度可能改善预测,但越复杂越要警惕噪声和偶然波动。偏差与方差、交叉验证以及训练和验证结果,在这一部分会被连成一条完整的判断线索。
六、适合的学习者与学习收获
这门课适合刚开始接触机器学习、想知道算法究竟在做什么的人,也适合学过一些代数和统计知识,想把公式与实际模型联系起来的学习者。如果正在准备数据分析、编程建模或人工智能方向的入门学习,它可以帮助你先建立清楚的概念框架;如果曾被准确率、训练效果和模型选择弄混,课程也会带你把评价标准理顺。
学完后,你能够区分回归与分类任务,解释简单线性、多元线性、逻辑回归、朴素贝叶斯、最近邻和支持向量机等方法的基本思路;能够读懂平均绝对误差、均方误差、决定系数、混淆矩阵和交叉验证的结果;还知道过拟合、欠拟合、偏差和方差意味着什么。面对新的预测或分类问题,你不会只凭“模型跑通了”就下结论,而会从数据准备、模型训练、结果评估到问题诊断逐项思考。四个多小时的学习不长,却能把常用概念串成一条看得见的路线,带走面对数据先提出假设、再验证假设、最后根据误差调整判断的统计思维。