资源介绍
视频数量:5个
总时长:1小时8分
课程介绍:
掌控AI数据治理:让机器学习不再失控
一个普通人去申请贷款,毫秒之间就被拒绝了。做出这个决定的不是银行职员,而是一个模型。这个模型所依赖的训练数据里某处混进了一行错误记录,模型悄无声息地学到了这个错误,然后在无人察觉的情况下把它重复了上千次。这不是科幻小说的情节,而是当下数据治理从业者每天面对的真实风险。
过去我们做数据治理,管的是报表和仪表盘。仪表盘里出现一行错误数据,很快就会有人发现并纠正。但当同一行错误数据被喂给一个机器学习模型时,没有人会发现它,因为它已经嵌入了自动化决策的深处。这意味着,同样的数据,在AI时代承担的风险完全不一样了。这门课就是来帮你应对这个转变的。
一、为什么AI改变了数据治理
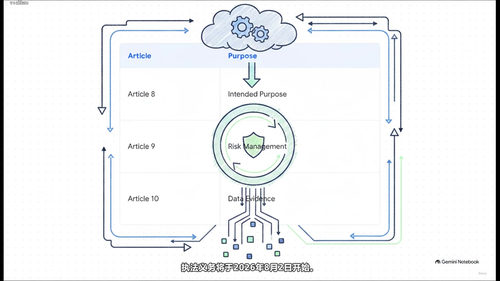
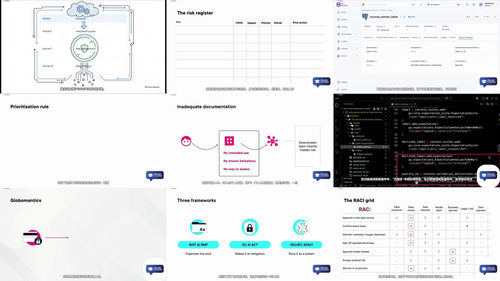
很多人对数据治理的理解还停留在数据要准确、要完整、要安全这个层面。这没有错,但在AI时代远远不够。当数据不只是支撑报表,而是直接驱动模型做出决策时,治理的维度就变了。你需要关心的不再只是数据本身的质量,还包括数据的来源是否合法、是否存在偏见、模型上线之后表现是否稳定、出了偏差能不能及时发现。这些问题,传统的数据治理框架回答不了。课程第一部分会帮你建立这套新的思维框架,让你理解AI数据生命周期和传统数据生命周期之间的本质差异。讲师Majid会以一家区域消费贷款与保险公司Global Mantix为案例,带你一步步看清AI治理到底管什么、风险藏在哪里。
二、让AI数据变得可追溯
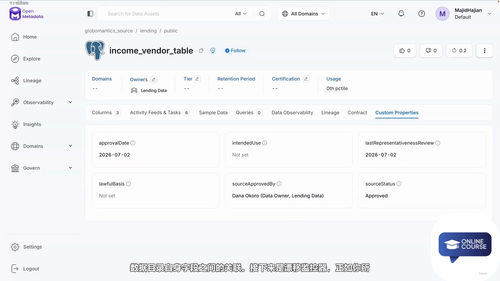
治理如果停留在理念层面,就是空谈。这一部分会带你把治理变成可以落地的工件。课程会教你搭建数据目录、数据沿袭视图和数据出处记录这三套基础设施。元数据回答这是什么数据、谁拥有它、怎么用,沿袭回答数据流向了哪里、产出了什么,出处回答数据来自哪里、在什么权限下获取的。这三个东西配合起来,才能在模型出问题时快速回溯,定位到底是哪一步出了问题。
讲师还会在GitHub仓库里提供一套完整的模板和工具配置,你可以克隆下来跟着操作,也可以留作日后参考。对于那些不想从头造轮子的团队来说,这些现成的工件能省下大量时间。
三、在AI生命周期中设置治理关口
可追溯的数据如果没人去检查,就只是一个漂亮的文档。课程第三部分的核心内容是七个治理关口,它们分布在AI数据生命周期的关键节点上。数据源关口检查数据是否被允许使用、来源是否清楚;文档关口检查数据卡是否完整;评估关口检查测试集是否具有代表性;发布关口要求指定负责人签字确认;监控关口则在上线之后持续观察数据漂移和复用情况。
更实用的是,课程会教你用三个真实的开源工具来落地这些关口。Great Expectations负责数据源关口,MLflow负责发布关口,Evidently负责监控关口。每个工具都配有Python脚本示例,你不需要从零摸索,直接看代码就能理解规则怎么写、流程怎么跑。
四、量化AI风险,建立信任
模型上线之后,怎么知道它是安全的?这一部分会教你从公平性、鲁棒性和可解释性三个维度来量化AI风险。公平性回答模型对不同群体是否存在歧视性差异,鲁棒性回答面对异常输入模型是否依然稳定,可解释性回答我们能不能理解模型为什么做出这个决定。这三个维度不是抽象概念,课程会给具体的评估指标和落地方法。
五、强化学习的特殊治理问题
强化学习跟传统的监督学习不一样,它的风险也更隐蔽。环境沙箱化、奖励黑客攻击、安全探索策略,这些都是强化学习特有的治理难题。课程最后一部分专门讨论如何在强化学习场景下建立三层网络AI治理框架,帮助你在使用RL时也能守住安全底线。
六、配套资源
课程附带了一批可直接下载的实战资源,包括AI合规速查表、AI治理核心模板、治理文案素材库和数据治理AI常见问题解答。这些文档可以直接拿到团队里去用,也可以作为你自己搭建治理体系的起点。
这门课适合什么样的人?如果你正在负责数据治理、数据平台或者AI项目的落地,并且已经意识到传统的治理手段在AI面前力不从心,那这门课就是为你准备的。它不需要你是一个机器学习专家,但需要你对数据工作有一定的基础认识。学完之后,你将掌握一套完整的AI数据治理方法论和工具链,能够在团队中推动治理流程的落地,而不只是写一份放在抽屉里的政策文档。