资源介绍
视频数量:69个
总时长:5小时24分
课程介绍:
R语言与RStudio人口与健康调查数据分析教程
打开一份人口与健康调查(DHS)的原始数据文件,里面躺着几百个变量、上万条记录,光是翻看代码表就让人头皮发麻。这是很多公共卫生研究者和学生在接触DHS数据时的共同感受——数据本身公开可免费下载,但如何把它变成一份能发表的文章,却是横在面前的一道坎。这门课程就是为解决这个问题而设计的,用R和RStudio一步步带你把DHS数据从杂乱无章的原始文件,变成可以直接投稿的统计表格和图表。
课程一共69个视频,总时长约5个半小时,分成11个模块,从最基础的导入数据一路讲到复杂的调查加权回归。整条学习路径是线性的,按顺序跟下来就能走完整个数据分析流程,拿出一份可以投稿的结果。
一、课程导入与数据准备
前两个模块解决入门和导入问题。开头会带你熟悉RStudio的操作环境,了解DHS项目的基本情况——这是一个覆盖全球90多个国家的大型家庭调查项目,坦桑尼亚、埃塞俄比亚、秘鲁、孟加拉国、巴基斯坦、印度等都是成员国。课程以坦桑尼亚数据为例演示,但所有分析代码同样适用于其他国家的DHS数据,你只需替换数据集名称即可,跨国分析毫无障碍。
DHS数据通常以Stata的.dta格式或SPSS的.sav格式分发,每种格式都有自己的一套读取方式。课程会演示如何把这些外部格式的文件顺利读入R,再用代码表逐个核对变量含义,用select()函数从几百个变量中挑出研究所需的那几十个,最后用gtsummary包快速生成初步的汇总表。
二、营养指标的数据管理
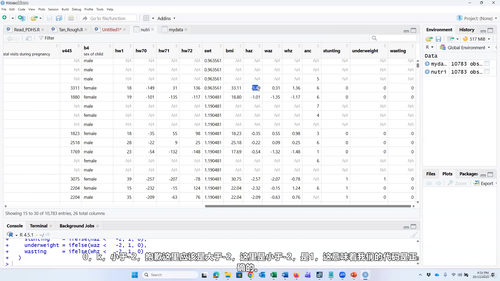
第三个模块是数据管理的重头戏,主题是儿童营养指标。研究儿童营养不良的人都知道,DHS里有三个核心指标:发育迟缓(stunting)、消瘦(wasting)、低体重(underweight),但这些指标在原始数据中并不直接给出,需要根据世界卫生组织标准自己计算。课程会教你如何识别变量中的异常值(比如小数点位置不对、数值明显不合理的情况)、纠正这些可疑值、把异常值替换为缺失值,然后生成标准的营养指标变量。还会演示如何给变量添加标签、调整分类水平的命名、最终把整理好的数据保存为RData文件,方便后续反复调用,省去每次重新清洗的麻烦。
三、描述性分析与调查加权
第四和第五模块是描述性分析,分成未加权和调查加权两个版本。描述性表格看似简单,实际上格式要求很严格:分类变量要写成n(%)的形式,连续变量要写成均值±标准差,小数位数还要统一,p值要标注到合适位置。课程用gtsummary包一步步设置这些格式,加入t检验和卡方检验的p值,再导出到Word文档。
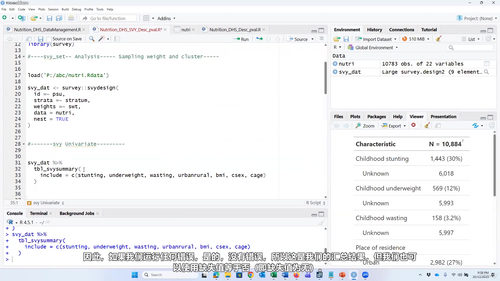
更重要的是第五模块会教你设置调查设计对象(svydesign),让统计分析考虑DHS复杂的抽样结构。DHS采用的是多阶段分层抽样,不加权直接算出来的统计量会有偏,得到的加权p值和标准误才是可以发表的版本。
四、数据可视化
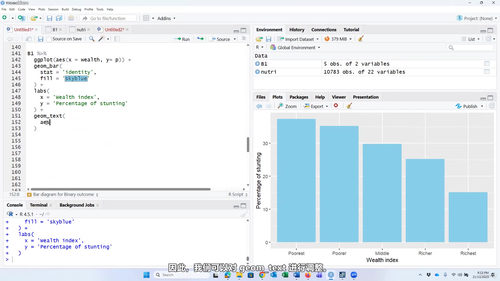
第六到第八模块是可视化部分,全部基于ggplot2包。从最基础的单变量条形图开始,逐步过渡到分组条形图、二元变量交叉展示,最后是连续变量的箱线图。每个图都会演示如何去除冗余的灰色背景、调整坐标轴标签和字体、设置配色方案,直到达到期刊投稿的视觉标准。最后还会教批量导出图片的技巧,把符合要求的图形统一保存到指定文件夹,文件名也能自动命名。
五、回归分析与发表级表格
第九到第十一模块是回归分析部分,也是论文的核心内容。从普通logistic回归讲起,用gtsummary包直接生成粗odds ratio和调整后odds ratio的发表级表格,包括改变参考类别的操作——比如把城市改为参照组或者调整其他分类的基线。然后进入线性回归,处理连续结局变量。最后是整门课的难点——调查加权logistic回归,它把抽样加权和多因素分析两套逻辑结合在一起,需要先生成调查设计对象,再用svyglm函数拟合模型,生成的表格直接就是期刊投稿格式,可以一键导出到Word。
学这门课程不需要太深的R语言基础,只要能看懂基本的赋值和函数调用就行,导入数据部分会逐行演示每一段代码的作用。如果完全没有R基础,建议先花几天时间熟悉一下RStudio的基本操作再来学习。跟完全部内容后,你将能够独立完成从数据导入、清洗、描述性分析、可视化到多因素回归的整套流程,拿出一份符合国际期刊规范的分析结果,省去反复摸索和反复返工的时间,把更多精力放在研究设计和论文写作本身。