资源介绍
视频数量:25个
总时长:2小时27分
课程介绍:
机器学习系统设计面试课
你去面试,对面坐着一位资深工程主管。他抛出一道题:设计一个新闻推荐系统。你深吸一口气,从召回讲到排序,从特征讲到指标,条理清晰,术语专业,连重排和服务都没落下。对方沉默几秒,说:你的回答是正确的,但听起来像排练过的。你心里一沉——明明每一步都对,怎么还是没通过?
这不是错觉。在今天的高级面试轮里,几乎每个候选人都能把那套标准流水线背出来——召回、粗排、精排、指标。流利地走完这一套,已经不足以让你拿到offer。面试官真正在听的,是你的判断力从这道具体题目里长出来了,还是从别处抄来的。
这门课要解决的就是这个矛盾。讲师Ada在开头抛出她的观点:与其背诵万能框架,不如学会在每次面试的开头,用两句话指出这个系统跟别的系统有什么不同。广告系统意味着新鲜度、校准和出价逻辑。附近地点意味着距离过滤和召回策略。有害内容检测意味着标签稀缺和一个会进化的对手。当你能在一分钟内讲出这些,面试官立刻能判断你是在真思考这个系统,还是在套用从别处看来的模板。她把这个方法称为"差异化教义"——在触碰标准流程之前,先亮出你对这个系统独特性的判断。
课程分八个模块。前两个讲面试形式和答题骨架。这一轮是怎么打分的,时间怎么分配,怎么靠澄清问题拿到开局得分。然后介绍一个八步主干——澄清需求、目标、数据与标签、特征、召回、排序、服务、指标——以及主干下面的第二层逻辑。课程里有一节完整演示,用一道你没见过的题目,十分钟走完八步,让你看到高手怎么思考。
第三个模块专门讲数据与标签,篇幅最长,也是大多数候选人投入精力最多却仍然拿不到分的盲区。课程先拆解标签从哪里来:隐式反馈、显式标注、负向互动,每一种背后都有一套完全不同的设计逻辑和工程代价。然后讲负采样里隐藏的曝光偏差、位置偏差、去重逻辑和正负比例——这些细节很多候选人从未系统思考过。最后讲一个最隐蔽的陷阱:当你的标签其实是另一个模型的输出时,会发生什么。一位资深分析师想用深度模型复现上游公式给出的分数,但无论上游公式是否准确,这个做法要么是浪费成本去复制一个已知答案,要么在训练目标里注入了系统性偏差,而且你根本无法评估损害有多大,因为评估集本身也存在同样的缺陷。这一结论同样适用于规则引擎、老模型和供应商的评分。
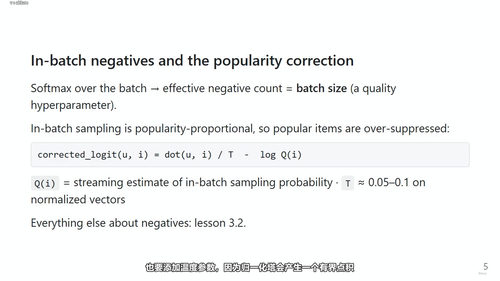
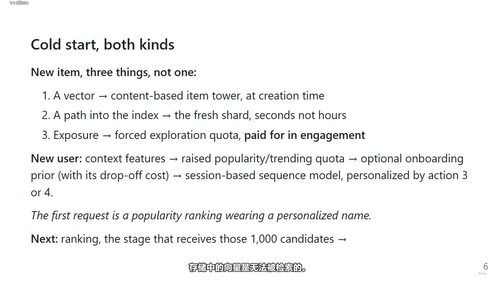
第四个模块进入召回,讲双塔模型的来龙去脉和约束条件,ANN索引的召回率旋钮,以及冷启动处理。
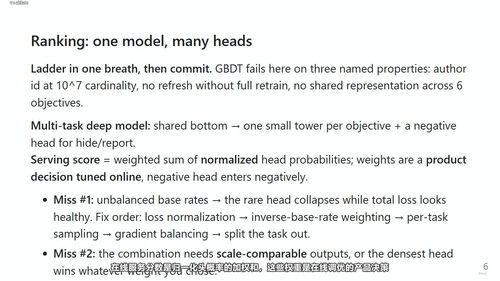
第五个模块是排序。课程沿着模型阶梯往上走,从逻辑回归到GBDT,到GBDT+LR的混合结构,再到深度模型,每一步的演进都有对应的工程背景和权衡取舍。然后讲多任务排序的共享层、各业务独立输出头和组合损失函数的设计逻辑。最后讨论特征交叉、DCN网络和校准问题——为什么AUC看着漂亮但线上效果可能完全是另一回事,这一节会带你拆开评分分布来看本质。
第六个模块讲服务和监控。批量、在线和混合推理各自的适用场景,以及它们底下那个特征存储是怎么设计的、为什么是今天推荐系统的标配。课程专门有一节讲"线下指标优秀、上线后效果平平"的诊断阶梯,教你按顺序排查问题——是特征不一致、是分布漂移、还是反馈回路在作祟。持续训练的节奏问题、新鲜度论证也都放在这一模块里讨论。
第七个模块讲指标。线下指标选择取决于分数被怎么用;线上读数要看主指标、护栏指标和领域特定业务指标,三者缺一不可。
第八个模块是案例实战。第一道题是四十五分钟完整走一遍个性化新闻信息流的设计;第二道是广告点击率预测的完整方案,并讨论四个真正决定成败的追问——标签怎么取、特征怎么补、模型怎么选、效果怎么验。还有一道题专门讲有害内容检测:当标签根本不存在的时候,你该怎么设计冷启动阶段的反馈机制。最后给出一份对照表,教你把任何题目映射到它最接近的已知家族,以后遇到新题也有思路可循。课程结尾配了两套限时模拟面试和完整评分标准。
整门课两个半小时出头,节奏紧凑,每一节都踩在面试官真正关心的问题上。如果你已经把标准流水线背得滚瓜烂熟,面试却总是过不了,那这门课就是为你准备的。它不教你更多模板,而是教你如何拆掉模板,让真正属于你的判断力长出来。学完之后,你会发现自己不再害怕新题——因为每道新题,都可以从它的独特性出发。