资源介绍
视频数量:36个
总时长:3小时51分
课程介绍:
分布式数据工程实战课:从入门到完整管道搭建
你打开招聘网站,随手搜一下"数据工程师",十家有八家的岗位要求里都写着"熟悉Apache Spark"。这并不夸张——如今企业处理的数据量早就不是Excel能应付的了,动辄TB级别的日志、交易记录、用户行为数据,都需要一个能扛住大规模计算的工具来接住。而Spark,几乎就是这个领域的事实标准。
但问题来了。很多人想学Spark,打开教程一看,第一章讲集群架构,第二章讲RDD原理,第三章讲执行计划,还没写一行代码就已经被劝退了。市面上大多数Spark课程把太多笔墨花在了底层理论上,对初学者特别不友好——你明明只想知道"怎么用它干活",却被迫先消化一堆分布式系统的概念。
这门课的做法不一样。它把理论往后挪,先让你看到结果,再回头讲为什么。一共36个视频,总时长不到4小时,节奏紧凑但不跳步,非常适合想快速上手Spark的人。
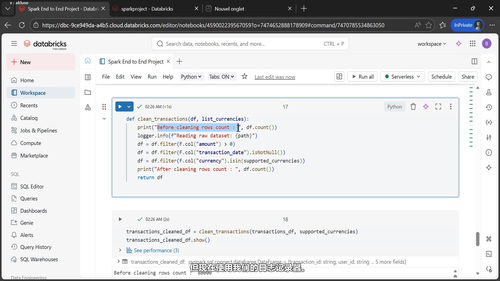
第一部分是入门引导。你会先搞清楚Spark到底和Pandas、SQL有什么不同——毕竟很多人是从Pandas转过来的,最关心的就是"我为什么要换工具"。然后课程会带你熟悉Databricks这个云端工作环境,不用自己折腾本地配置,注册个账号就能开干。
第二部分是Spark基础。这里讲的是你必须知道的概念:Spark是什么、它的架构怎么搭起来的、SparkSession和SparkContext扮演什么角色、DataFrame这个核心数据结构怎么用。听着抽象,但每个概念都会配具体的代码演示,看完你就知道这些东西在真实代码里到底长什么样、起什么作用。
第三部分是课程的核心环节——动手写代码。从创建Spark Session开始,到读取CSV文件、理解Schema和数据类型,再到筛选列、新增列、分组聚合、排序、处理空值、做表关联,最后把处理结果写出去。这一连串操作几乎是日常数据处理的全流程,学完你就能独立完成大部分数据清洗和转换的任务。课程还专门讲了Spark SQL,让你用熟悉的SQL语法操作Spark里的数据,对有数据库背景的人特别友好。
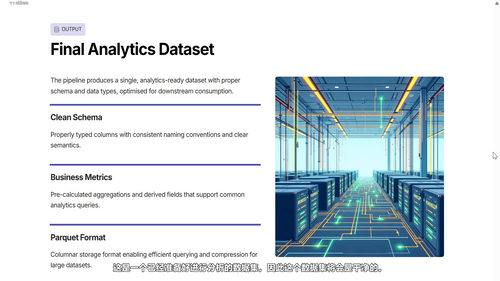
第四部分是真正出彩的地方——一个完整的真实数据工程项目。这个项目不是那种玩具级别的演示,而是有真实业务背景的数据管道搭建。你会先了解项目的业务需求,然后设计处理流程,接着读取数据,用显式定义Schema的方式避免类型推断的各种坑,然后做数据清洗和质量校验,还会学到日志记录和数据质量监控的方法。之后是数据富集、货币换算这类业务规则的实现,最后计算业务指标并产出分析数据集。整个过程走下来,你拿到的不是一个零散的脚本,而是一个有配置文件、有模块化结构、能上生产环境的项目骨架。
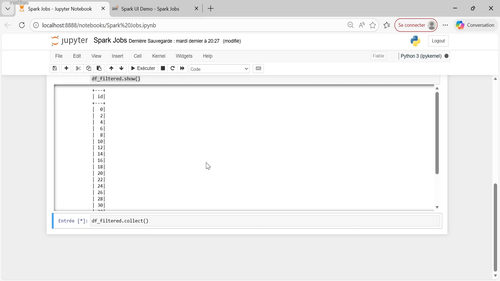
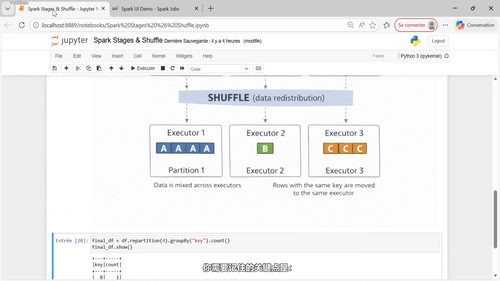
第五部分是进阶内容,讲Spark的执行模型。懒求值、转换操作和动作操作的区别、一个Spark Job从代码到执行经历了什么、Task是怎么被并行化的、Stage的划分逻辑、Narrow和Wide转换的本质区别。这些内容帮你理解"为什么我的代码跑得慢""为什么这个操作触发了Shuffle"——是性能调优的必修课,也是面试常考的重点。
最后一部分会帮你梳理学完之后的技能清单,以及下一步可以往哪个方向深入,比如流处理、Delta Lake或者Spark性能调优。
适合谁来学?如果你有Python基础,想进入数据工程领域,或者已经在用Pandas处理数据但遇到了性能瓶颈想升级工具,又或者是数据分析师想往工程方向转型,这门课都很合适。它不要求你事先懂分布式系统,也不需要Hadoop经验,PySpark的API设计本来就对Python用户很友好。
学完这门课,你能做的事情很具体:能独立搭建Spark数据处理流程,能处理GB甚至TB级别的数据,能写出结构清晰、考虑过数据质量的工程代码,能在面试中讲清楚Spark的核心机制,也能看懂Spark UI里的执行图。这些不是虚话,而是36个视频一步步带出来的真实能力。