资源介绍
视频数量:8个
总时长:1小时8分
课程介绍:
体育数据分析与可视化
凌晨四点的咖啡馆里,电视正在回放一场NFL比赛。解说员扯着嗓子喊某个四分卫的名字,弹幕里飘过一条:"他这赛季跑动距离到底排第几?"——这种问题,坐在屏幕前猜是猜不出来的,但打开Python跑几行代码,答案就在那里。
这门课说的就是这件事:怎么把一场橄榄球比赛背后那些密密麻麻的数据,变成你看得见、读得懂、能跟人聊起来的图表和结论。课程一共八个视频,总时长一小时出头,节奏紧凑,但每一节都有实实在在的代码可以跟着敲。
一、先认识你的数据:四个数据集各有分工
学数据分析的第一步,永远是先搞清楚手里拿的是什么。课程开头老师会带你对四个核心数据集做一次完整的盘点,它们全部来自NFL官方用于Kaggle大数据碗竞赛的真实数据。
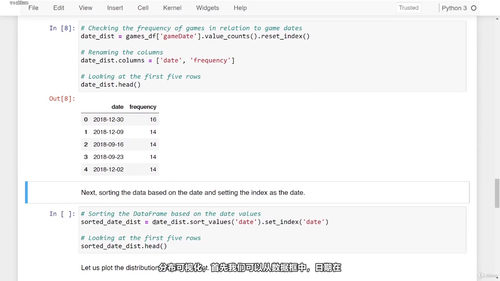
比赛数据集(games.csv)记录了2018赛季每一场比赛的基本信息,包括对阵双方、比赛日期、开球时间这些赛季级别的元数据。想要弄清季后赛对阵怎么排出来的,这个文件就是入口。
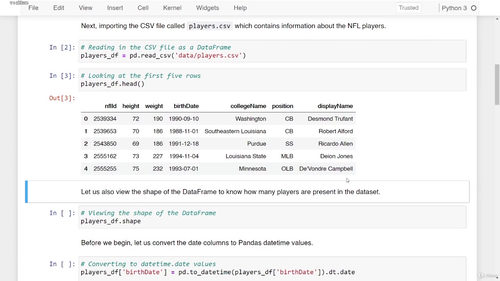
球员数据集(players.csv)保存的是球员级别的基础资料,身高、体重、出生日期、场上位置都在里面。后面要做"不同位置的球员平均身高是多少"这类对比分析,全靠它打底。
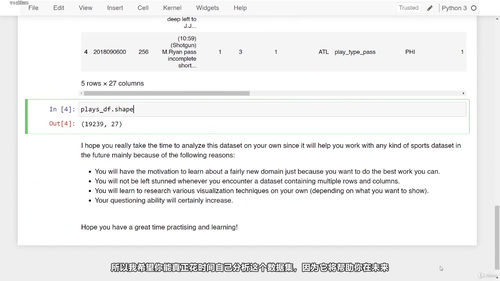
回合数据集(plays.csv)的颗粒度更细,记录了每一个回合的详细信息,包括回合类型、球员上场情况、回合最终结果等。想拆解某个战术到底打没打出来,这就是关键素材。
最后是追踪数据集(week_data.csv),也是最有意思的一份。里面是某一整周所有比赛中球员的实时追踪数据,包含球员在场上的坐标、速度、加速度。它是后面做场上可视化时的绝对主力。
二、从表格里挖故事:比赛、球员与回合
认识完数据,就到了真正动手的时候。第二章围绕前三份数据集展开,每个数据集对应一节实战课。
分析NFL比赛这一节,老师选用Jupyter Notebook作为开发环境,用其他IDE也完全没问题。课程从导入库开始:pandas处理数据帧,matplotlib的pylab模块负责画图,时间库用来处理时间字段,再配上一行matplotlib的inline魔法命令,让图表直接嵌进Notebook里。环境搭好后,用pandas的read_csv方法把比赛数据读进来,赛季的全貌就铺开了。
认识NFL球员这一节切入角度更丰富。课程提供的Notebook里,你可以从身高体重分布、位置构成、出生年份等多个角度做切片和分组统计。配套的球员位置示意图会帮你建立直观印象,知道线卫和跑卫在场上分别站在哪儿。当你把统计结果画成图表,球员的整体画像就出来了。
理解NFL比赛回合这一节往战术层面又深入了一步。通过回合数据集,你可以分析不同类型战术的使用频率、成功率、各种回合的结果差异。数据本身不会讲故事,但当你知道该按什么维度去切片、该用什么样的聚合方式,那些藏在数字背后的规律就会浮上来。
三、把球场画出来:可视化才是高潮
前面两章都在表格里做文章,第三章则是把数据直接搬到球场上。
可视化美式橄榄球场这一节,课程提供了一张球场底图。老师会教你如何在Python里加载这张图、调整坐标轴比例,让它变成一张可以往上叠数据的画布。这一步看起来简单,却是后面所有场上可视化的根基。
把球员放进球场这一节真正让人眼前一亮。追踪数据里有球员在比赛每一刻的坐标,你可以通过代码把某个回合里所有球员的真实位置标注到球场图上,用箭头表示他们的移动方向,用颜色深浅表示速度快慢。这种可视化方式比单纯看表格震撼太多——它让你能"看见"一次进攻是怎么展开的,防线是怎么被撕开的,那种沉浸感是数字给不了的。
四、收获与适合人群
课程的最后一节是一个简短收尾,老师会帮你梳理整个学习的逻辑链路,再附上一份Bonus Lecture作为补充资源。
整门课的定位很明确:纯实战,不绕弯。每一步都是打开Notebook、跑代码、看结果、调参数。学完之后你掌握的不仅是用pandas和matplotlib处理体育数据的基本流程,更是一种思维方式——拿到任何一份新的体育数据,你知道该从哪个数据集入手、该问哪些问题、该选什么图表来呈现答案。
如果你的Python和pandas有点底子,又对体育数据充满好奇,这门课刚好能把你的兴趣和技能接上。从看到比分到看懂比赛,中间差的不是天赋,就是这一小时多一点的时间。