资源介绍
视频数量:8个
总时长:13小时24分
课程介绍:
强化学习实战训练营:从基础原理到前沿应用
今年一月份,DeepSeek R1论文发布的那个晚上,整个AI圈大概都没怎么睡着。一篇论文,用了不到两个月的时间,把"强化学习"这个词从学术圈的小众话题,直接推到了所有人讨论的中心。原因也不复杂——在DeepSeek出现之前,OpenAI的o1推理模型就像一个黑箱,外界完全不知道里面装的是什么。而DeepSeek R1的横空出世,训练成本极低,性能却与o1不相上下,人们这才意识到,o1背后那套神秘的方法论,大概率就是强化学习。
也正因为这个契机,强化学习训练营这门课应运而生。主讲人是Vizuara的联合创始人之一,本科和硕士在印度理工学院马德拉斯分校完成,之后在普渡大学拿下博士学位。这门课的目标很直接:不是泛泛地讲讲概念就完事,而是真正带你把强化学习从头到尾用代码实现一遍,从最基础的智能体与环境交互,一路走到当下最热门的RLHF和GRPO。
一、强化学习的四个基本要素
训练营的第一站是所有内容的基石,讲的是强化学习中最核心的框架——智能体与环境之间的交互界面。强化学习的世界里有四个绕不开的要素:策略、奖励、价值、环境模型。策略告诉智能体在每一个状态下应该采取什么动作;奖励是环境对每一次动作的即时反馈;而价值不一样,它衡量的是从长远看这个状态有多好,不是一锤子买卖。除此之外,训练营还会引入一个满足马尔可夫性质的状态信号概念——也就是说,要预测系统未来会怎样,你只需要知道它当前的状态,过去发生了什么并不重要。这个看似简单的设定,实际上是整个强化学习理论的根基,理解了它,后面的所有算法才能顺理成章。
二、从动态规划到时序差分学习
第二讲开始,课程进入核心算法的部分。三大类方法会在这里全部登场:动态规划、蒙特卡洛方法、时序差分学习(TD Learning)。动态规划的核心思想是,如果你已经知道环境的所有规则(也就是拥有环境模型),那你可以通过贝尔曼方程反复迭代,逐步求出最优策略。但现实世界哪有这么理想?所以课程接着讲蒙特卡洛方法——不需要预演环境模型,直接让智能体在环境中跑完整个回合,用实际经历的回报来估计。折中方案是时序差分学习,它不需要等回合结束,每走一步就能更新估计,效率高得多。这三种方法构成了后续所有高级算法的底层工具箱。
三、让AI自己打游戏
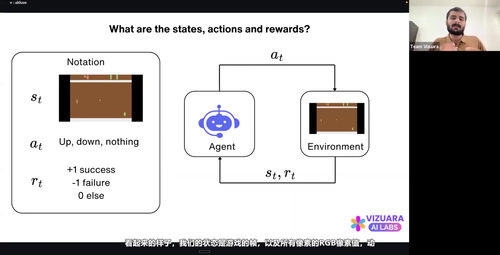
到了第三讲,画风突然变得轻松起来——我们要用强化学习训练一个能玩电子游戏的智能体。课程会从街机游戏的历史讲起,从雅达利1972年开发的第一款投币式游戏Pong开始说起,然后一步步带你搭建一个可以打游戏的强化学习系统。听着像玩闹,实际上这里面的价值非常大:游戏环境是一个完美的强化学习练手场,状态可观测、奖励可量化、回合可重复,非常适合用来检验算法是否真的有效。这一讲非常注重实践,配套的Colab Notebook可以直接打开运行,跟着代码走一遍,你会对强化学习到底是怎么"试错-优化"的有非常直观的感受。
四、策略梯度方法
第四讲开始进入策略梯度(Policy Gradient)的领域。REINFORCE算法是最经典的策略梯度方法之一,它的核心思想是:如果一个动作带来了高回报,那就增大这个动作出现的概率;如果带来了低回报,就降低它的概率。但纯粹的REINFORCE有一个明显的问题——方差太大,训练过程非常不稳定。于是课程引入了基线(Baseline)技巧和广义优势估计(GAE),前者通过减去一个参考值来降低方差,后者则巧妙地结合了不同时间尺度的优势估计,让策略更新既稳定又高效。学完这一讲,你会明白为什么现在主流的强化学习算法几乎都离不开策略梯度。
五、从零实现RLHF
第五讲是整个训练营最硬核的部分之一:RLHF(Reinforcement Learning from Human Feedback),从零开始实现。RLHF就是让大模型的行为更符合人类偏好的关键方法,也是ChatGPT之所以能跟人类对话得如此流畅的核心技术之一。课程不会调包了事,而是会带你一行一行把代码写出来,弄清楚奖励模型是怎么训练的,策略是怎么根据人类偏好进行调整的。这一讲学完,你会真正理解RLHF的每一个细节,而不是停留在概念层面。
六、用OpenRLHF训练Reddit摘要生成器
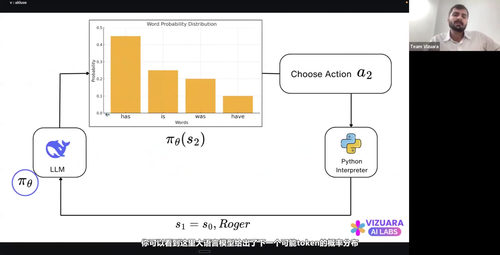
第六讲把第五讲的内容落地到一个具体的项目上:用OpenRLHF框架训练一个Reddit帖子摘要生成器。OpenRLHF是目前开源社区中比较成熟的RLHF实现库,性能不错,代码也相对清晰。课程会带着你把整个流程跑通——从数据准备、奖励模型训练到最终的PPO优化,让模型学会生成更优质的摘要。这个项目完成后,你对RLHF的工程实践会有非常具体的理解,知道从论文到代码到底有多远。
七、GRPO:当下最前沿的策略优化算法
第七讲讲的是Group Relative Policy Optimization,也就是GRPO。这个算法在DeepSeek R1的训练中扮演了关键角色,也是当下学术圈讨论最热烈的方法之一。GRPO的巧妙之处在于,它不需要单独训练一个价值模型(Critic),而是直接通过同一批次内的样本相互比较来估计优势,这大大降低了显存开销和工程复杂度。课程会带你剖析GRPO的数学原理,对比它和传统PPO的差异,并通过实验让你看到它在实际任务中的表现。
八、强化学习驱动的智能体RAG系统
最后一讲把强化学习用到了一个全新的场景:Agentic RAG(智能体检索增强生成)。传统的RAG系统是固定的流程——检索、生成、走人。但如果给RAG系统装上一个强化学习智能体,让它自己决定什么时候检索、检索什么内容、怎么整合答案,整个系统的灵活性会大幅提升。课程会展示如何用强化学习训练一个具备自主决策能力的RAG智能体,这既是强化学习的应用拓展,也是当下LLM领域非常热门的方向。
适合谁来学
这门课不是给完全零基础的人准备的,但你也不需要是强化学习博士。你需要掌握Python编程的基本功,对深度学习有初步了解(比如知道什么是神经网络、能跑通简单的训练流程),最好接触过PyTorch。如果你是想真正搞懂RLHF、GRPO这些前沿方法到底怎么工作的工程师或研究者,这门课的密度和深度都恰到好处。配套资源也很扎实——除了八讲视频课程,还有完整的代码仓库、可在线运行的Colab Notebook、可视化的Miro白板讲义,以及一本专门的强化学习教材。
八讲学完,你会拥有从理论到代码的完整强化学习能力栈,不再是看了几篇博客就以为自己懂了的状态,而是真正能动手实现、能调试改进、能迁移到新场景的水平。在这个强化学习重新成为焦点的时代,把这件事真正搞透,迟早会用得上。