资源介绍
视频数量:81个
总时长:10小时59分
课程介绍:
数据科学基础:Python编程、统计分析与探索性数据分析实战
想象一下,领导甩给你一个CSV文件,一万条记录,二十个特征,密密麻麻全是数字,盯着看半天却什么也看不出来。这大概是很多想转行数据科学的人第一次面对真实数据的场景——工具装了一堆,网课收藏了无数,真到要用的时候却发现基础没打牢,根本无从下手。
这门课要解决的就是"基础不牢"的问题。十一个小时,八十一节课,从Python语法一路讲到完整的探索性数据分析项目,覆盖数据科学最核心的几块拼图。
一、Python编程:把地基打扎实
很多初学者上来就跟着敲机器学习代码,变量是什么说不清楚,循环和函数的区别也模模糊糊。这门课用十七节课把Python底子讲透,从安装和环境配置开始,到变量、循环、数据结构、模块导入、方法、错误处理、面向对象编程,这些基础一个不落。
但课程没有停在入门阶段——文件读写、多进程、异步编程、列表推导式、装饰器与生成器、Lambda函数、Map/Filter/Reduce、虚拟环境搭建,这些进阶内容也全部覆盖。真实的数据科学项目不会只用print和for循环,你要处理GB级别的日志文件、跑并行任务加速数据处理、搭建干净的虚拟环境让项目不互相冲突。学完这部分,你能看懂GitHub上绝大多数开源数据科学项目的代码结构,也能自己写出像样的工具函数和模块。
二、数学基础:向量、导数与梯度
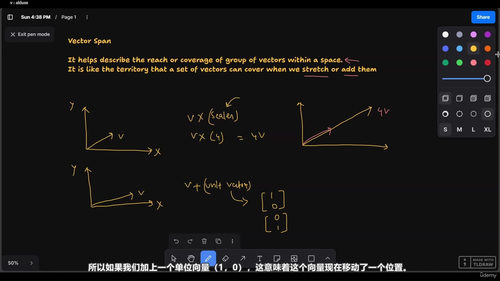
十节课专门讲机器学习所需的数学,但讲法很接地气。从向量讲起:什么是向量、向量有哪些类型、怎么相加、什么是向量张成、怎么相乘。讲到第六节直接拿房价数据集串起来,用向量表示面积、卧室数、地段这些特征,让你直观感受向量在数据里到底长什么样。
然后是微积分,从导数到偏导数再到梯度,最后讲链式法则。梯度下降是几乎所有模型训练的引擎,搞清楚偏导数和梯度的含义,后面学任何深度学习模型都会轻松很多。课程不堆公式吓人,用图示和直觉带你理解每个概念。
三、统计学:从描述到推断
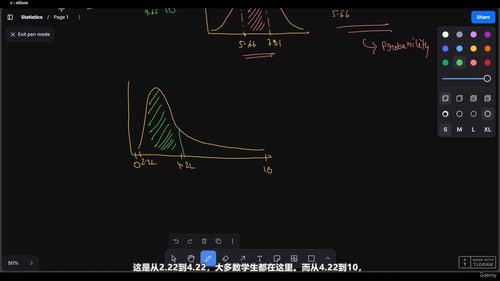
十七节统计课覆盖数据科学中最常用的知识点。先讲测量层次、均值中位数众数这些描述统计,再讲概率分布函数、概率质量函数、概率密度函数,把离散和连续随机变量的工具分清楚。然后是钟形曲线、Z分数、非高斯分布、二项分布和泊松分布——这些分布在建模时常常碰到,理解它们的适用场景比记公式更重要。
进阶部分讲中心极限定理——为什么样本均值的分布会趋向正态,这是统计推断的基石。然后是置信区间、假设检验、T检验和方差分析。学完这些,你不仅能看懂论文里的统计部分,还能在自己的项目里设计合理的验证方案,判断两个模型的差异到底是不是随机的。
四、数据可视化:让数据自己说话
十一节课从为什么要做可视化讲起,再到真实数据集上操练。从项目环境搭建,到柱状图、从Kaggle下载数据,再到直方图、核密度估计图、散点图、Pairplot、条形图,最后用计数图展示分类数据,并在最后一节课用可视化在完整数据集里寻找规律。
这一部分的核心不是matplotlib的API怎么调,而是培养一双"看图找规律"的眼睛。什么时候该用直方图看分布,什么时候用散点图看关系,什么时候用柱状图做对比,这些都是数据科学家每天都在做的判断。
五、特征工程:数据喂给模型前的最后加工
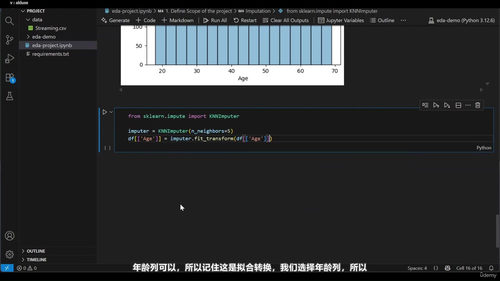
机器学习圈有一句老话:数据和特征决定了上限,模型只是在逼近这个上限。课程用十二节课把特征工程讲透。从标准化的数学原理讲起,对比归一化的差异,再讲Ordinal Encoding和One-Hot Encoding两种处理类别变量的方法。然后是变量变换、混合变量处理、缺失值处理(KNN填充和MICE填充两种高级方法)、异常值检测,最后是特征构造。
什么时候该标准化、什么时候该归一化?类别变量用独热编码还是标签编码?缺失值用均值填充会不会引入偏差?异常值该删掉还是该单独建模处理?这些实操中最容易纠结的问题,课程里都给出了清晰的答案。
六、探索性数据分析:完整项目串联
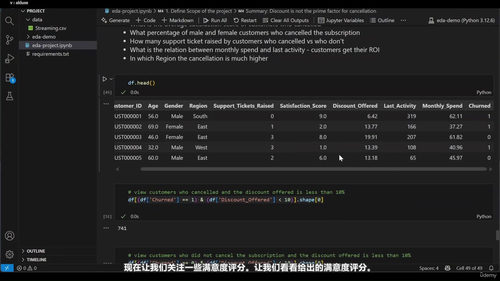
最后是EDA实战,也是整门课的集大成之作。在流媒体用户数据集上完整走一遍流程:探索数据集结构、修改数据类型、对离散特征做填充、数据清洗、检测异常值、做数据分析、应用特征工程。最后专门讲数据泄露——这是新手最容易犯的错误,也是模型效果看着好但线上崩盘最常见的原因。
课程附带完整的源代码和数据集,你可以跟着老师一步步敲,也可以自己改参数、换思路,把前面学到的知识真正揉进手里。
这门课适合谁?
如果你会一点Python但数学统计基础薄弱,如果你自学了一阵机器学习但连一个完整的分析流程都跑不下来,如果你想转行数据科学却不知道该按什么顺序补基础——这门课就是为你设计的。
学完之后你能独立完成一个数据科学项目的初步分析,能用Python写出干净可维护的代码,能看懂统计检验的结果并做出合理判断,能用可视化讲出数据背后的故事,能把脏数据加工成模型可以吃的特征。剩下的,就是到真实项目里反复打磨了。