资源介绍
视频数量:5个
总时长:1小时4分
课程介绍:
超参数调优提速课:用多保真度模型告别漫长等待
想象一下这个场景:你精心准备了一个机器学习模型,数据清洗完了,特征工程也做了,现在就差调一组好超参数。但当你启动网格搜索或者贝叶斯优化,看着训练一轮接一轮地跑,日志一行行地刷,时间一小时一小时地过去——最终得到的可能还不是最优的那组参数。超参数调优这件事,几乎是每个做机器学习的人都会遇到的痛点。
这门课要解决的就是这个痛点。课程围绕多保真度优化展开,核心思路是:与其花大量时间去训练完整的高保真度模型,不如先用大量廉价快速但粗糙的模型做广泛探索,再把预算集中在少数有潜力的配置上。这就像招聘时先用简历筛选大量候选人,再对入围者安排多轮面试——把时间花在最值得的地方。
一、为什么需要多保真度优化
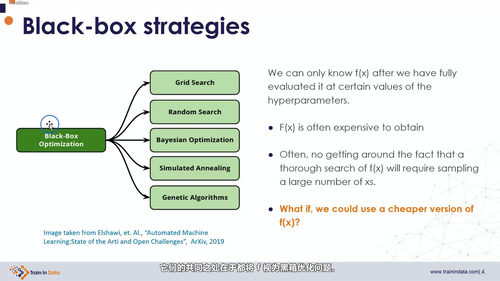
在进入具体算法之前,课程先梳理了超参数搜索的两类经典策略。随机搜索需要大量并行计算资源,贝叶斯优化则是一个接一个串行训练,两者在高维空间中都会面临评估次数指数级增长的问题。当模型本身就很复杂的时候,传统的调参方式几乎不可能在合理时间内找到全局最优。这里要特别注意的是,超参数空间中的目标函数其实是一个黑盒,我们并不知道它的真实形状,更别提全局最小值到底藏在哪里了。
更重要的是,实际工作中有时间预算的限制——没人愿意等三天只为调一组参数。多保真度优化的提出,正是为了在有限时间内找到尽可能好的超参数组合。
二、逐次减半的核心思想
课程详细讲解的第一个算法是逐次减半(Successive Halving)。它的做法非常直观:
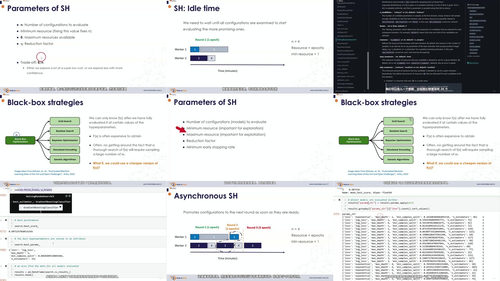
假设你有两组超参数,每组各有四个取值,组合起来一共十六种配置。第一轮,十六种配置全部用最低训练预算跑一遍——比如只训练少量迭代次数,或者随机森林里只使用少量估计器。这一步成本极低,但能快速筛掉明显不靠谱的配置。
接着,保留表现最好的前一半配置,进入第二轮。第二轮的预算翻倍——训练更多迭代或者更多估计器,模型的保真度也随之提升。再保留前一半,进入第三轮。如此反复,直到剩下最后一个最优配置。
整个过程就像一场锦标赛:第一轮大浪淘沙,后面轮次预算越来越高,竞争的精度也越来越高。最终胜出的那组配置,已经在多个预算层级下证明了自己的实力。课程中还会给出演示代码,让你看到逐次减半具体是怎么跑起来的。
三、Hyperband:自适应版本的逐次减半
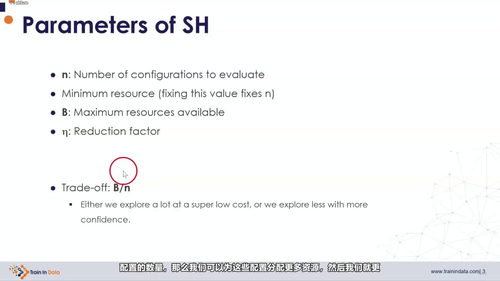
逐次减半有一个需要提前设定的参数:初始预算大小。设得太小,第一轮筛不掉好配置;设得太大,前几轮浪费太多资源。
Hyperband解决了这个问题。它通过多次运行逐次减半,每次用不同的初始预算,形成一个嵌套式的资源分配结构。课程会讲清楚Hyperband的逻辑,以及它相比固定预算的逐次减半在哪些场景下更有优势。
四、异步逐次减半:释放并行潜力
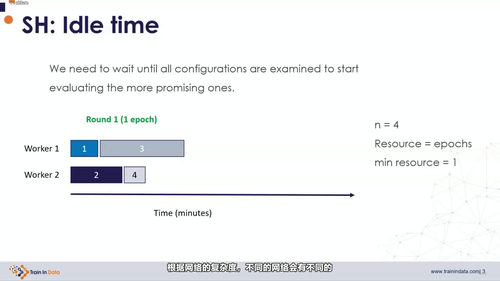
前面讲的算法都是同步的——每一轮必须等所有配置跑完才能开始下一轮。但实际中你手里有八张GPU,难道要让七张空等一张跑完吗?
异步逐次减半(ASHA)打破了这一限制。任何配置一旦完成了当前轮次的评估,就可以立刻晋升到下一轮,无需等其他配置跑完。这种方式在多机多卡的集群环境下能把硬件利用率拉满,是工业界实际部署时最常用的变体。
五、Optuna实战演示
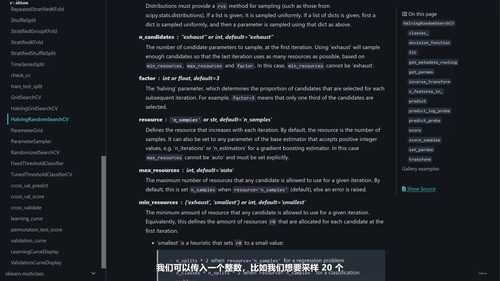
理论讲完,课程给出了具体的代码演示。Optuna是目前最主流的超参数优化框架之一,对多保真度优化有完善的支持。通过案例,你能看清楚怎么在几行代码里启用逐次减半或者Hyperband,怎么定义预算,怎么在评估中途剪掉表现差的试验。
适合谁来学
这门课适合已经会用Python和主流机器学习库训练模型,并且对超参数搜索有基本了解的从业者。如果你曾经在网格搜索、随机搜索或者贝叶斯优化上花费过大量时间,并且想找到更高效的方案,这门课会很对胃口。课程时长一小时出头,内容精炼不拖沓,适合周末抽空集中学完。
学完之后,你能掌握多保真度优化的核心算法原理,知道什么时候用逐次减半、什么时候用Hyperband或异步版本,并且能直接在Optuna里落地实现。在模型越来越复杂、算力越来越贵的当下,这套方法能让你的调参工作从"靠运气等结果"变成"有策略地分配资源"。